
高等数学 / 系统课时
梯度消失
梯度消失
本课解释深层网络训练时“前层几乎不更新”的原因。你将把链式法则展开为局部导数连乘,观察梯度如何随深度快速衰减,并掌握定位与缓解梯度消失的实用方法。
学习目标
- 用链式法则解释梯度逐层衰减的机制
- 识别激活函数、初始化与网络深度带来的风险
- 通过梯度范数和激活分布定位问题
梯度为何逐层变小
设网络逐层计算 ,损失为 。若隐藏状态是标量,反向传播到第 层时可连乘后续各层的局部导数。
对向量状态,令 为第 层对输入的雅可比,梯度按列向量写时每步是 。若相关路径上每层的算子范数都不超过某个 ,梯度范数至多按 衰减。这是充分条件;若某层有大于 的伸缩方向,实际回传梯度仍可能落在被压缩的方向。
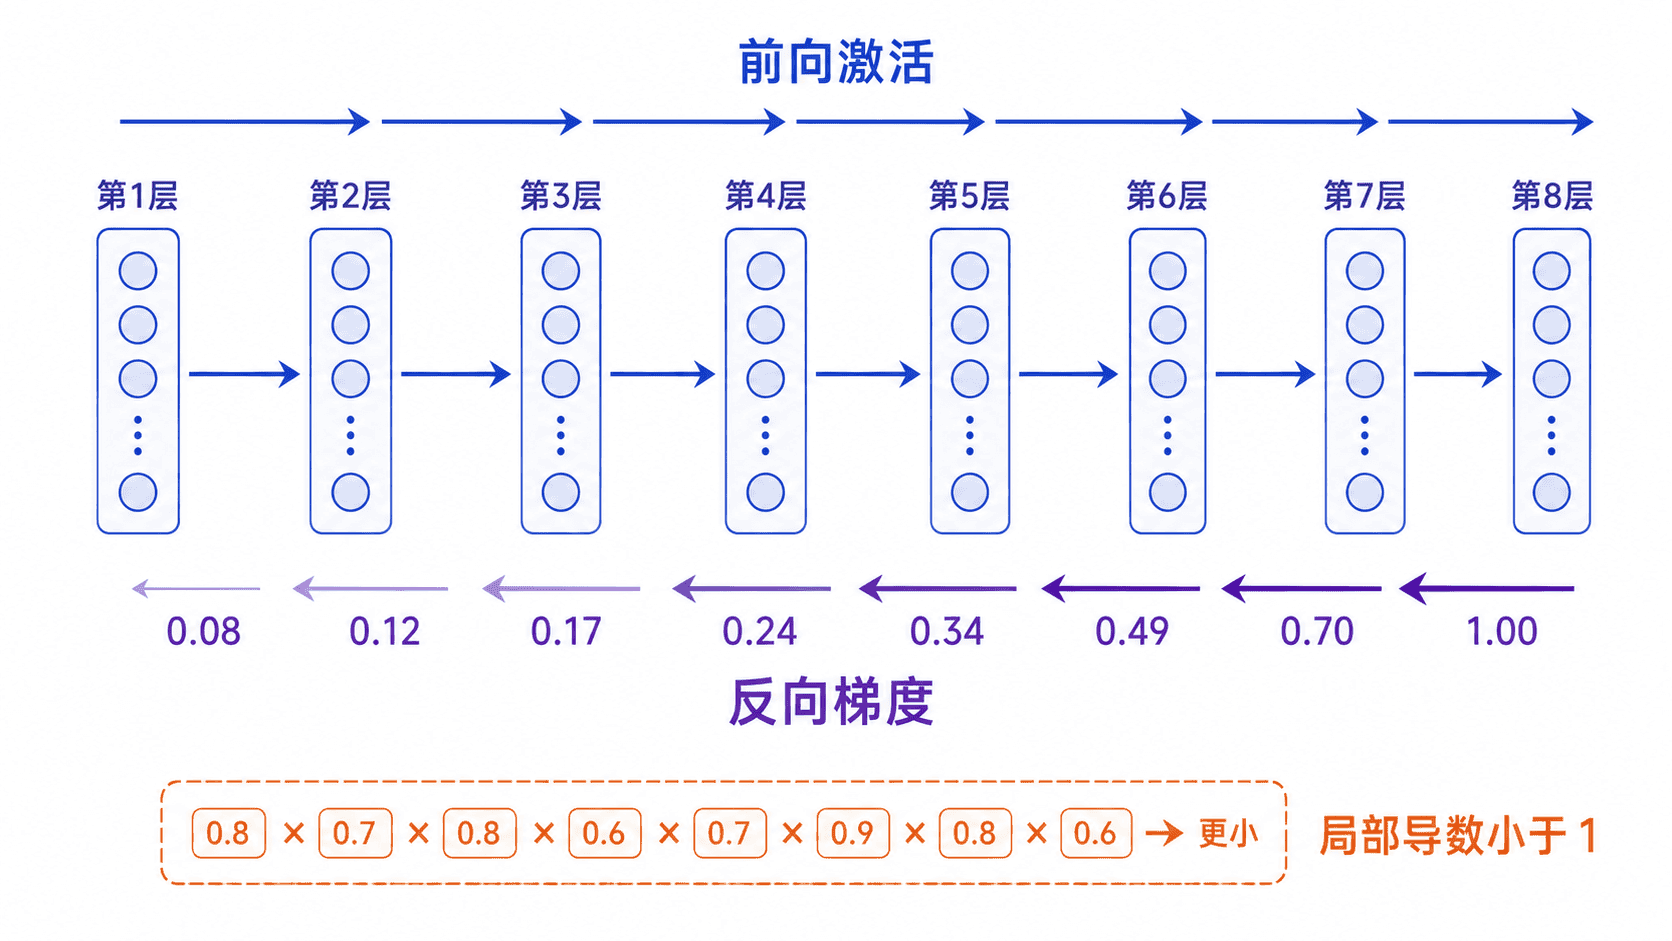
这不是“梯度突然消失”,而是许多次乘法累积后的结果。只看最后一层梯度正常,并不能证明前面各层也能获得有效更新。
用数值观察连乘效应
下面用标量局部导数模拟反向传播。每层导数固定为 0.25,经过 12 层后,梯度已缩小到约 。
def main() -> None:
    gradient = 1.0
    local_derivative = 0.25
    checkpoints = {1, 4, 8, 12}

    # 每经过一层,就乘一次局部导数,模拟反向传播。
    for layer in range(1, 13):
        gradient *= local_derivative
        if layer in checkpoints:
            print(f"经过 {layer:2d} 层: {gradient:.3e}")

if __name__ == "__main__":
    main()
预期输出:
经过  1 层: 2.500e-01
经过  4 层: 3.906e-03
经过  8 层: 1.526e-05
经过 12 层: 5.960e-08
例如每层的雅可比都是对角矩阵 ,沿第一坐标的梯度每层放大两倍,沿第二坐标的梯度每层缩小到十分之一。只看一个矩阵范数无法确定当前梯度的变化。
常见触发条件
sigmoid 和 tanh 在输入绝对值较大时进入饱和区,导数接近 0。网络越深,饱和导数连乘的影响越明显。循环神经网络还会沿时间步重复使用相似变换,因此长序列特别容易出现梯度消失。
权重初始化过小也会持续压缩信号。若前向激活很快集中到狭窄区间,反向梯度通常也会同步变弱。即使使用 ReLU,若大量神经元长期输出 0,仍可能出现局部无梯度,但这更准确地称为“死亡 ReLU”。
按层定位问题
排查时不要只观察总损失,应同时记录各层参数梯度的范数。若从输出层向输入层呈持续、数量级式下降,通常就是梯度消失。还应检查激活值是否大量落在 sigmoid、tanh 的饱和区,或集中为几乎相同的数。建议按以下顺序定位:
- 检查参数是否需要梯度、是否参与了损失,以及是否出现
detach或转换为整数等断开梯度的操作。PyTorch 参数的grad is None与梯度张量全零应分别排查。 - 比较各层梯度范数,找出从哪一层开始明显衰减。
- 查看激活分布与权重分布,判断是否饱和或初始化尺度不合适。
- 缩短网络或时间展开长度做对照,验证问题是否随深度加重。
梯度恒为 0 不一定属于数值衰减,也可能是分支未参与损失、参数被冻结或计算图断开,因此必须先排除结构性原因。
缓解方法与边界
前馈网络可选择适合任务的激活与初始化,例如在 ReLU 网络中用 He 初始化。ReLU 的正区间不饱和,但负区间梯度为零;GELU 的负端也可接近饱和。残差连接为梯度提供更短路径,归一化层则有助于控制激活分布,这些方法通常需要组合使用。
循环任务可采用 LSTM、GRU 等门控结构提供较长的梯度路径。截断反向传播能限制每次传播长度,但也会切断超过截断窗口的梯度信号。梯度裁剪主要用于限制梯度爆炸,并不能把已经接近 0 的梯度放大,因此不是解决梯度消失的核心手段。