
高等数学 / 系统课时
梯度下降
梯度下降
梯度下降解决的是“如何仅凭当前位置的导数,逐步找到较小函数值”的问题。本课从局部最速下降方向推出更新公式,并用一个可运行示例观察参数怎样沿迭代轨迹逼近极小点。
学习目标
- 说明负梯度为何是局部最速下降方向
- 写出梯度下降的标准更新公式
- 根据损失值和梯度变化判断迭代是否收敛
从最速下降方向得到更新公式
设目标函数为 。在当前位置附近取一个很小的位移 ,一阶近似为:
在梯度非零且欧氏位移长度固定时,内积在 与梯度方向相反时最小,因此局部下降最快的方向是 。把步长记为学习率 ,便得到更新公式:
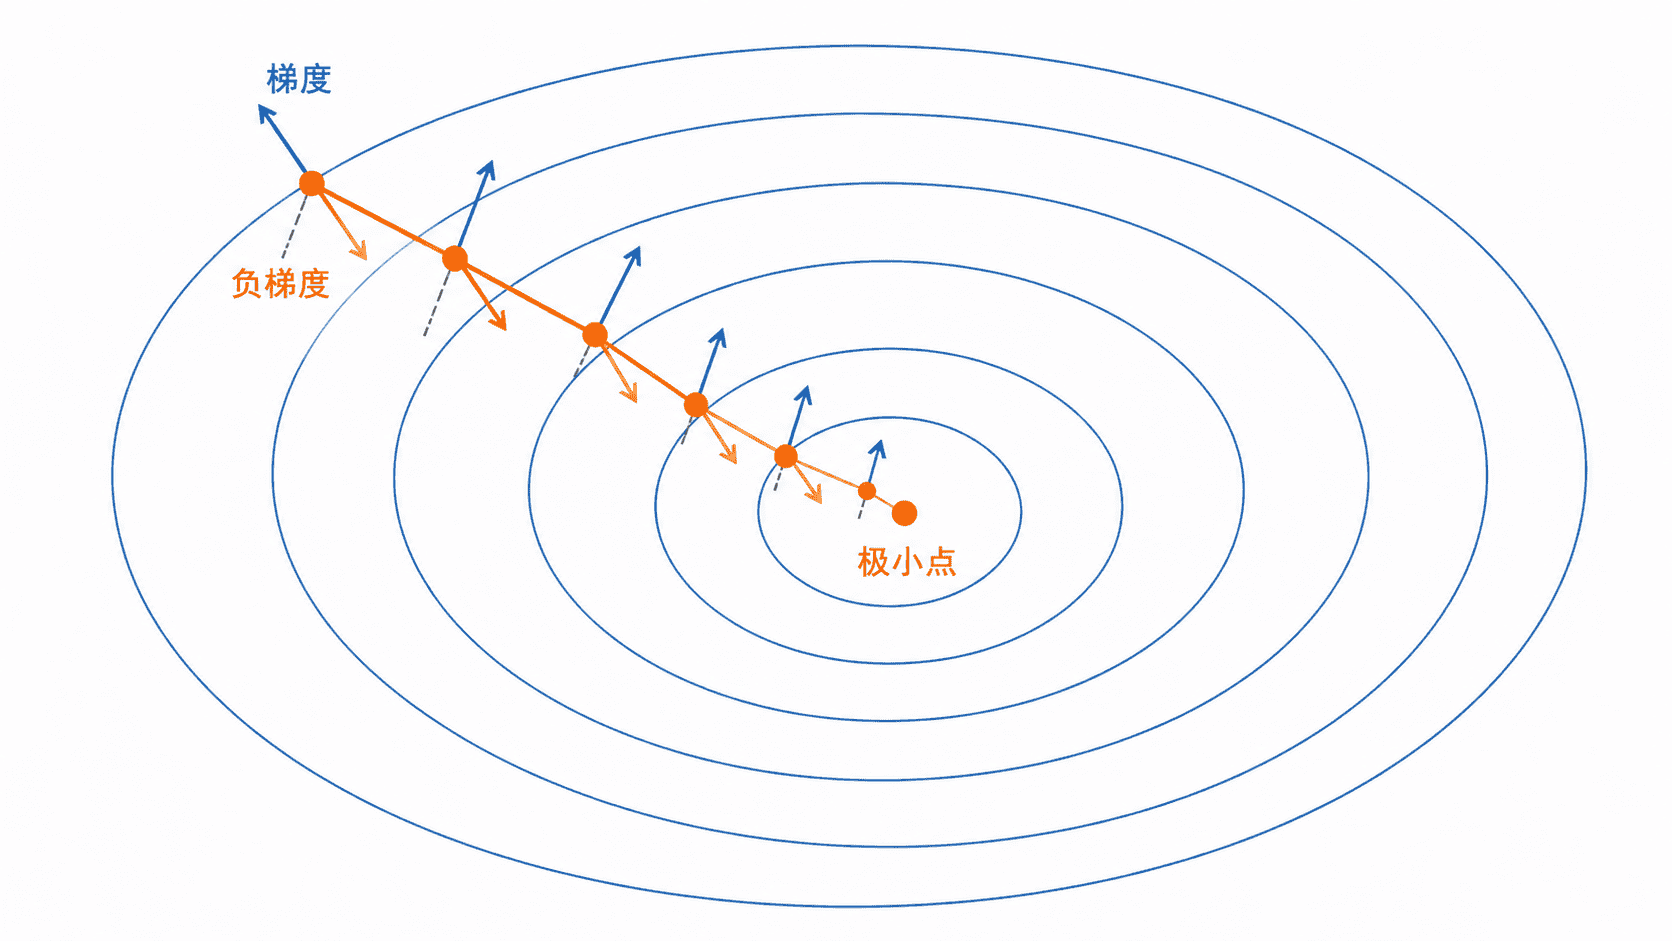
负梯度提供一阶下降方向,取足够小的正步长时,实际函数值也下降。固定的较大步长可能越过局部近似有效范围。梯度为零时,普通梯度下降在该点不更新。
一次迭代包含什么
每轮迭代先计算当前位置的目标函数值和梯度,再按更新公式移动参数。随后重新计算新位置的信息,直到损失变化、梯度范数或迭代次数满足停止条件。
对于多维参数,梯度是由各偏导数组成的向量。所有分量在同一轮同时更新,而不是先改一个参数,再用修改后的值计算另一个参数。
可运行示例
下面用纯 Python 最小化 。它的梯度为 ,极小点位于 。
python
def loss(x: float) -> float:
    return (x - 3.0) ** 2

def gradient(x: float) -> float:
    return 2.0 * (x - 3.0)

x = 9.0
learning_rate = 0.2

for step in range(1, 7):
    # 使用当前梯度更新参数,再观察新位置的损失
    x -= learning_rate * gradient(x)
    print(f"step={step}, x={x:.6f}, loss={loss(x):.6f}")
预期输出
text
step=1, x=6.600000, loss=12.960000
step=2, x=5.160000, loss=4.665600
step=3, x=4.296000, loss=1.679616
step=4, x=3.777600, loss=0.604662
step=5, x=3.466560, loss=0.217678
step=6, x=3.279936, loss=0.078364用递推式核对,,因此每步把误差乘以 ,把损失乘以 。第六步的损失仍约为 。
收敛判断与常见边界
工程中通常组合使用多个停止条件,例如梯度范数小于阈值、连续若干轮损失改善很小,或达到最大迭代次数。只看损失下降一次,不能证明已经收敛。
非凸函数可能存在多个局部极小点、鞍点和平坦区域,因此不同初始值可能得到不同结果。梯度下降也不保证每一步都下降;学习率过大时,参数可能越过低点并产生振荡甚至发散。
按自己的节奏,确认真正理解。