
高等数学 / 系统课时
前向模式自动微分
前向模式自动微分
前向模式自动微分沿程序的实际计算顺序,同时传播每个中间量的数值与导数。本课用一个可运行的双数示例说明其执行机制,并判断它为什么更适合输入维度较小、输出数量较多的计算任务。
学习目标
- 理解“数值—切向量”成对传播的含义
- 掌握前向模式计算雅可比向量积的过程
- 判断前向模式适合的输入输出规模
核心机制:值与导数同步前进
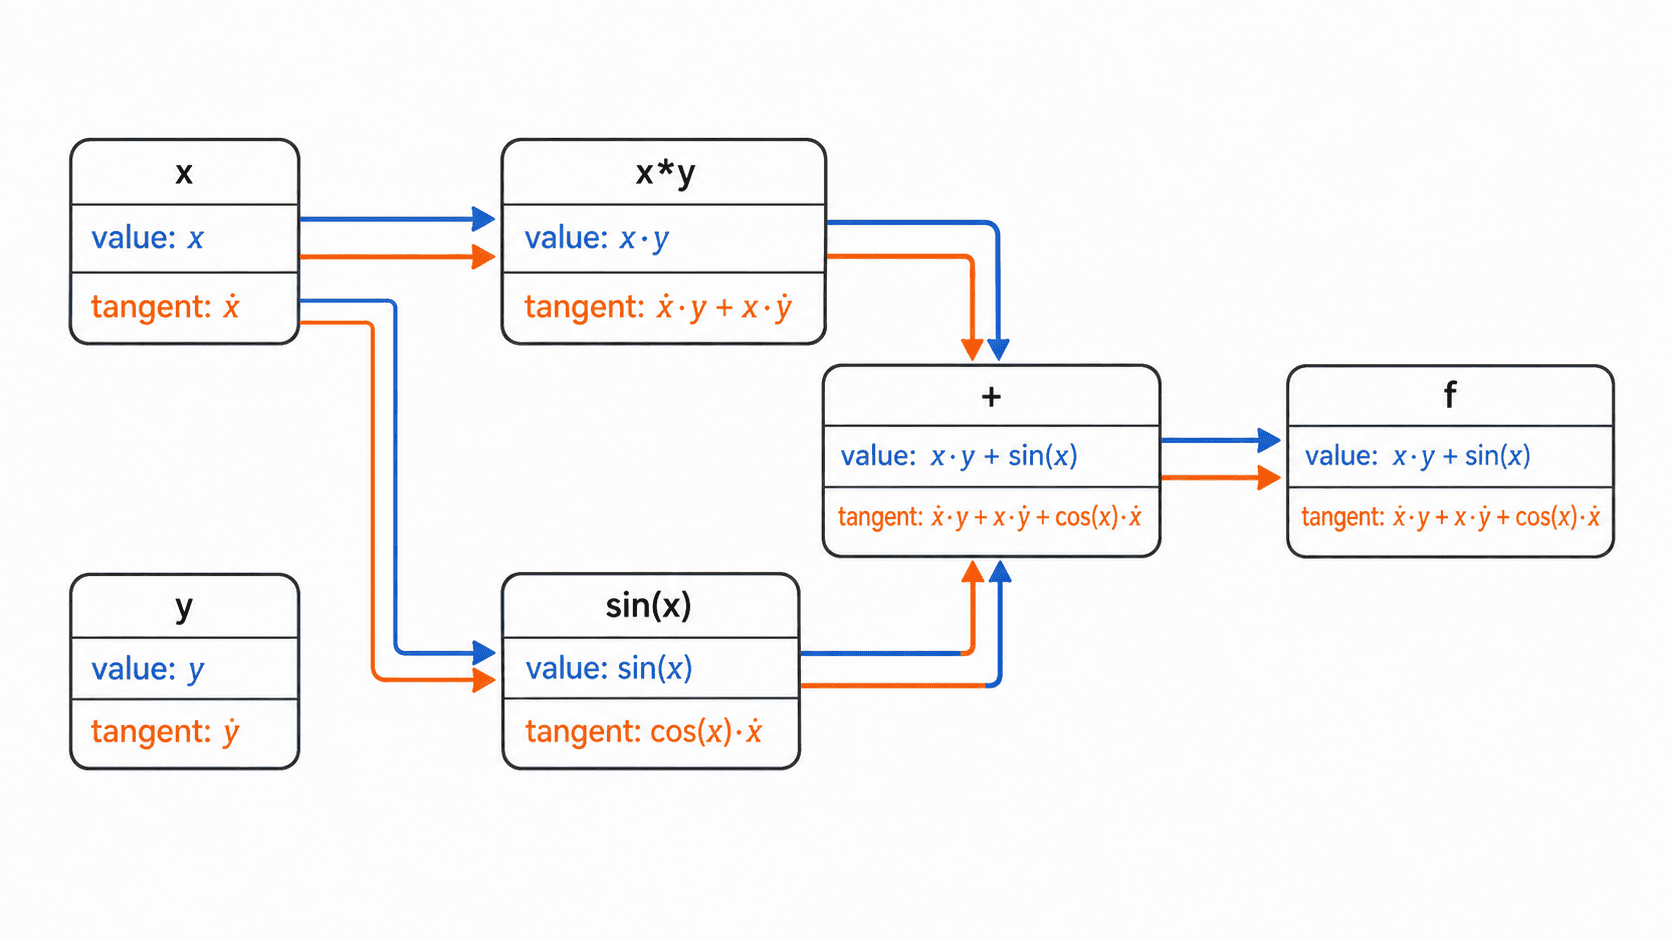
设变量 的当前值为 ,沿某个输入方向的变化率为 。前向模式把它表示为二元组 。程序执行普通运算时,不仅计算新值,也按链式法则立即计算新导数。
若中间量满足 ,传播规则为:
自动微分不需要先把整个函数化成符号表达式,也不是用微小扰动近似导数。它直接复用程序中的每一步运算,对可微运算按链式法则求导,避免有限差分的步长与截断误差。数值计算仍可能受舍入、上溢、下溢和数值消去影响。
对向量函数 ,给输入种子方向 后,一次前向传播得到 。若把第 个标准基向量作为种子,就得到雅可比矩阵的第 列;求完整雅可比通常需要按输入维度重复传播。
以 为例。求关于 的偏导时设置 ;求关于 的偏导时设置 。两次计算使用相同表达式,只改变输入种子。
用双数完成一次前向传播
下面的 Dual 同时保存 value 和 tangent。乘法、加法与正弦运算都按链式法则返回新的双数,因此表达式写法与普通数值计算基本一致。
import math

class Dual:
    def __init__(self, value: float, tangent: float = 0.0):
        self.value = value
        self.tangent = tangent

    def __add__(self, other: "Dual") -> "Dual":
        return Dual(
            self.value + other.value,
            self.tangent + other.tangent,
        )

    def __mul__(self, other: "Dual") -> "Dual":
        # 乘法法则:(uv)' = u'v + uv'
        return Dual(
            self.value * other.value,
            self.tangent * other.value + self.value * other.tangent,
        )

    def sin(self) -> "Dual":
        # 正弦节点同步传播局部导数
        return Dual(
            math.sin(self.value),
            math.cos(self.value) * self.tangent,
        )

def function(x: Dual, y: Dual) -> Dual:
    return x * y + x.sin()

def derivative(seed_x: float, seed_y: float) -> Dual:
    x = Dual(2.0, seed_x)
    y = Dual(3.0, seed_y)
    return function(x, y)

if __name__ == "__main__":
    dx = derivative(1.0, 0.0)
    dy = derivative(0.0, 1.0)

    print(f"f(2, 3) = {dx.value:.6f}")
    print(f"df/dx = {dx.tangent:.6f}")
    print(f"df/dy = {dy.tangent:.6f}")
预期输出:
f(2, 3) = 6.909297
df/dx = 2.583853
df/dy = 2.000000
结果与解析导数 、 一致。这里没有使用有限差分,因此不存在步长选择造成的截断误差,不过,中间运算和梯度计算仍采用有限精度。
适用规模与关键边界
前向模式的单次成本通常与一次原函数计算同阶,但一次只传播一个输入方向。当输入维度 很小而输出维度 很大时,少量传播就能获得需要的导数,常见于参数较少的物理模型、灵敏度分析和雅可比向量积计算。
若模型有数百万个参数、最终只产生一个标量损失,逐个输入方向传播会非常昂贵。此时反向模式能从一个输出出发,一次得到所有输入梯度,通常更合适。
前向模式中的“前向”指导数信息按计算顺序传播,不等同于神经网络只执行普通前向推理。种子也不必是标准基向量;给定任意方向 ,一次传播就能得到 。如果 不是单位向量,它表示沿参数化路径 对 的导数。