
高等数学 / 系统课时
L2正则化
L2正则化
L2 正则化对参数幅度施加平方惩罚,让优化在拟合数据和控制参数范数之间折中。本课从目标函数、梯度更新和几何直觉出发,说明它为什么会持续缩小权重,以及它与权重衰减的关系。
学习目标
- 写出带 L2 惩罚项的目标函数与梯度
- 解释 L2 正则化为什么能抑制参数过大
- 用一个可运行示例观察权重收缩效果
从原始损失到正则化目标
设模型参数为向量 ,原始经验损失为 。加入 L2 正则化后,优化目标通常写成:
其中, 控制正则化强度,。前半部分要求模型拟合训练数据,后半部分要求参数不要过大。 越大,模型越偏向较小的权重,但过大时也可能造成欠拟合。
平方惩罚对大参数增长很快。例如参数从 增加到 时,惩罚从 变为 ;从 增加到 时,惩罚又变为 。因此,优化器会更主动地压制绝对值很大的权重。
梯度形式与权重收缩
对正则项求梯度可得:
于是总梯度为:
使用学习率 做梯度下降时:
整理后得到:
当 时, 把旧参数按比例缩小且保持符号,数据梯度项随后与它相加。数据梯度可能让某个权重的绝对值增大,完整更新需要看两项的合力。只看惩罚项时, 会交替变号但仍衰减, 则使绝对值增长。
注意:对这里无动量的 SGD 更新,把 L2 梯度加到数据梯度与直接乘权重衰减因子是同一个式子。Adam 会按自适应规则处理合成梯度,AdamW 则把权重衰减作为单独步骤,两者一般得到不同的更新。
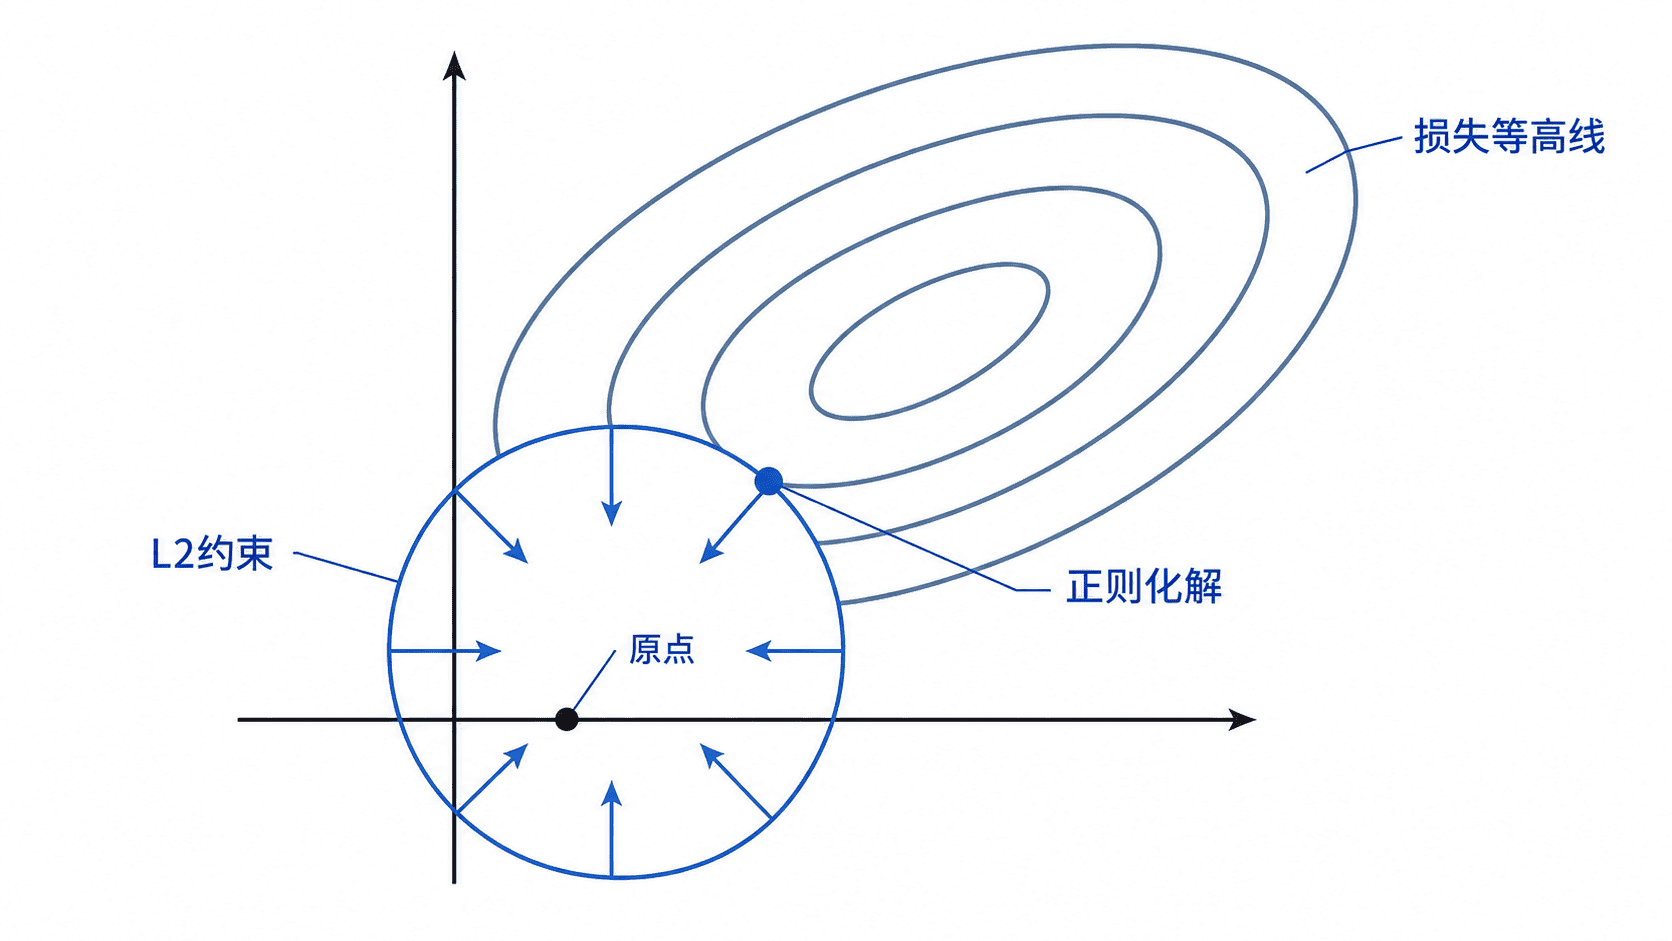
一个最小数值示例
下面只优化 L2 惩罚项,不加入数据损失。这样可以直接观察权重在每一步按固定比例缩小。
import numpy as np

weights = np.array([3.0, -4.0])
learning_rate = 0.1
regularization = 0.2

for step in range(3):
    # L2 正则项的梯度为 lambda * weights
    gradient = regularization * weights
    weights = weights - learning_rate * gradient
    print(f"step={step + 1}, weights={weights.round(6)}")

np.testing.assert_allclose(weights, np.array([3.0, -4.0]) * 0.98**3)
预期输出
step=1, weights=[ 2.94 -3.92]
step=2, weights=[ 2.8812 -3.8416]
step=3, weights=[ 2.823576 -3.764768]
每一步都乘以 ,因此正负权重都会向零靠近,但通常不会在有限步内直接变成零。这也是 L2 正则化产生“小而密集”参数,而非稀疏参数的重要原因。
加入数据损失后,最优权重通常还要拟合数据。例如 ,加入 后令导数为零,可得 。当 时,最优权重从 缩到 。
如何选择正则化强度
时,训练过程不受 L2 惩罚影响; 较小时,主要作用是抑制极端权重,泛化是否改善需看验证结果; 过大时,参数被强烈压缩,模型可能无法表达数据中的有效规律。
实际训练中应在验证集上比较多个候选值,并同时观察训练损失与验证损失。若训练损失很低但验证损失明显更高,可适当增大 ;若训练和验证表现都差,则应警惕正则化过强。
偏置项是否正则化要看模型与框架约定。常见做法是不对偏置和归一化层参数施加权重衰减,因为它们通常不承担相同的复杂度控制作用。