
高等数学 / 系统课时
梯度爆炸
梯度爆炸
本课解释深层计算中导数连乘为何会让梯度快速增大,并给出可运行示例观察增长速度、计算全局梯度范数,以及用梯度裁剪限制单次更新幅度。
学习目标
- 说明局部导数连乘导致梯度指数增长的条件
- 识别训练日志中梯度爆炸的典型信号
- 正确理解梯度裁剪的公式、位置与局限
为什么梯度会快速增大
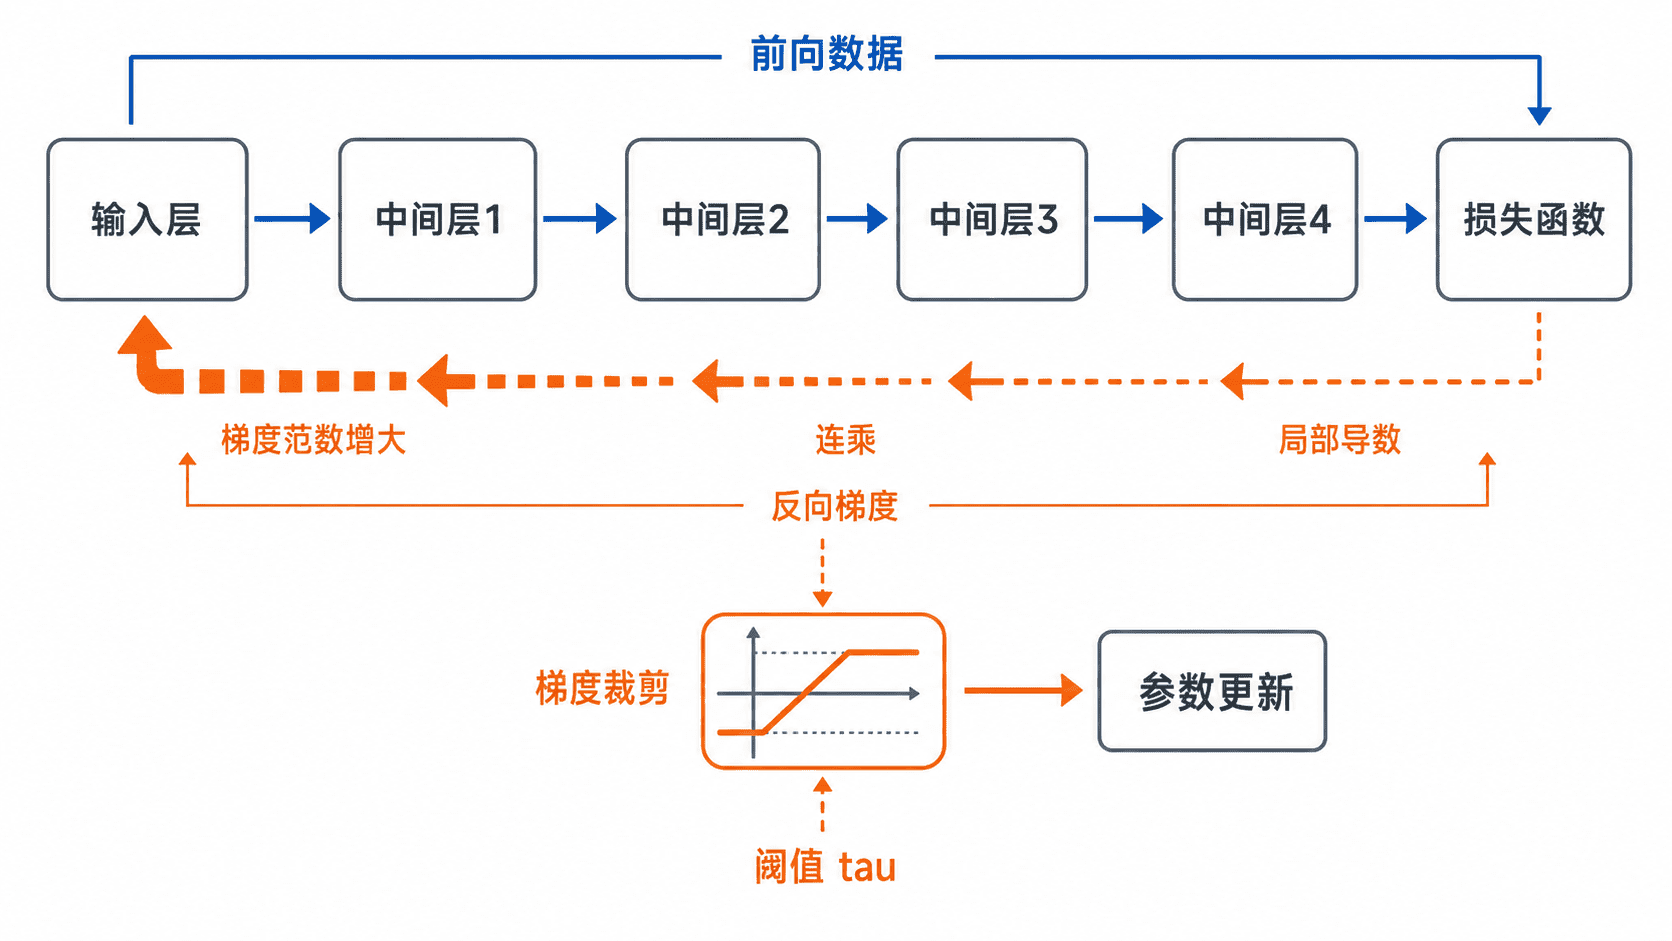
设一条标量计算链满足 ,损失为 。反向传播到最前端时,梯度包含所有局部导数的乘积:
若非零乘子绝对值的几何平均持续大于 ,连乘才会随深度近似指数增长。少数很小的乘子可以抵消多数大于 的乘子。例如每层平均放大 倍,经过 层后放大倍数已超过五万。真实神经网络中的乘子不是单个权重,而是权重矩阵、激活函数导数和其他算子的雅可比矩阵共同组成的链式乘积。
如何识别梯度爆炸
最直接的指标是反向传播后的梯度范数。若它在少数步骤内从稳定区间突然升高多个数量级,随后损失剧烈震荡,参数出现 Inf 或 NaN,通常需要优先排查梯度爆炸。单纯“损失较大”并不能证明发生了爆炸,因为模型在训练初期也可能具有较高但仍有限的损失。
全局二范数把全部梯度视为一个长向量:
监控时应在反向传播完成后、优化器更新前记录该值。若要记录未裁剪梯度,应在反向传播和必要的解缩放之后、裁剪和参数更新之前读取。
主示例:观察连乘与梯度裁剪
下面的程序先计算固定放大因子在不同深度下形成的梯度,再把一个范数很大的梯度向量裁剪到阈值 。裁剪采用全局范数缩放,不改变各分量之间的方向比例。
import math
import sys

def clip_by_global_norm(gradient: list[float], max_norm: float) -> list[float]:
    if not math.isfinite(max_norm) or max_norm < 0:
        raise ValueError("max_norm must be finite and nonnegative")
    if not all(math.isfinite(value) for value in gradient):
        raise ValueError("gradient contains nonfinite values")

    largest = max((abs(value) for value in gradient), default=0.0)
    if largest == 0:
        return gradient.copy()

    # 先缩放到 [-1, 1],避免直接平方大分量
    normalized = [value / largest for value in gradient]
    norm = math.hypot(*normalized)
    if norm <= max_norm / largest:
        return gradient.copy()

    scale = (max_norm / largest) / norm
    if scale >= sys.float_info.min:
        # 可表示的正常缩放因子直接乘原分量,保留混合尺度的小分量
        return [value * scale for value in gradient]
    return [value * (max_norm / norm) for value in normalized]

def main() -> None:
    local_multiplier = 1.2
    for depth in (10, 30, 60):
        gradient = local_multiplier ** depth
        print(f"depth={depth:2d}, gradient={gradient:.6e}")

    original = [120.0, -80.0, 60.0]
    clipped = clip_by_global_norm(original, max_norm=5.0)

    original_norm = math.hypot(*original)
    clipped_norm = math.hypot(*clipped)
    print(f"original_norm={original_norm:.4f}")
    print("clipped=[" + ", ".join(f"{value:.4f}" for value in clipped) + "]")
    print(f"clipped_norm={clipped_norm:.4f}")

    large = clip_by_global_norm([1.7e308, 1.7e308], max_norm=5.0)
    print(f"large_input_norm_after_clipping={math.hypot(*large):.4f}")
    assert math.isclose(math.hypot(*large), 5.0)
    assert clip_by_global_norm([0.0, 0.0], 5.0) == [0.0, 0.0]

if __name__ == "__main__":
    main()
预期输出
depth=10, gradient=6.191736e+00
depth=30, gradient=2.373763e+02
depth=60, gradient=5.634751e+04
original_norm=156.2050
clipped=[3.8411, -2.5607, 1.9206]
clipped_norm=5.0000
large_input_norm_after_clipping=5.0000
输出表明,固定为 的局部放大经过深层连乘后迅速增大;裁剪后各分量按同一比例缩小,全局范数恰好落在阈值附近。
梯度裁剪的作用与边界
按全局范数裁剪时,设阈值为 ,处理后的梯度为:
公式对非零有限梯度使用,零向量保持为零。反向传播后再裁剪,最后调用优化器更新。若使用 PyTorch AMP 的梯度缩放,在检查或裁剪前先调用 scaler.unscale_(optimizer)。按值裁剪逐个截断分量,可能改变整体方向。
裁剪直接限制的是传入优化器的梯度范数。对无动量、无额外项的普通 SGD,更新范数至多为学习率乘以阈值;带动量、自适应缩放或权重衰减时,实际更新还受其他项影响。裁剪也不能消除梯度爆炸的根因。若梯度长期撞到阈值,应继续检查学习率是否过大、权重初始化是否不合适、网络是否缺少归一化或残差连接,以及循环网络的序列是否过长。混合精度训练中还要确认损失缩放与溢出检测是否正常。