
高等数学 / 系统课时
逻辑回归与交叉熵
逻辑回归与交叉熵
逻辑回归需要同时解决两个问题:把任意实数分数转换为概率,并让错误概率可以被稳定优化。本课从 Sigmoid 与伯努利似然出发建立二分类交叉熵,再推导出简洁的梯度 。
学习目标
- 说明 Sigmoid 如何把线性分数映射为概率
- 从最大似然推导二分类交叉熵
- 推导逻辑回归的参数梯度并完成数值验证
从线性分数到概率
逻辑回归先计算线性分数 ,再通过 Sigmoid 得到正类概率:
当 时,; 越大,模型越倾向预测正类; 越小,模型越倾向预测负类。Sigmoid 只负责概率映射,真正决定参数如何更新的是后面的损失函数。
从似然到交叉熵
对标签 ,单个样本出现的概率可以统一写成 。多个独立样本的似然是这些概率的乘积。最大化似然等价于最小化负对数似然,于是得到二分类交叉熵:
当真实标签为 1 时,只保留 ;当真实标签为 0 时,只保留 。预测越自信却越错误,损失增长越快,因此交叉熵能强烈纠正高置信度误判。
梯度为什么化简为 p-y
对单个样本使用链式法则,交叉熵关于线性分数的导数最终化简为:
继续对参数求导,可得:
这个结果非常关键:Sigmoid 导数中的 与交叉熵求导产生的分母相互抵消。训练时只需用“预测概率减真实标签”作为误差信号,再乘对应特征。
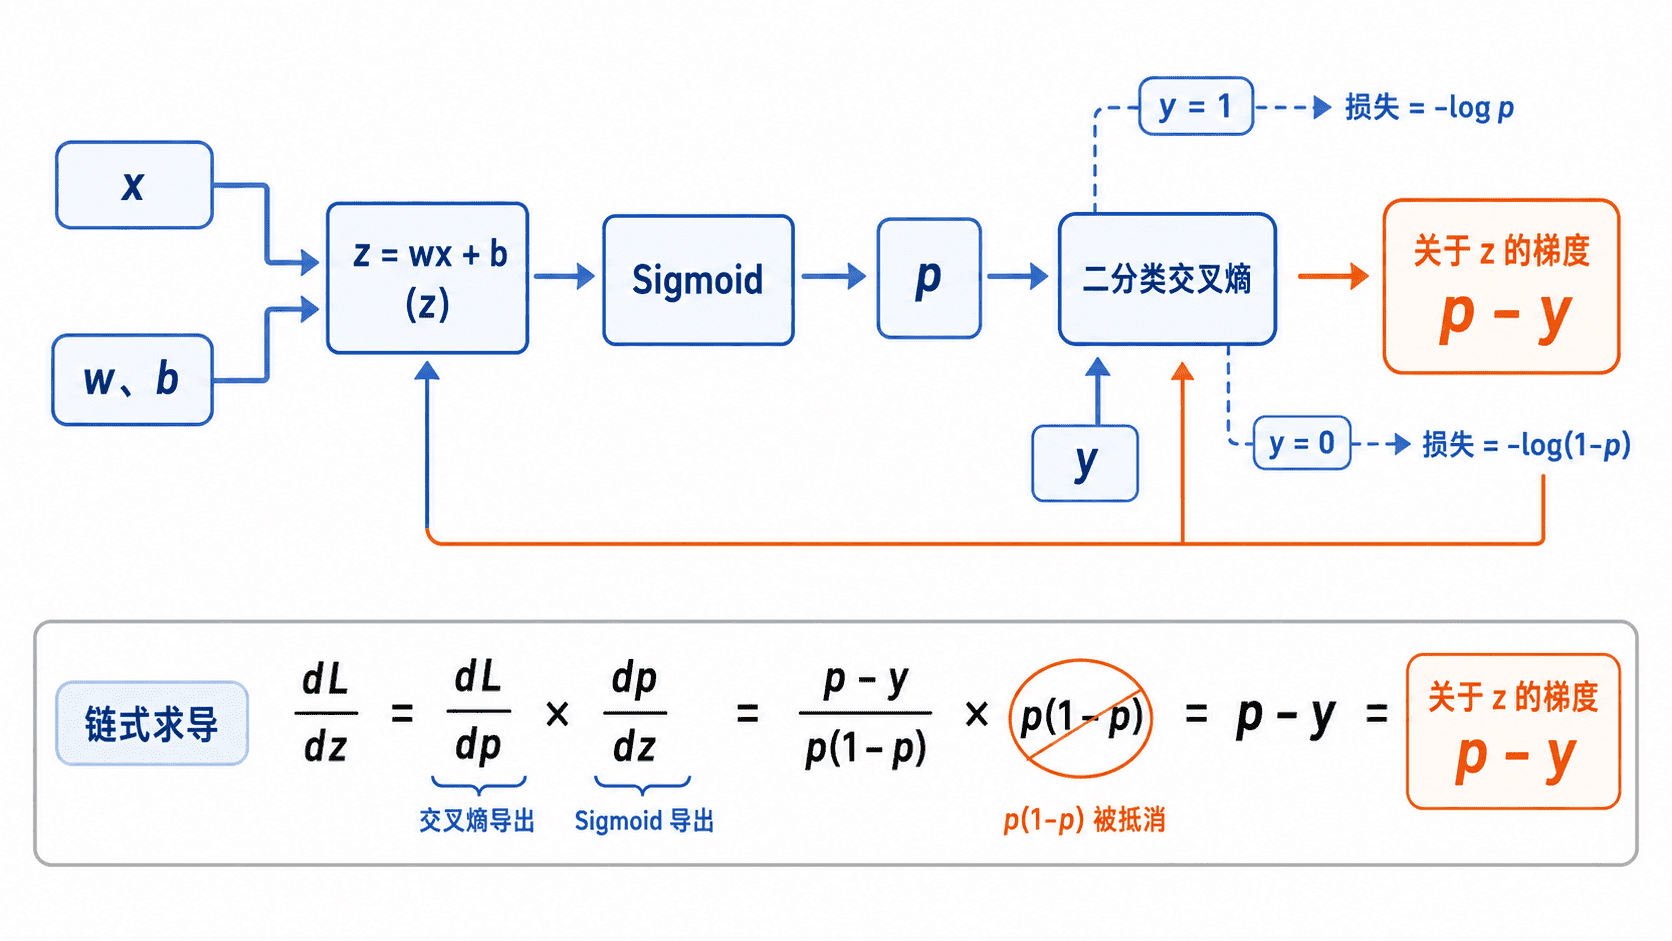
用一次梯度下降验证
下面用四个一维样本,从 、 开始训练一步。损失直接使用 logits,概率用于计算误差信号。初始概率都是 ,更新后正负样本应被推向不同方向。
import numpy as np

x = np.array([-2.0, -1.0, 1.0, 2.0])
y = np.array([0.0, 0.0, 1.0, 1.0])

def sigmoid(value: np.ndarray) -> np.ndarray:
    weight = np.exp(-np.abs(value))
    return np.where(value >= 0, 1.0 / (1.0 + weight), weight / (1.0 + weight))

def binary_cross_entropy(logits: np.ndarray, labels: np.ndarray) -> float:
    # labels 为 0 或 1。按带符号的 logit 计算 softplus
    signed = (1.0 - 2.0 * labels) * logits
    return float(np.mean(np.logaddexp(0.0, signed)))

w, b = 0.0, 0.0
logits = w * x + b
p = sigmoid(logits)

# 交叉熵与 Sigmoid 组合后的解析梯度
grad_w = np.mean((p - y) * x)
grad_b = np.mean(p - y)

print(f'initial loss: {binary_cross_entropy(logits, y):.4f}')
print('probabilities:', np.round(p, 4))
print(f'grad_w: {grad_w:.4f}')
print(f'grad_b: {grad_b:.4f}')

learning_rate = 0.5
w -= learning_rate * grad_w
b -= learning_rate * grad_b
updated_logits = w * x + b
updated_p = sigmoid(updated_logits)

print(f'updated w: {w:.4f}')
print('updated probabilities:', np.round(updated_p, 4))
print(f'updated loss: {binary_cross_entropy(updated_logits, y):.4f}')
预期输出:
initial loss: 0.6931
probabilities: [0.5 0.5 0.5 0.5]
grad_w: -0.7500
grad_b: 0.0000
updated w: 0.3750
updated probabilities: [0.3208 0.4073 0.5927 0.6792]
updated loss: 0.4550
更新后,负类样本的概率下降,正类样本的概率上升,交叉熵也从 降到 。这说明 给出了正确的误差方向。
数值稳定与决策边界
直接计算 或 时,若概率被舍入为 0 或 1,就会出现无穷大。可直接计算 ,用 logaddexp 避免先算概率再取对数。若 而 ,损失约为 ,可以保留高置信误判的真实惩罚。对本课可完全分离的样本,无正则的交叉熵可沿分离方向越来越接近零,但没有有限参数取到零。
概率阈值只影响预测结果,不参与上述损失推导。常见阈值是 ,对应决策边界 ;类别不平衡或误判成本不同的任务,可以在验证集上重新选择阈值,而不是随意修改训练标签。
易混淆点
- 逻辑回归虽然名称含“回归”,解决的通常是分类问题,输出是类别概率。
- 交叉熵衡量概率分布与标签的差异,不能只看最终分类是否正确。
- 使用 MSE 也能训练 Sigmoid 模型,但梯度更容易在饱和区变小,通常不如交叉熵直接。