本课解决“变量经过多层计算后如何求导”的问题。核心方法是沿每条依赖路径相乘局部导数,再把所有路径的贡献相加,这正是计算图和反向传播的数学基础。
设最终结果由两个中间变量决定:
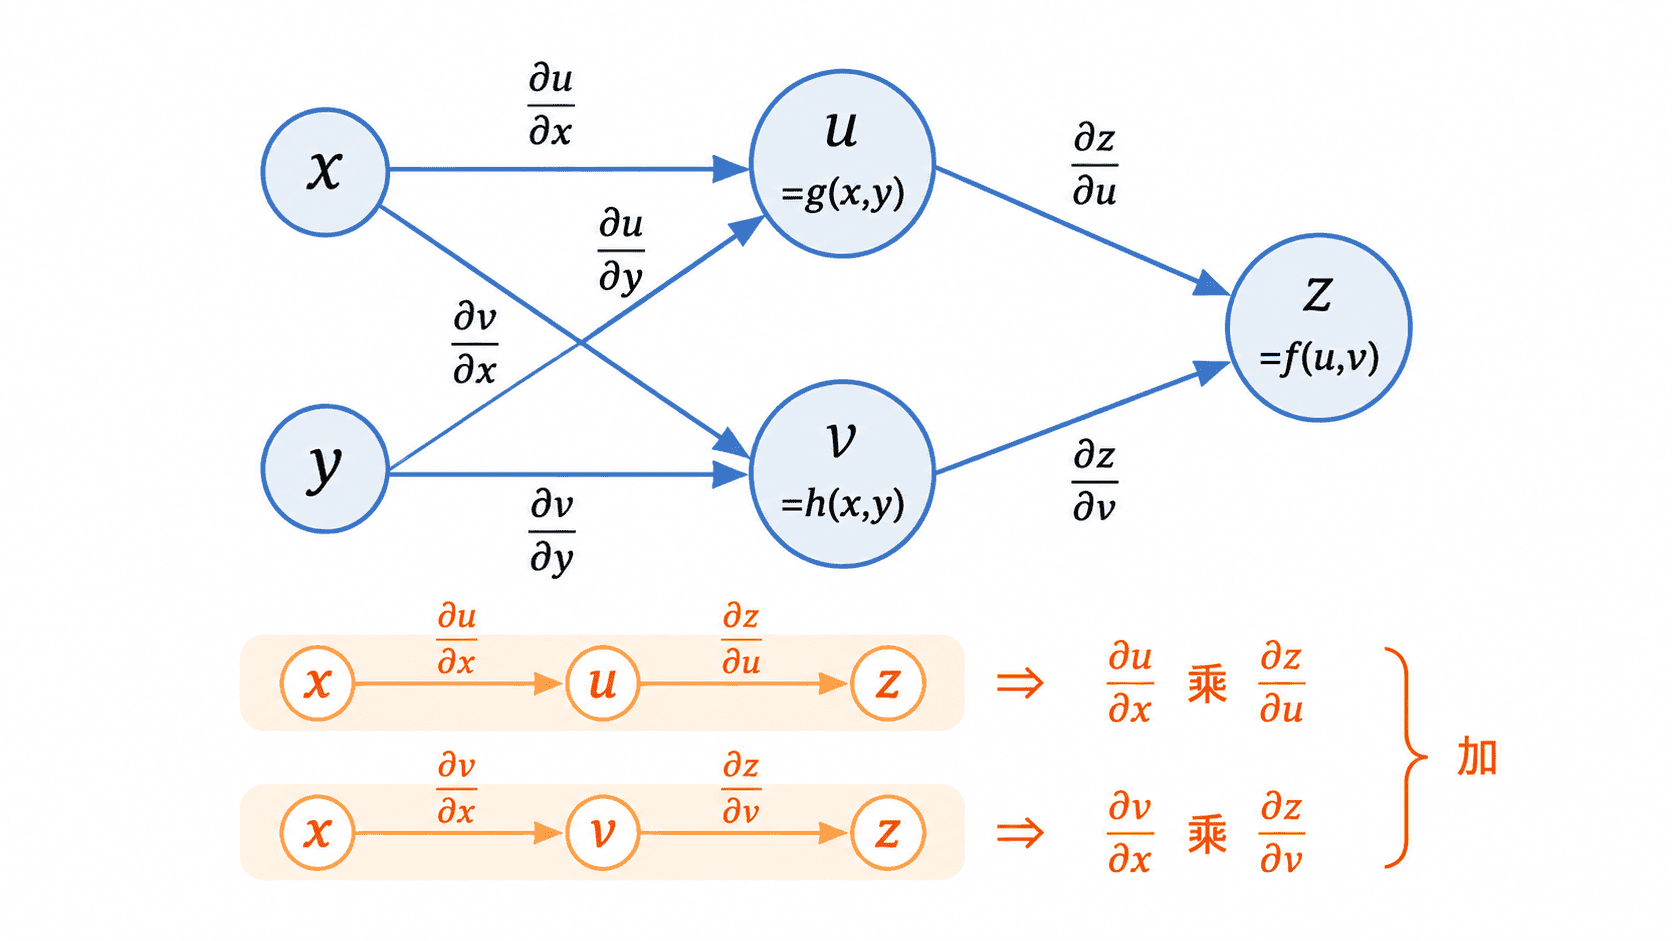
此时 会通过两条路径影响 : 和 。求导时不能只选其中一条,而要计算所有路径的贡献。
若各映射在相应点可微,固定 后对 求偏导得到
对 同理:
外层的两个偏导在当前 上求值,内层的偏导在当前 上求值。每一项对应一条从输入变量到输出变量的路径。路径内部的局部导数相乘,多条路径之间相加。只要依赖图没有遗漏,这个规则可以继续扩展到更多中间变量和更深层级。
设
先计算局部导数:
以及
因此
在 处,,所以
同理,
把原式展开为 后直接求导,也会得到相同结果。这种展开验证适合简单表达式,但在深层模型中会迅速变得冗长,因此通常保留计算图并逐层求局部导数。
若把梯度写成列向量,令
则链式法则可写为
这里使用输出为行、输入为列的雅可比矩阵。一般地,若有 个输入和 个中间变量,则 是 ,转置后乘以 维的列梯度 ,得到 维列梯度 。矩阵形式本质上没有改变规则,只是一次性整理了所有路径的乘法与加法。使用不同教材或框架时,要先确认梯度采用行向量还是列向量约定。
反向传播先在前向计算中保存必要的中间值,再从输出开始反向传递梯度。每经过一条边,就乘以该边对应的局部导数;当同一变量通过多条路径影响结果时,就把回传梯度累加。
这种做法避免反复展开完整复合函数,也复用了中间计算结果。神经网络虽然层数很多,但每个节点只需知道自己的输入、输出和局部导数,因此可以模块化地完成求导。
最常见的问题是漏掉一条依赖路径,例如只计算 ,却忽略 。另一个错误是把局部导数代入错误的点:应先完成前向计算,得到当前样本下的 、,再在这些中间值上求局部导数。使用矩阵公式时,还要检查维度和转置是否与约定一致。
