
高等数学 / 系统课时
L1正则化
L1正则化
L1 正则化通过惩罚参数绝对值之和,使不重要的权重更容易被压到零,从而得到稀疏模型。本课将连接绝对值函数的不可导点、次梯度更新和几何约束,解释稀疏解为什么不是偶然现象。
学习目标
- 写出 L1 正则化目标及其分段梯度
- 理解零点不可导时如何使用次梯度
- 解释 L1 正则化产生稀疏解的机制
绝对值惩罚的形式
设模型参数为 ,原始损失为 。加入 L1 正则化后,目标函数为:
其中 ,且
L1 惩罚对每个参数的绝对值按线性速度增长。参数从 增加到 ,惩罚增加 ;从 增加到 ,惩罚仍只增加 。与 L2 不同,它不会因为参数已经很大而进一步放大惩罚斜率。
不可导点与次梯度
对单个参数 ,绝对值函数的导数为:
在 处,左右导数不相等,因此普通导数不存在。凸优化中通常使用次梯度描述这一点:
在非零坐标,惩罚项的梯度是 。若 可微,某个最优点的第 个权重为零,需要数据梯度被区间 内的惩罚次梯度抵消,即 。若数据梯度超出这个范围,该坐标无法在零点满足一阶最优条件。
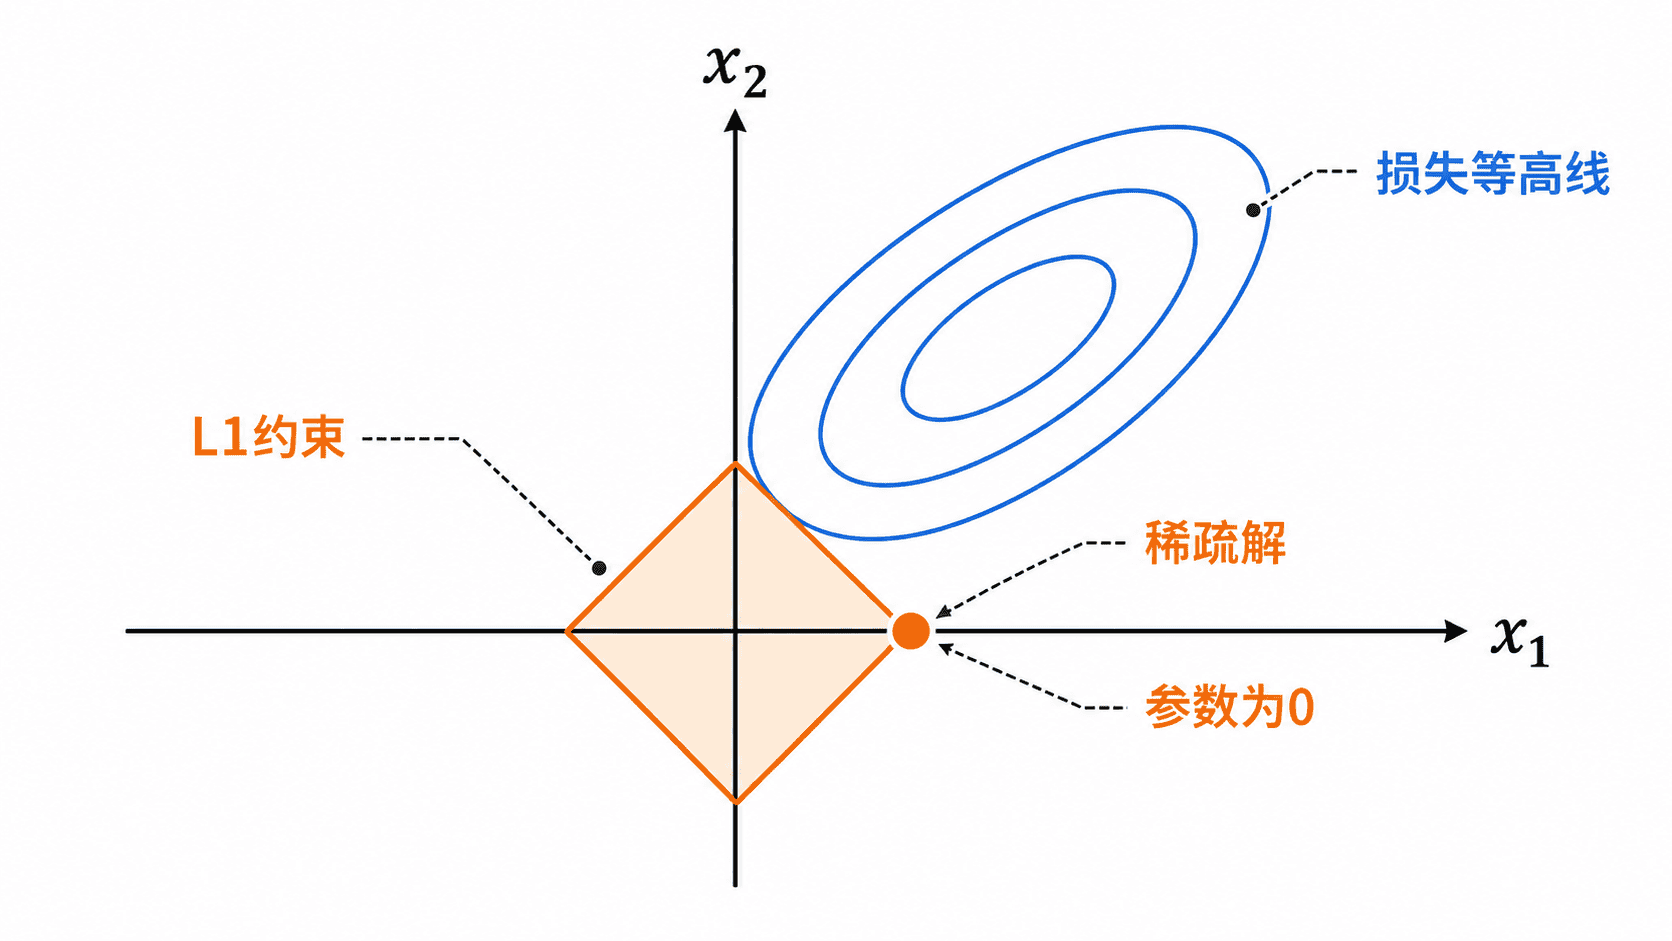
软阈值更新如何得到零
当 是光滑损失时,近端梯度法将数据梯度步和 L1 近端步分开。标准凸问题通常根据 的 Lipschitz 常数或回溯规则选步长。先沿数据损失梯度更新,再执行软阈值操作:
当 时,更新结果会直接变成零;当绝对值更大时,则向零方向缩小固定距离。近端步把一段连续区间内的值直接映射为零。下面把一组梯度步后的值当作 ,执行一次软阈值。
import numpy as np

values = np.array([0.03, -0.20, 1.50, -2.00])
learning_rate = 0.1
regularization = 0.5
threshold = learning_rate * regularization

# 近端算子:绝对值不超过阈值的参数直接变为零
updated = np.sign(values) * np.maximum(np.abs(values) - threshold, 0.0)

print("threshold =", threshold)
print("updated =", updated)

np.testing.assert_allclose(updated, [0.0, -0.15, 1.45, -1.95])
boundary = np.array([-threshold, threshold])
assert np.all(np.sign(boundary) * np.maximum(np.abs(boundary) - threshold, 0) == 0)
预期输出
threshold = 0.05
updated = [ 0.   -0.15  1.45 -1.95]
第一个参数的绝对值为 ,小于阈值 ,因此被直接压到零;其他参数则各自向零移动 。这说明 L1 不只是“让参数变小”,还会形成明确的零值。
例如最小化 ,最优解是 。当 时,数据梯度在零点的大小不超过惩罚次梯度能抵消的范围,故最优值在 取得。
稀疏性的价值与代价
稀疏参数可以减少无效特征的影响,并提高线性模型的可解释性。当输入维度很高、只有少量特征真正有用时,L1 常被用于特征选择。
但稀疏并不等于一定更好。若多个特征高度相关,L1 可能保留其中一个而压掉其他特征,结果对数据扰动较敏感。此时可以考虑结合 L1 与 L2 的 Elastic Net,让模型同时获得稀疏性与更稳定的参数分配。
仍应通过验证集选择。过小无法形成明显稀疏,过大则可能删除有用特征,使训练误差和验证误差同时升高。
易混淆点
L1 正则化在零点不可导,不代表目标函数无法优化。次梯度法、坐标下降和近端梯度法都能处理这一结构。
L1 产生稀疏解也不意味着每次普通梯度更新都会精确得到零。使用软阈值近端算子时,参数进入阈值区间才会被直接截断为零。