
高等数学 / 系统课时
两层神经网络求导
两层神经网络求导
本课对一个“线性层—ReLU—线性层—均方误差”网络执行完整前向与反向传播。你将沿计算图逐层传递梯度,并用数值差分核对手工公式是否正确。
学习目标
- 写出两层网络前向传播的矩阵表达式
- 按链式法则计算权重、偏置和输入梯度
- 使用数值梯度检查反向传播结果
网络结构与维度
设批量输入为 ,隐藏层宽度为 ,输出维度为 。本课使用以下前向过程:
损失是所有 个残差元素的平方均值再乘以 , 是 Frobenius 范数。其中 的形状为 , 的形状为 。偏置会沿批量维广播,但反向传播时必须把各样本贡献沿批量维求和。
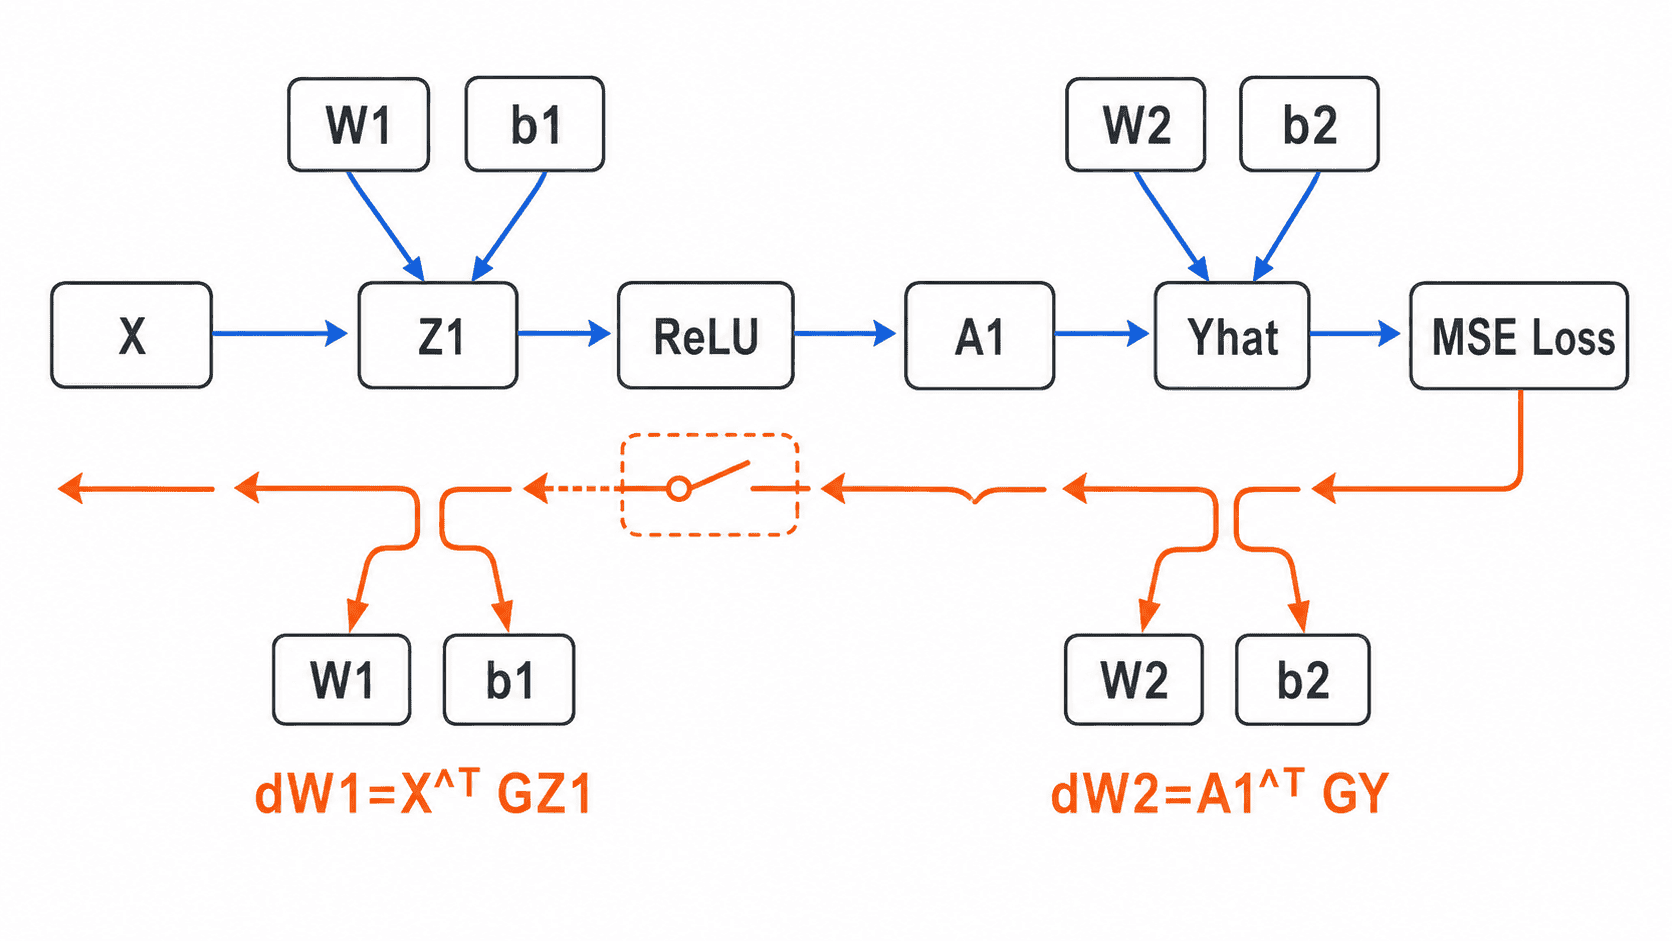
这张计算图的核心不是记忆所有公式,而是保存每一步前向输入,并在反向时使用“上游梯度乘局部导数”。矩阵乘法还需同时检查乘法顺序和转置位置。
从损失开始反向传播
令输出层上游梯度为:
第二个线性层的参数梯度与传给隐藏层的梯度分别为:
ReLU 在正区间导数为 1,在负区间导数为 0,因此它像一个门控器:
继续经过第一个线性层即可得到:
若还需要把梯度传到更早的网络,则有 。
可运行反向传播示例
先用单样本展示中间量,再用双样本和双输出检查归一化及梯度。单样本网络包含两个隐藏单元。第一个单元激活,第二个单元因 被 ReLU 截断,因此第二列相关梯度应为 0。
python
import numpy as np


def forward(x, w1, b1, w2, b2):
    z1 = x @ w1 + b1
    a1 = np.maximum(z1, 0.0)
    return z1, a1, a1 @ w2 + b2


def backward(x, w1, w2, z1, a1, y_hat, y):
    g_y_hat = (y_hat - y) / y.size
    g_z1 = (g_y_hat @ w2.T) * (z1 > 0)
    return (
        g_z1 @ w1.T,
        x.T @ g_z1,
        g_z1.sum(axis=0, keepdims=True),
        a1.T @ g_y_hat,
        g_y_hat.sum(axis=0, keepdims=True),
    )


def loss(inputs, target):
    return 0.5 * np.mean((forward(*inputs)[2] - target) ** 2)


def difference(inputs, target, position, index, step=1e-5):
    plus, minus = list(inputs), list(inputs)
    plus[position] = inputs[position].copy()
    minus[position] = inputs[position].copy()
    plus[position][index] += step
    minus[position][index] -= step
    return (loss(plus, target) - loss(minus, target)) / (2 * step)


x = np.array([[1.0, -2.0]])
w1 = np.array([[0.5, -0.3], [-0.8, 0.2]])
b1 = np.array([[0.1, -0.1]])
w2 = np.array([[0.7], [-1.2]])
b2 = np.array([[0.05]])
y = np.array([[1.0]])

inputs = (x, w1, b1, w2, b2)
z1, a1, y_hat = forward(*inputs)
dx, dw1, db1, dw2, db2 = backward(x, w1, w2, z1, a1, y_hat, y)
numeric_grad = difference(inputs, y, 1, (0, 0))

print("z1:", np.round(z1, 4))
print("a1:", np.round(a1, 4))
print("y_hat:", np.round(y_hat, 4))
print("loss:", round(float(loss(inputs, y)), 6))
print("dw2:", np.round(dw2, 4))
print("dw1:", np.round(dw1, 4))
print("db1:", np.round(db1, 4))
print("dx:", np.round(dx, 4))
print("gradient_check:", round(float(numeric_grad), 6), round(float(dw1[0, 0]), 6))

x = np.array([[1.0, -2.0], [0.5, 1.0]])
w2 = np.array([[0.7, 0.4], [-1.2, 0.3]])
b2 = np.array([[0.05, -0.02]])
y = np.array([[1.0, 0.3], [-0.1, 0.2]])
inputs = (x, w1, b1, w2, b2)
z1, a1, y_hat = forward(*inputs)
grads = backward(x, w1, w2, z1, a1, y_hat, y)
for position, gradient in enumerate(grads):
    numerical = np.empty_like(gradient)
    for index in np.ndindex(gradient.shape):
        numerical[index] = difference(inputs, y, position, index)
    np.testing.assert_allclose(gradient, numerical, atol=1e-9, rtol=1e-7)

print("双样本双输出: 全部梯度通过")
预期输出
text
z1: [[ 2.2 -0.8]]
a1: [[2.2 0. ]]
y_hat: [[1.59]]
loss: 0.17405
dw2: [[1.298]
 [0.   ]]
dw1: [[ 0.413  0.   ]
 [-0.826  0.   ]]
db1: [[0.413 0.   ]]
dx: [[ 0.2065 -0.3304]]
gradient_check: 0.413 0.413
双样本双输出: 全部梯度通过
解析梯度与数值梯度一致,说明 的反向公式正确。第二个隐藏单元未激活,所以 dw1 第二列和 dw2 第二行均为 0,这正是 ReLU 门控的直接结果。
易错点与验证顺序
求导时先检查每个张量形状,再检查转置。若 是 、 是 ,则只有 才能得到与 相同的 形状。
偏置梯度不是直接复制某个样本梯度,而是沿批量维求和。本课按全部输出元素平均,分母是 ;若改为先对每个样本的输出求和再做批量平均,分母才是 。ReLU 在 0 点不可导,工程中通常约定导数为 0;做数值梯度检查时应避免参数恰好落在该折点附近。
按自己的节奏,确认真正理解。