
高等数学 / 系统课时
常见激活函数
常见激活函数
激活函数把神经元的仿射计算结果转换为非线性输出,使神经网络能够拟合复杂关系。本课比较 Sigmoid、Tanh、ReLU、Softplus 和 GELU,重点掌握它们的公式、图像、输出范围以及基本使用特点。
学习目标
- 写出五种常见激活函数的公式与输出范围
- 根据函数图像判断饱和区、零点和增长方式
- 理解不同激活函数对梯度传播的基本影响
激活函数解决什么问题
一层神经网络通常先计算仿射变换 ,其中 是偏置。如果层与层之间没有非线性,这些仿射变换仍能合并成一个仿射变换,模型的表达能力就受到限制。
激活函数对 进行非线性映射,得到 。不同函数的输出范围、导数大小和负数处理方式不同,因此会影响训练速度、梯度稳定性和神经元是否容易失活。
五种函数的公式与范围
| 函数 | 公式 | 输出范围 | 关键特征 |
|---|---|---|---|
| Sigmoid | 输出可解释为概率,但两端容易饱和 | ||
| Tanh | 以零为中心,两端同样存在饱和 | ||
| ReLU | 正区间梯度稳定,计算简单 | ||
| Softplus | ReLU 的平滑近似,处处可导 | ||
| GELU | , | 允许负输出,正侧逐渐接近恒等映射 |
其中 是标准正态分布的累积分布函数, 是精确 GELU 的最小函数值。GELU 在负输入时输出为负, 时从负侧趋近于零, 时近似 。因此其下方有界、上方无界。
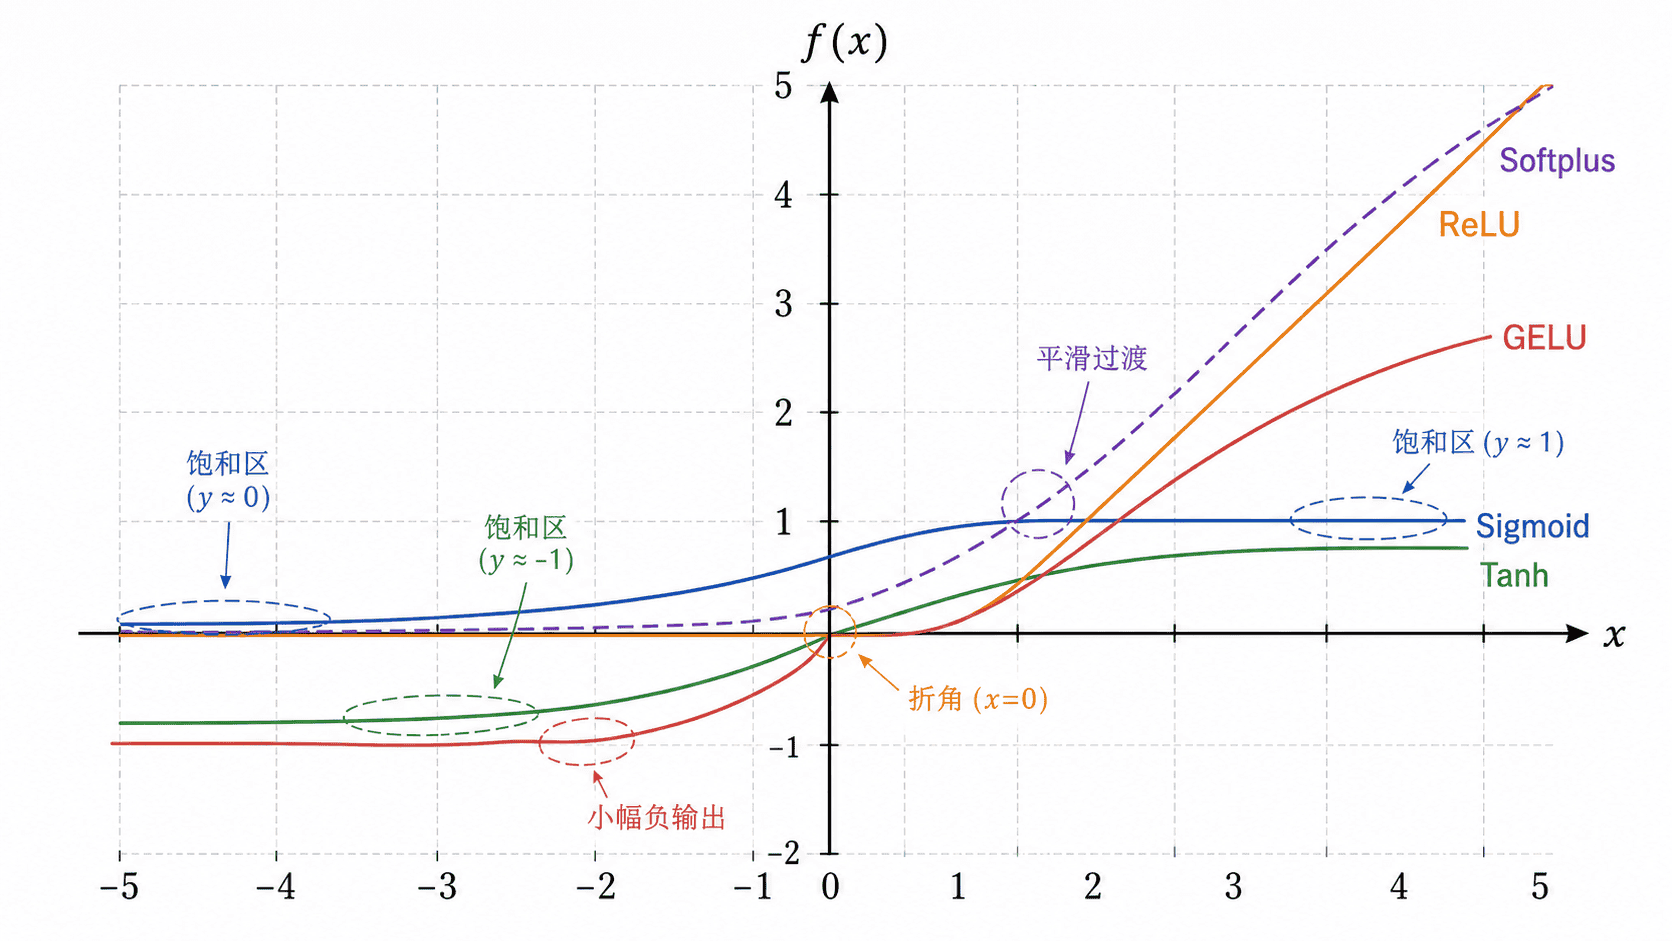
从图像理解基本特性
Sigmoid 在 时输出 ,输入绝对值增大后曲线逐渐变平。曲线变平意味着导数接近零,深层网络反向传播时容易出现梯度消失。它的输出位于零到一之间,因此常用于二分类模型的输出层。
Tanh 的形状与 Sigmoid 相似,但输出以零为中心。当输入接近零时,Tanh 的变化速度较快;当输入远离零点时也会进入饱和区。它适合需要正负输出的场景,但不能彻底解决梯度消失。
ReLU 在负区间输出零,在正区间保持线性增长。正区间导数为 ,有利于梯度传播;如果某个神经元长期接收负输入,其输出和梯度都可能持续为零,这种现象称为神经元失活。
Softplus 使用平滑曲线连接负区间和正区间,没有 ReLU 在零点处的折角。它处处可导,但负输入仍会产生很小的正输出,计算成本也高于 ReLU。
GELU 在输入较大时接近恒等映射,在输入较小时平滑抑制信号。它兼顾了非线性和连续性,常见于 Transformer 等现代神经网络结构。
实算不同输入下的激活值
下面用 Python 标准库比较几种激活函数。Softplus 写成 ,以免正输入很大时计算 上溢。GELU 使用 计算精确形式。
import math


def sigmoid(x):
    weight = math.exp(-abs(x))
    return 1 / (1 + weight) if x >= 0 else weight / (1 + weight)


def relu(x):
    return max(0.0, x)


def softplus(x):
    return relu(x) + math.log1p(math.exp(-abs(x)))


def gelu(x):
    cdf = 0.5 * math.erfc(-x / math.sqrt(2))
    return x * cdf


for x in (-2.0, 0.0, 2.0):
    values = (sigmoid(x), math.tanh(x), relu(x), softplus(x), gelu(x))
    print(f"{x:4.0f}" + "".join(f"{value:9.4f}" for value in values))

assert softplus(1000.0) == 1000.0
assert abs(gelu(-0.7518) - (-0.16997)) < 1e-5
每行先打印输入,后续五列依次是 Sigmoid、Tanh、ReLU、Softplus 和 GELU。
  -2   0.1192  -0.9640   0.0000   0.1269  -0.0455
   0   0.5000   0.0000   0.0000   0.6931   0.0000
   2   0.8808   0.9640   2.0000   2.1269   1.9545
GELU 的导数为 ,其中 是标准正态密度。最小值位于导数从负变正的位置,约在 。这里列出的是实数函数的值域,浮点运算可能把极端输入的结果舍入到区间端点。
如何进行基础选择
隐藏层没有特殊要求时,ReLU 通常是简单可靠的起点。模型出现大量失活神经元时,可以进一步考虑允许负区间保留梯度的变体,而不是盲目增加网络深度。
二分类中可用 Sigmoid 将单个 logit 转成正类概率。单标签、互斥的多分类使用 Softmax 给出总和为 1 的类别概率。多标签任务允许同一样本有多个标签,可以对每个类别独立使用 Sigmoid。计算训练损失时可使用直接接收 logits 的交叉熵实现,概率可留到推理或评估时计算。Tanh 适合希望输出围绕零分布的结构。
Softplus 和 GELU 都提供平滑过渡。Softplus 更接近平滑版 ReLU,GELU 则依据输入大小进行软门控。实际选择还应结合网络结构、初始化方式和验证集表现,不能只依据单个函数的理论优点。
易混淆点
激活函数的输出范围不等于导数范围。例如,Sigmoid 的输出始终为正,但其导数在饱和区会接近零。判断训练是否稳定时,应同时观察函数值和斜率。
是否处处可导只是选择激活函数时的一项性质。ReLU 在零点的左右导数分别为 0 和 1,因此不存在经典导数。自动微分可以约定一个次梯度,例如 PyTorch 对凸函数按其最小范数次梯度规则取 0。正区间仍使用导数 1。