
高等数学 / 系统课时
损失曲线的导数分析
损失曲线的导数分析
损失值只说明模型当前“错了多少”,导数则说明参数应向哪里移动、移动是否容易。本课读的是固定目标 随参数变化的曲线。训练日志里损失随迭代次数变化,不能直接把那条曲线的斜率当成参数梯度。
学习目标
- 根据一阶导数判断参数更新方向
- 根据二阶导数识别极小值与曲率强弱
- 解释平坦区域和高曲率区域中的训练困难
用一阶和二阶导数读曲线
设损失函数为 ,梯度下降的更新式是:
其中 是学习率。当 时,更新会减小 ;当 时,更新会增大 。若 ,当前位置可能是极小值,也可能是极大值或较长的平坦区域,不能只靠一阶导数下结论。
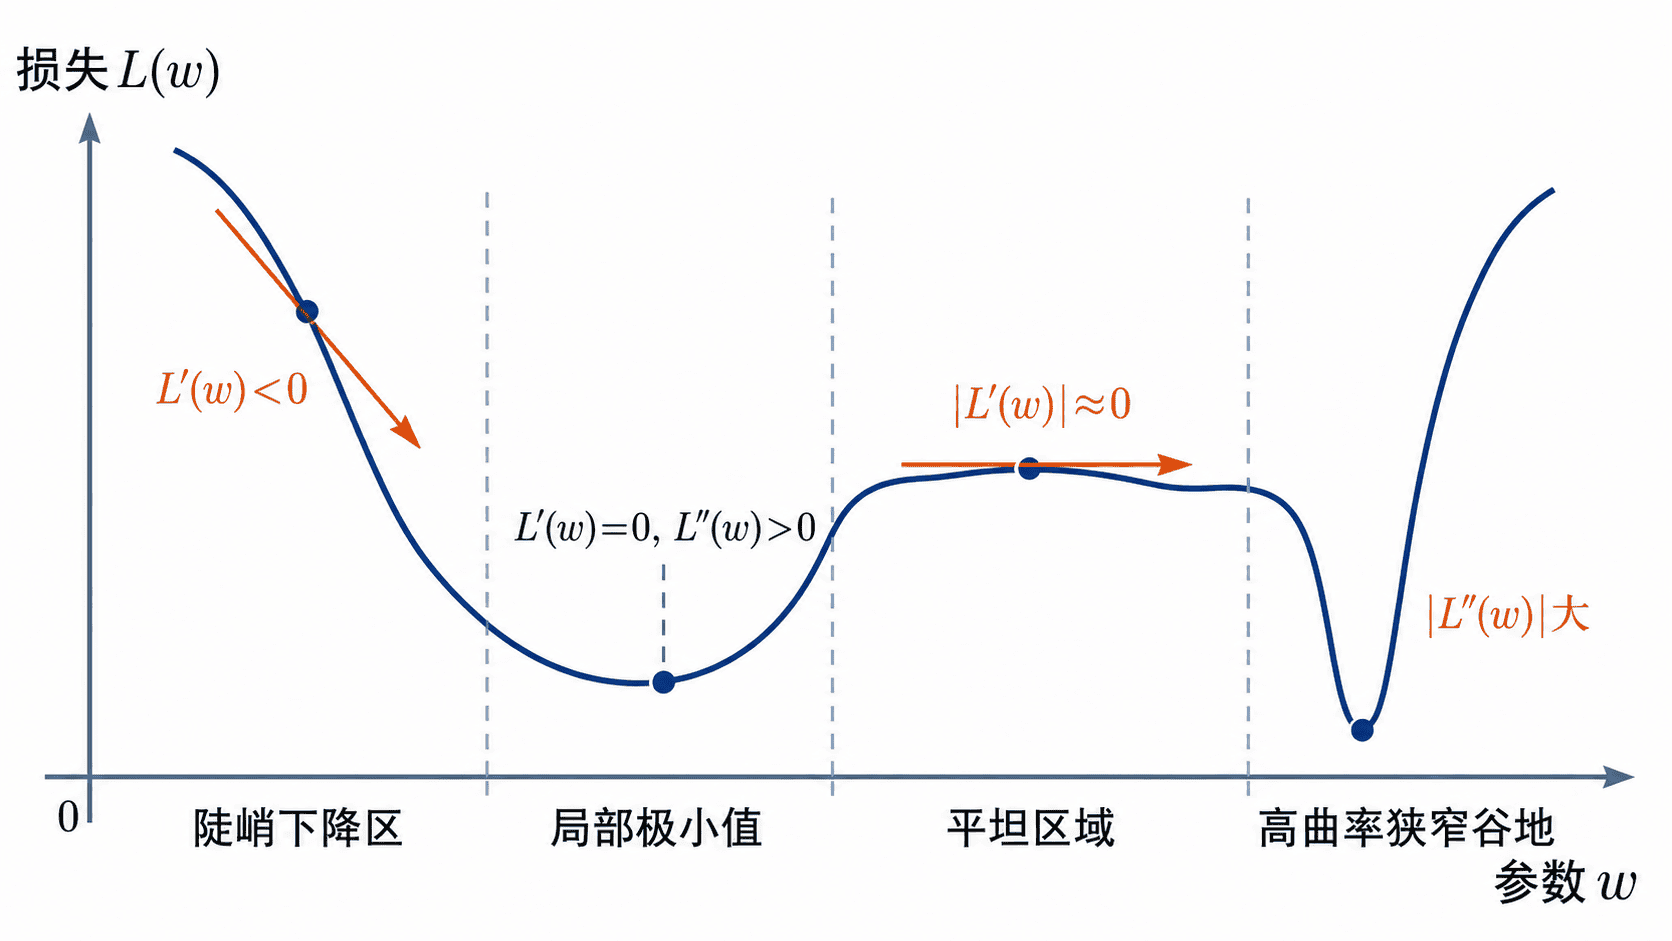
| 曲线位置 | 导数特征 | 对训练的含义 |
|---|---|---|
| 陡峭区域 | $ | L'(w) |
| 满足二阶充分条件的极小值 | 且 | 在该点的足够小邻域内,其他位置的损失更大 |
| 平坦区域 | $ | L'(w) |
| 高曲率区域 | $ | L''(w) |
二阶导数 描述斜率变化的速度。它为正且较大时,斜率随参数快速增大。是否在碗底仍要检查一阶导数。二阶导数接近零说明斜率在局部变化小,此时一阶导数仍可能很大。
主示例:二次损失如何收敛
考虑 ,则 、,极小值位于 。下面从 出发,以学习率 连续更新三次:
python
def loss_gradient(w: float) -> float:
    return 2 * (w - 3)

w = 0.0
learning_rate = 0.2

for step in range(1, 4):
    gradient = loss_gradient(w)
    # 使用当前点的梯度更新参数,再观察它是否接近极小值 3
    w = w - learning_rate * gradient
    print(f"step={step}, w={w:.3f}, gradient={gradient:.3f}")
预期输出:
text
step=1, w=1.200, gradient=-6.000
step=2, w=1.920, gradient=-3.600
step=3, w=2.352, gradient=-2.160
每行的梯度取自更新前的参数,打印的 是更新后的参数。参数每次都向 靠近,同时梯度绝对值逐渐变小。这体现了二次损失上“远处步子大、近处步子小”的基本收敛过程。
平坦区、高曲率与分析边界
在平坦区域,梯度很小,即使方向正确,参数每次也只移动一点。提高学习率可能加快穿越速度,但进入其他区域后又可能造成过冲,因此实际训练常配合动量或自适应学习率。
对 且 ,将导数 代入更新式,得到误差递推 。要让任意非零初始误差趋于零,需要 ,也就是
在主例 中, 每步将误差乘 。把代码中的学习率改为 ,误差每步变号、绝对值不变,参数在 与 间往返。改为 时,误差每步变号且放大为原来的 倍。曲率系数 越大,稳定步长上限越小。这解释了为什么同一个学习率在平缓方向上显得太小,在陡峭方向上却可能太大。
一元曲线通常只是高维损失面的一个切片。实际训练还会受到小批量噪声、数据分布和正则化影响,因此单次损失波动不一定表示更新方向错误;训练损失较低也不等于验证集表现一定更好。
按自己的节奏,确认真正理解。