
高等数学 / 系统课时
连续深度模型
连续深度模型
本课把深度网络理解为随“深度时间”连续演化的动力系统,重点连接常微分方程、残差网络与神经常微分方程,帮助你看清离散层堆叠如何过渡为连续状态轨迹。
学习目标
- 能用微分方程描述隐藏状态的连续变化
- 能解释残差网络与欧拉离散化之间的对应关系
- 能说出神经常微分方程的优势、代价与适用场景
从层堆叠到状态演化
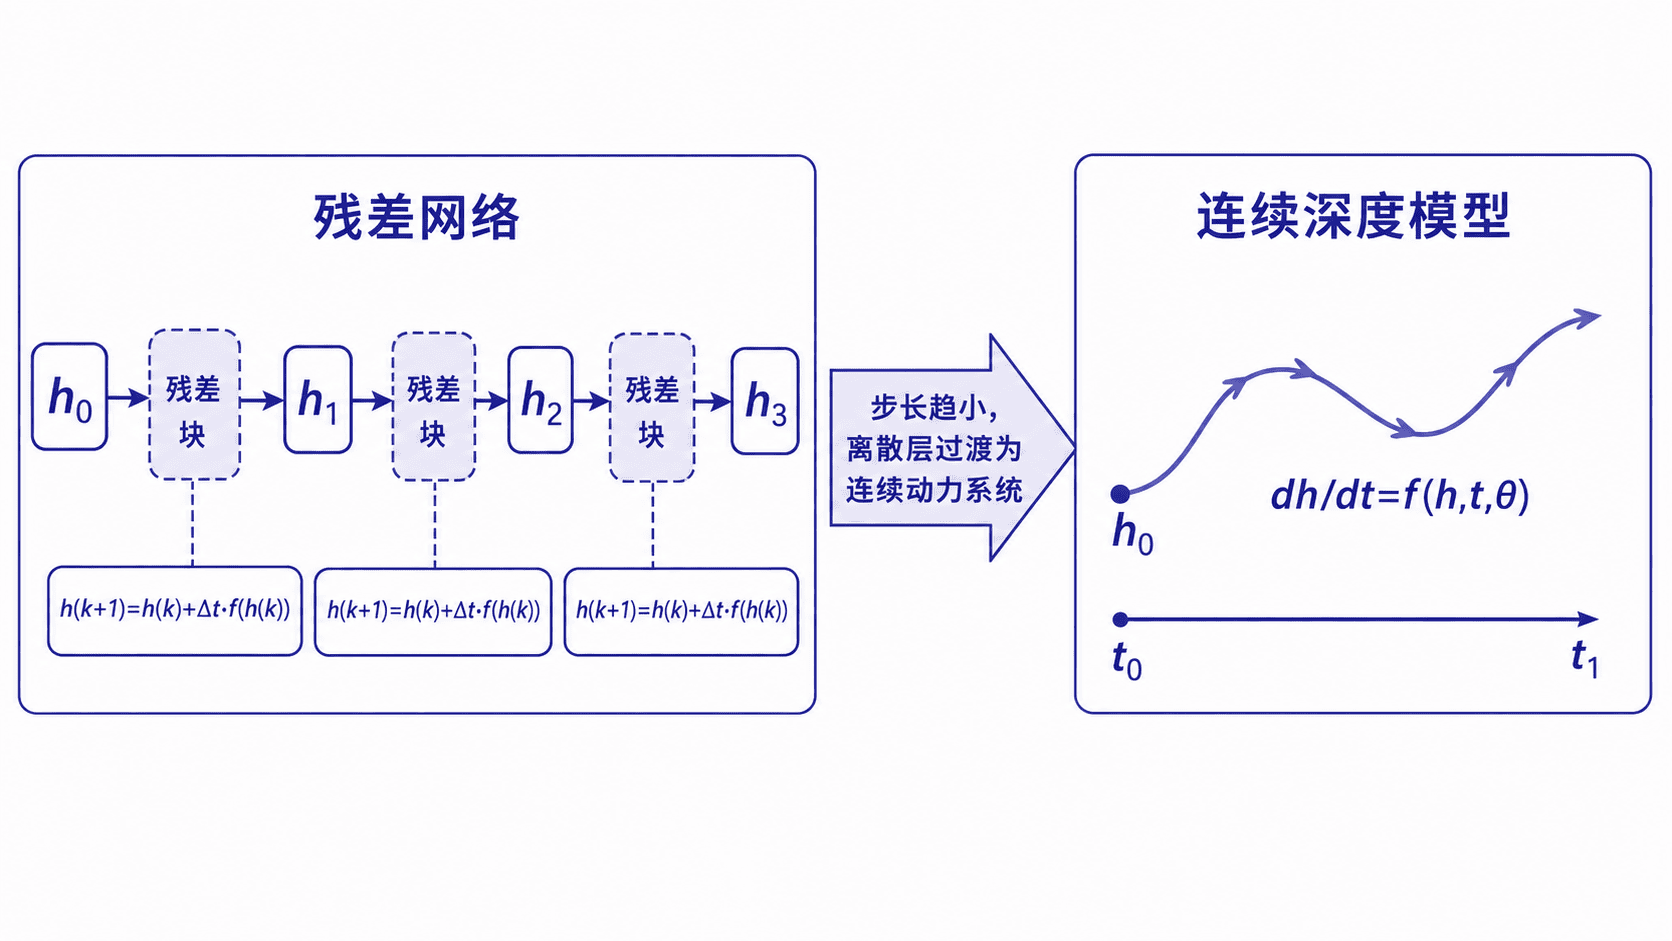
普通深度网络把输入依次送入若干层,每一层都产生一个新的隐藏状态。连续深度模型不再把“层数”看成固定整数,而是引入连续变量 ,让隐藏状态 随 变化。其核心形式是:
其中, 表示由神经网络参数化的变化率, 是可学习参数。给定初始状态 后,模型通过求解微分方程得到终点状态 。
残差网络为什么像欧拉法
残差块常写成:
若把每个残差块视为时间步长 上的一次更新,就得到显式欧拉法的形式:
当残差增量按 缩放、各层来自同一个向量场时,上式就是显式欧拉。固定总时间 ,对足够光滑且求解稳定的系统,细化时间网格才会逼近同一条连续轨迹。任意增加一批独立参数、未经步长缩放的残差块,无法仅凭层数断定有同一个连续极限。
神经常微分方程如何计算
神经常微分方程先用网络定义导数函数 ,再交给数值求解器从 积分到 :
若使用带误差估计的自适应求解器,可按指定容限调整步长和函数评估次数。训练时,可以对离散求解步骤直接求导,也可以求解连续伴随方程。后者的一些实现通过重算或反向积分减少前向轨迹存储,数值误差会影响重构状态和梯度。检查梯度时,可用小规模的直接求导或有限差分交叉核对,并比较不同容限下的结果。
例如取标量隐藏状态 、,令 。显式欧拉对应每个残差块乘以 。取五块、,终点是 ;取十块、,终点约为 。总时间与向量场固定,两组结果都在近似 。
优势与代价
连续深度模型适合不规则时间序列、连续控制、动力系统建模和需要自适应计算深度的任务。在解的存在区间内,可以把数值求解推进到指定观测时刻,也可使用求解器提供的区间内插值。
代价同样明显:数值求解器可能多次调用导数网络,训练速度不一定优于普通网络;误差容限过严会增加计算量,过松则可能损失精度;刚性系统还可能导致普通求解器效率很低。因此,连续形式并不天然更好,是否采用取决于数据是否真的具有连续演化结构。
易混淆点
连续深度指隐藏状态随虚拟时间连续变化,不等于输入数据必须连续。残差网络与欧拉法是结构对应关系,也不意味着训练后的网络严格等价于某个真实物理系统。
神经常微分方程的参数量可以较少,但计算量由求解器调用次数决定。评价模型时应同时观察精度、函数评估次数和实际运行时间,而不能只比较层数。