
高等数学 / 系统课时
牛顿法与拟牛顿法
牛顿法与拟牛顿法
一阶方法只利用梯度判断下降方向,遇到狭长谷底时常需要许多小步。牛顿法进一步使用 Hessian 描述局部曲率,拟牛顿法则用迭代信息近似这种曲率。本课将比较三类方法的更新逻辑、成本与适用边界。
学习目标
- 理解梯度、Hessian 与牛顿步之间的关系
- 说明 BFGS 类拟牛顿法如何避免直接计算 Hessian
- 能根据参数规模和曲率条件选择一阶或二阶方法
牛顿法如何使用曲率
在当前位置 附近,对目标函数做二阶近似:
令近似模型对 的梯度为零,得到牛顿方程。
完整牛顿步为 。若采用线搜索,则使用 。工程实现通常求解线性方程,而不是显式计算 。当目标函数接近二次型且 Hessian 正定时,牛顿法能快速接近极小点;若 Hessian 不定、奇异或条件数很差,方向可能不是下降方向,需要阻尼、信赖域或线搜索进行保护。
牛顿法的主要代价来自 Hessian 的构造、存储与求解。参数数目为 时,完整 Hessian 有 个元素,因此它更适合中小规模、曲率结构明确的问题,而不是直接用于拥有海量参数的普通深度网络。
拟牛顿法如何近似曲率
拟牛顿法不直接求 Hessian,而是根据连续两次迭代得到的位移和梯度变化更新近似矩阵:
新 Hessian 近似可施加割线条件 。若实现维护逆 Hessian 近似 ,则对应条件是 ,搜索方向为 ;L-BFGS 只保存最近若干组 与 ,显著降低内存开销。
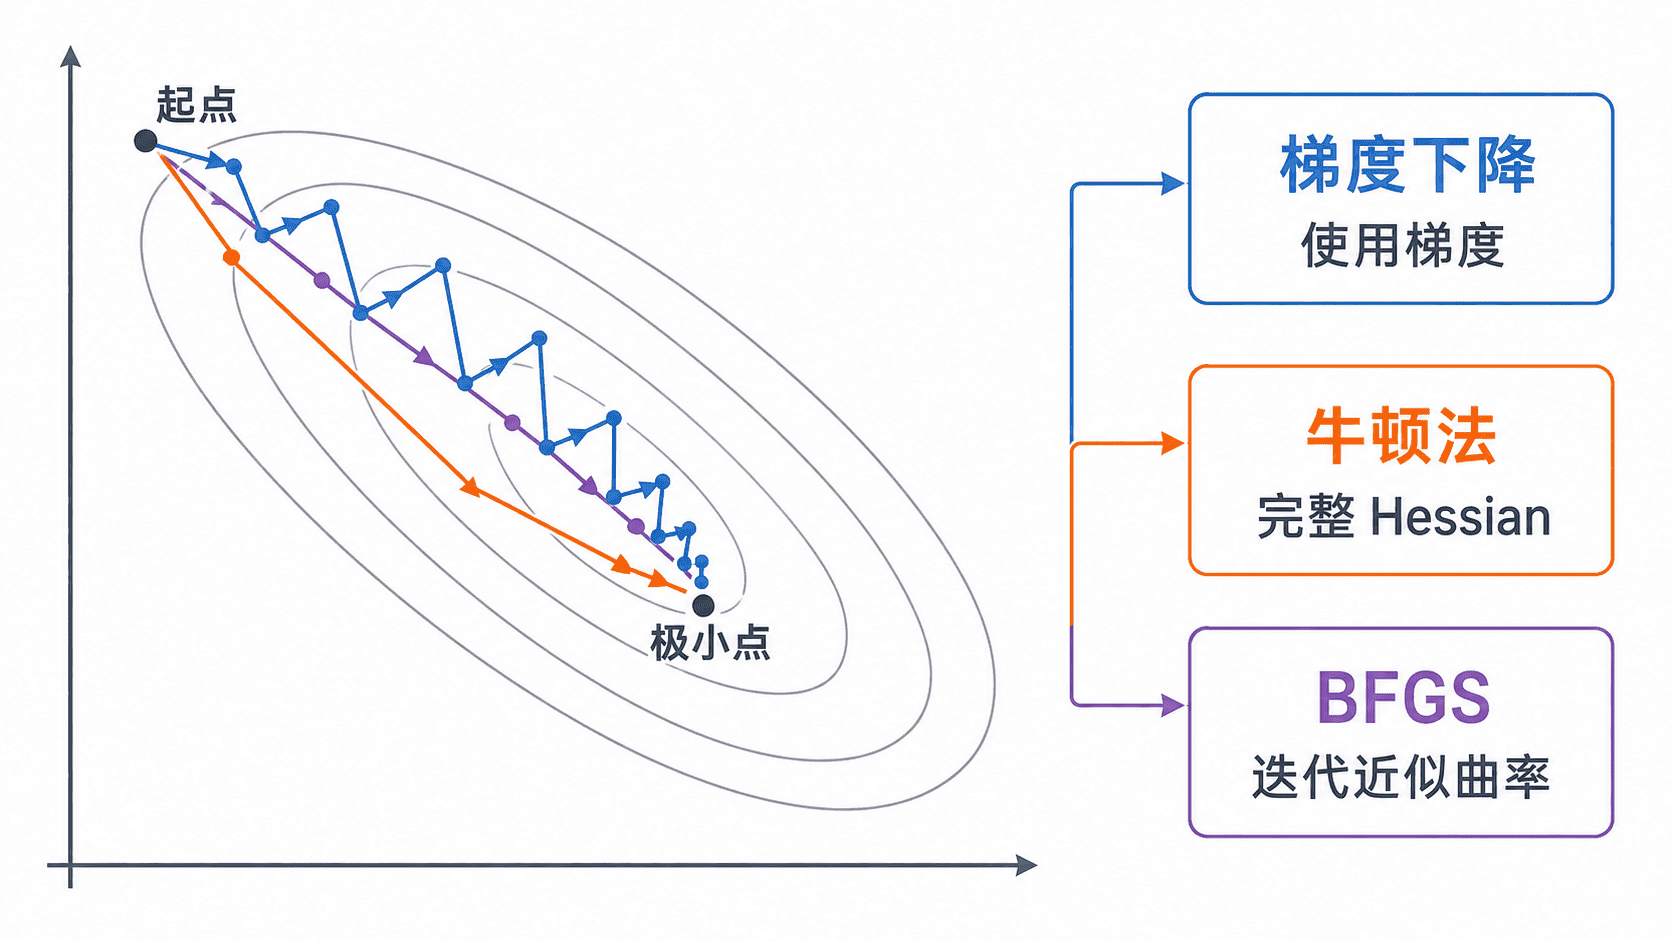
一阶方法每步便宜、扩展性强;牛顿法每步昂贵但局部收敛快;BFGS 和 L-BFGS 位于两者之间。选择时不能只比较迭代次数,还要比较单步计算、内存消耗和线搜索成本。
可运行示例:二次函数上的三种方法
下面优化函数 。这里 为对称正定矩阵,因此 Hessian 恒等于 ,完整牛顿步可一步到达唯一极小点。对这类二维二次函数,正定初始近似和精确线搜索下,BFGS 在精确算术中至多两步到达极小点。
import numpy as np

A = np.array([[1.0, 0.0], [0.0, 10.0]])
b = np.array([1.0, 1.0])
x0 = np.array([4.0, -2.0])

def grad(x):
    return A @ x - b

def gradient_descent():
    x = x0.copy()
    for _ in range(20):
        x -= 0.1 * grad(x)
    return x

def newton():
    x = x0.copy()
    # 直接求解 A p = -g,比显式计算逆矩阵更稳定
    return x - np.linalg.solve(A, grad(x))

def bfgs():
    x = x0.copy()
    # H_0^{-1}=I,后续仅用梯度变化更新近似
    h_inv = np.eye(2)
    for _ in range(2):
        g = grad(x)
        if np.linalg.norm(g) < 1e-12:
            break
        p = -h_inv @ g
        # 二次函数上使用精确线搜索
        alpha = -(g @ p) / (p @ A @ p)
        s = alpha * p
        x_next = x + s
        y = grad(x_next) - g
        rho = 1.0 / (y @ s)
        identity = np.eye(2)
        # BFGS 更新保持逆 Hessian 近似的对称性
        h_inv = (
            (identity - rho * np.outer(s, y))
            @ h_inv
            @ (identity - rho * np.outer(y, s))
            + rho * np.outer(s, s)
        )
        x = x_next
    return x

print("Gradient descent:", np.round(gradient_descent(), 6))
print("Newton:          ", np.round(newton(), 6))
print("BFGS:            ", np.round(bfgs(), 6))
print("Exact optimum:   ", np.linalg.solve(A, b))
预期输出
Gradient descent: [1.36473 0.1    ]
Newton:           [1.  0.1]
BFGS:             [1.  0.1]
Exact optimum:    [1.  0.1]
这个结果体现了二次函数上的理想情况。真实非线性问题中,牛顿法和 BFGS 通常还要配合线搜索;若出现 ,BFGS 的正定性可能无法保证,需要跳过更新、阻尼更新或调整搜索策略。