
高等数学 / 系统课时
阅读AI论文中的公式
阅读AI论文中的公式
本课给出一套可重复使用的公式阅读方法:先判断公式承担的任务,再识别随机变量、参数和约束,最后把符号还原为可执行的计算步骤,从而读懂论文而不是只看懂单个符号。
学习目标
- 区分目标函数、期望、梯度与约束在论文中的作用
- 按“对象—运算—优化”顺序拆解复杂公式
- 使用固定清单核对公式与正文、算法和实验设置
先判断公式在论文中的角色
看到公式后不要立即逐字符翻译,先阅读公式前后两段,确认作者是在定义模型、描述数据分布、提出优化目标,还是给出参数更新规则。同一个符号在不同公式中的职责可能不同,角色判断错误会让后续推导全部偏离。
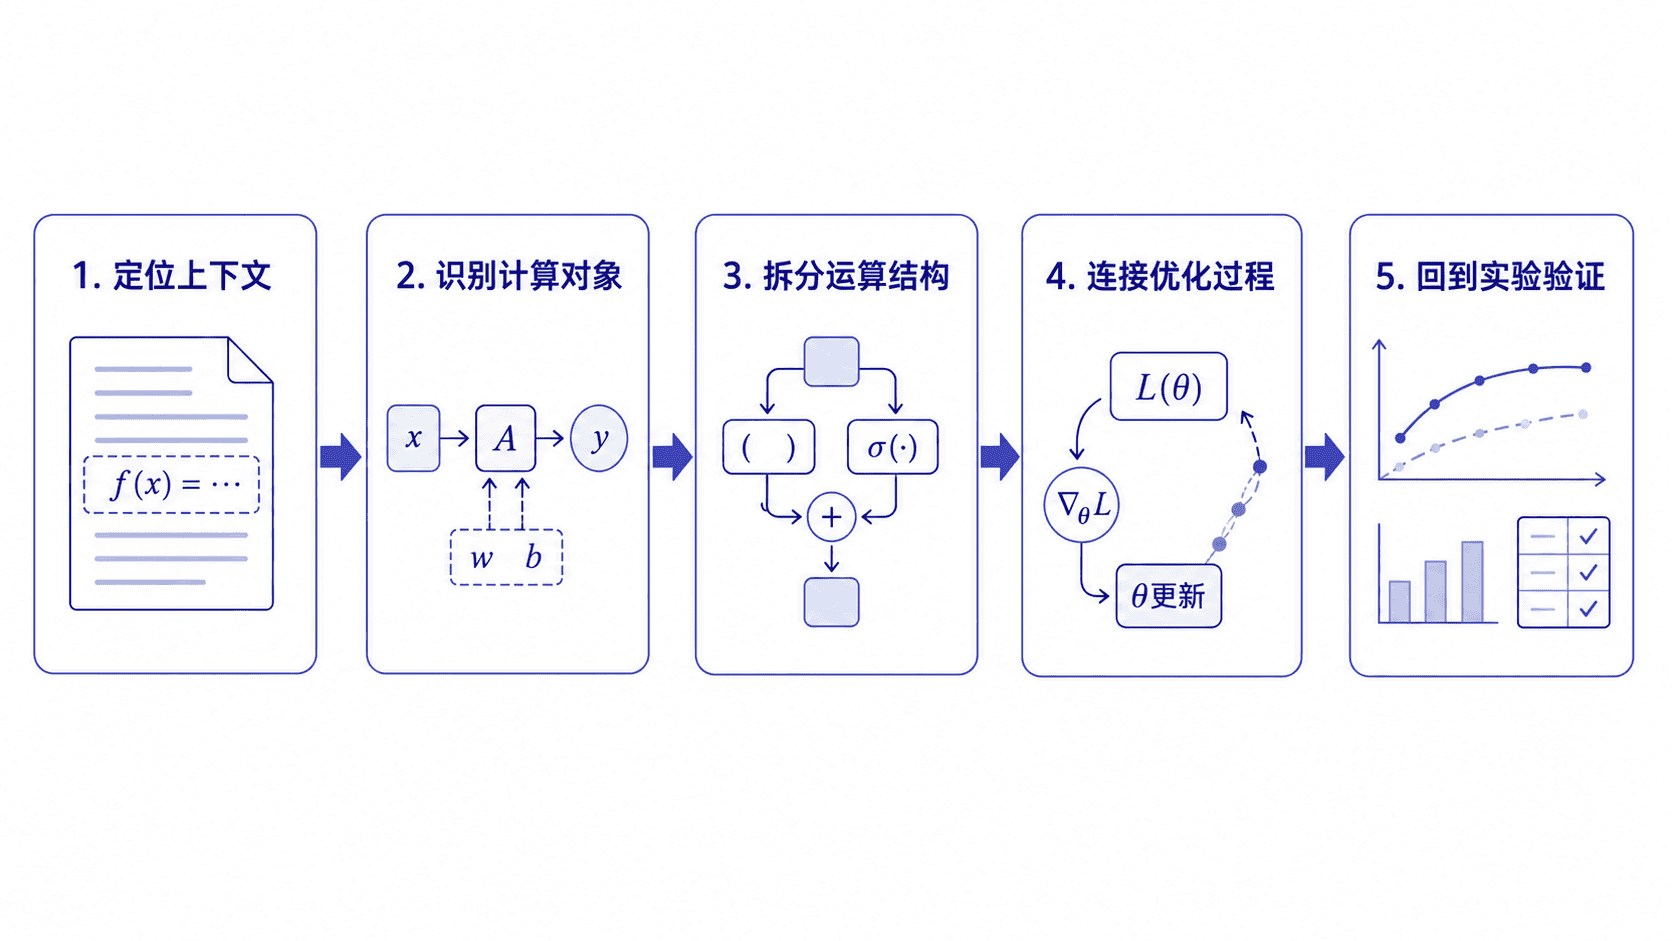
常见角色可以快速归为四类:定义式回答“对象是什么”,目标函数回答“要最小化或最大化什么”,梯度或更新式回答“参数怎样改变”,约束式回答“哪些解不允许出现”。先归类,再分析细节。
从符号表重建计算对象
以常见的监督学习目标为例:
先找可被优化的参数 ,再找数据来源 ,随后识别模型 、单样本损失 和正则项。该式为每个 定义目标值,优化任务可另写为 。最优值和能取得该值的参数是不同对象。
阅读期望时,要继续追问三个问题:随机性来自哪里、对谁取平均、实际训练怎样近似。总体分布未知时,先用训练集的均值定义经验损失。若批次从训练样本均匀抽取,给定当前参数时,批次均值是全训练集均值的无偏估计。若使用非均匀采样、类别加权或忽略掩码,还要核对相应权重及分母。常见近似写成
按计算顺序拆解优化过程
复杂公式可以按由内到外的顺序改写成口头计算流程:输入 进入模型得到预测,预测与标签 计算损失,批次内损失求平均,最后加入正则项形成目标函数。若论文随后给出更新式:
其中 表示目标函数对参数的梯度, 是学习率,当目标可微且梯度非零时,负梯度给出局部下降方向,有限步长是否降低目标仍需检验。此时应把目标函数与更新式连起来读:前者定义“好坏”,后者定义“怎样变好”。
把这个目标落实到两条样本。取 ,损失为平方误差,数据为 、。在 时,预测为 ,均方误差为 。取 ,正则项为 ,总目标为 。正则化梯度是 ,因为目标中的正则项没有 。
samples = [(1.0, 0.0), (2.0, 1.0)]
theta, regularization, learning_rate = 0.5, 0.2, 0.1
residuals = [theta * x - y for x, y in samples]
mse = sum(error**2 for error in residuals) / len(samples)
gradient = (
    2 * sum(error * x for error, (x, _) in zip(residuals, samples)) / len(samples)
    + 2 * regularization * theta
)
objective = mse + regularization * theta**2
print(f"objective={objective:.3f}, gradient={gradient:.3f}")
print(f"next_theta={theta - learning_rate * gradient:.3f}")
预期输出如下。
objective=0.175, gradient=0.700
next_theta=0.430
识别约束与隐含条件
约束通常写在目标函数右侧,例如:
这里的 s.t. 表示 subject to,即候选参数必须同时满足 。还要留意正文中的隐含条件,例如概率之和为 、协方差矩阵需半正定、输入已归一化,或某个推导仅在可微条件下成立。
论文有时会把约束转成惩罚项。此时不要只看两个公式长得不同,应分别检查原问题的可行条件、惩罚问题的最优点是否仍可行,以及等价结论所依赖的凸性、乘子或惩罚形式。
使用公式阅读检查清单
完成初步拆解后,按以下顺序回查:
- 每个符号是否在首次出现处定义,形状或维度是否一致。
- 求和、期望和梯度分别对哪些变量进行,哪些量保持不变。
- 公式与算法伪代码中的执行顺序是否一致。
- 训练目标、评估指标和论文最终报告的数值是否属于同一对象。
- 约束、近似、独立性假设和采样方式是否在正文中另有说明。
遇到无法解释的符号时,优先查看符号表、附录和算法框,而不是凭习惯猜测。若公式维度不匹配,通常意味着漏读了转置、广播、条件变量或批次维度。