
高等数学 / 系统课时
动量法
动量法
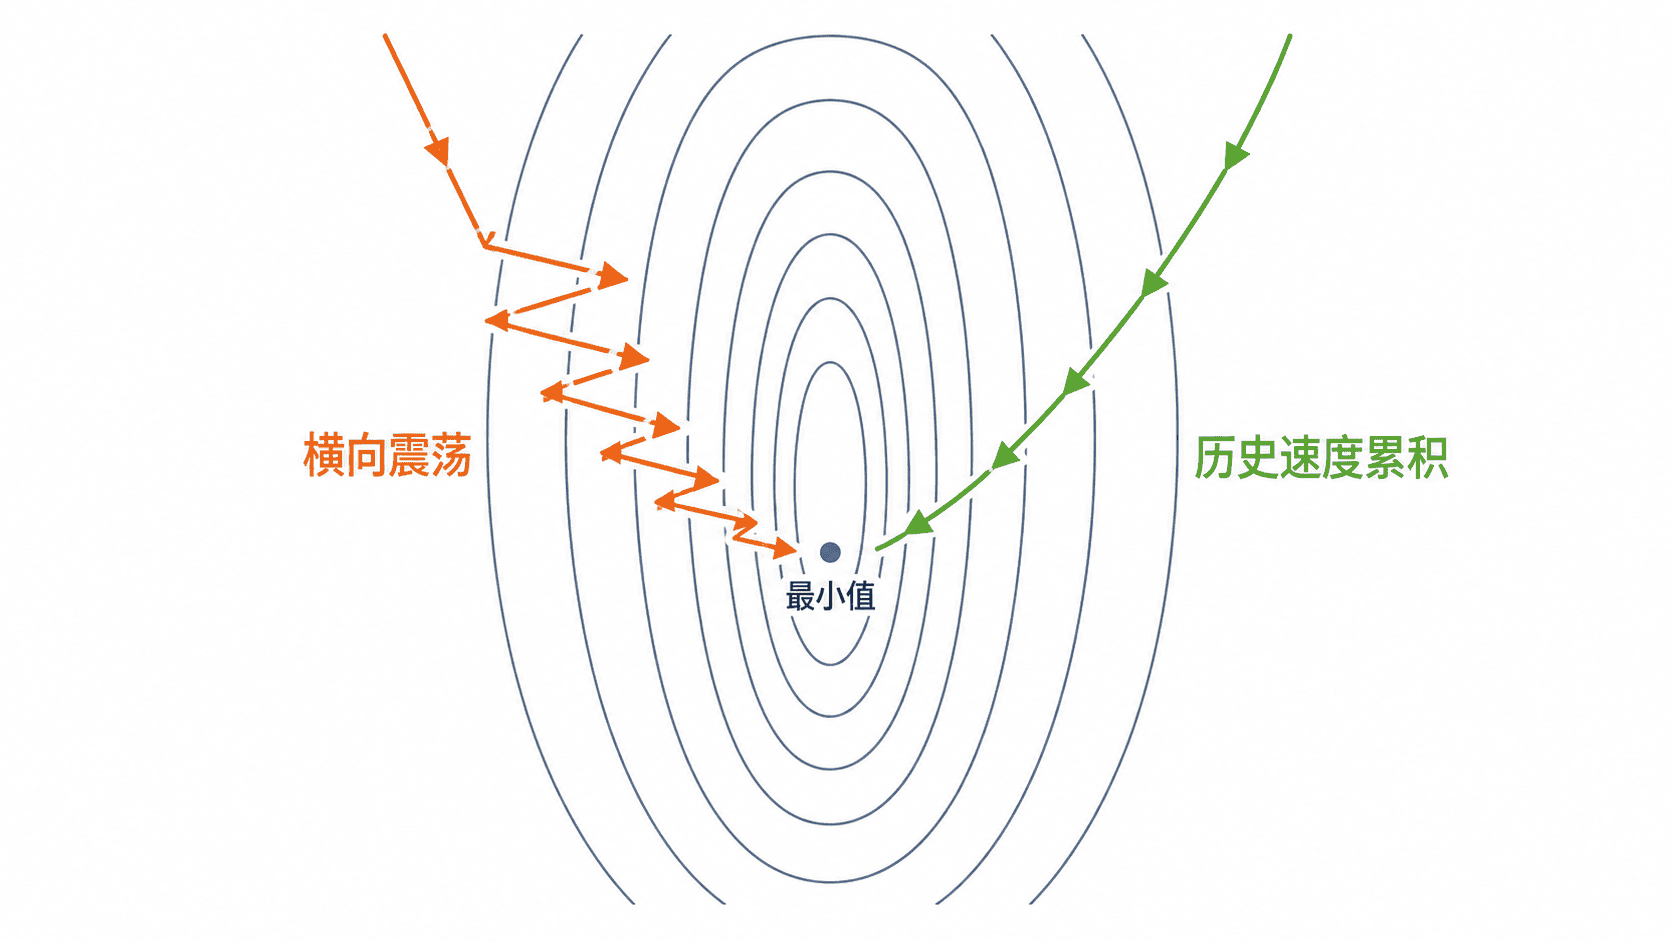
普通梯度下降只依据当前位置决定下一步,遇到狭长谷底时容易在陡峭方向反复摆动,却沿平缓方向前进缓慢。动量法把历史更新累积为速度,使持续一致的方向得到增强,并让频繁反向的分量相互抵消。
学习目标
- 理解动量变量如何保存历史更新信息
- 掌握动量法的更新公式和参数含义
- 能判断动量过大、学习率过高导致的越界与震荡
为什么普通梯度会震荡
在狭长损失曲面中,一个方向曲率很大,另一个方向曲率很小。普通梯度下降为避免在陡峭方向发散,只能使用较小学习率,于是参数常呈锯齿形穿过谷底,并在真正需要前进的平缓方向上移动缓慢。
动量可以累积同向更新。若陡方向上的梯度反复变号,历史项可能部分抵消。实际能否减弱振荡仍取决于学习率和动量系数。
动量更新规则
一种常用写法是先更新速度,再移动参数:
其中, 是学习率,决定当前梯度的影响强度; 是动量系数,控制历史速度保留比例,常取 。若迭代从 开始,则令 。当 时,公式退化为普通梯度下降。
不同资料可能把学习率放在速度外部,或把速度定义成梯度的指数平均。若学习率恒定,不带归一化的梯度累加 可以用 换写为上式。若当前梯度前另乘 ,需要相应调整学习率才会得到相同更新。学习率变化时,把它放在累加器内外也可能产生不同历史权重。
主示例:观察历史方向的累积
下面优化一维函数 。它的梯度为 。从 出发执行 10 步,比较普通梯度下降和动量法的位置。
python
def gradient(theta):
    return 0.2 * theta

def standard_gradient_descent(steps, learning_rate):
    theta = 10.0
    for _ in range(steps):
        theta -= learning_rate * gradient(theta)
    return theta

def momentum_descent(steps, learning_rate, beta):
    theta = 10.0
    velocity = 0.0

    for _ in range(steps):
        # 旧速度保留 beta 比例,再叠加当前下降方向
        velocity = beta * velocity - learning_rate * gradient(theta)
        theta += velocity

    return theta

steps = 10
learning_rate = 0.1

print(f"standard: {standard_gradient_descent(steps, learning_rate):.4f}")
print(f"momentum: {momentum_descent(steps, learning_rate, 0.9):.4f}")
预期输出
text
standard: 8.1707
momentum: 3.0712
在这个平缓函数上,连续梯度方向一致,动量不断积累,因此 10 步后更接近最小值 。不过动量可能越过最小值,后续再从另一侧返回,所以不能仅凭某一步的位置判断是否稳定。
参数选择与常见边界
| 参数或现象 | 含义与处理 |
|---|---|
| 较小 | 历史影响弱,行为接近普通梯度下降 |
| 较大 | 加速更明显,但可能越过最小值或长时间震荡 |
| 学习率过高 | 当前梯度冲击过强,动量会放大发散风险 |
| 小批量噪声 | 历史平均可平滑部分随机波动,但不能修复错误梯度 |
实践中常从 附近开始尝试,再结合损失曲线调整学习率。若损失持续增大,应优先降低学习率;若曲线周期性大幅摆动,可同时降低学习率或动量系数。
按自己的节奏,确认真正理解。