
高等数学 / 系统课时
极限与训练收敛
极限与训练收敛
模型训练会产生一串损失值、参数值和梯度值。判断训练是否“收敛”,本质上是在观察这些序列是否逐步稳定。本课用极限语言解释损失趋稳、参数靠近固定点,以及为什么停止训练不能只看损失曲线变平。
学习目标
- 能用数列极限描述训练过程中的稳定趋势
- 区分损失收敛、参数收敛与梯度趋零
- 理解常用停止训练条件及其局限
把训练看成三个序列
设第 次迭代后的参数为 ,训练损失为 ,梯度为 。训练过程可以看成三个随迭代次数变化的序列:
- 损失序列 :模型目标是否逐步稳定。
- 参数序列 :模型权重是否靠近某个固定位置。
- 梯度序列 :当前参数附近是否仍存在明显下降方向。
当存在有限值 ,使得
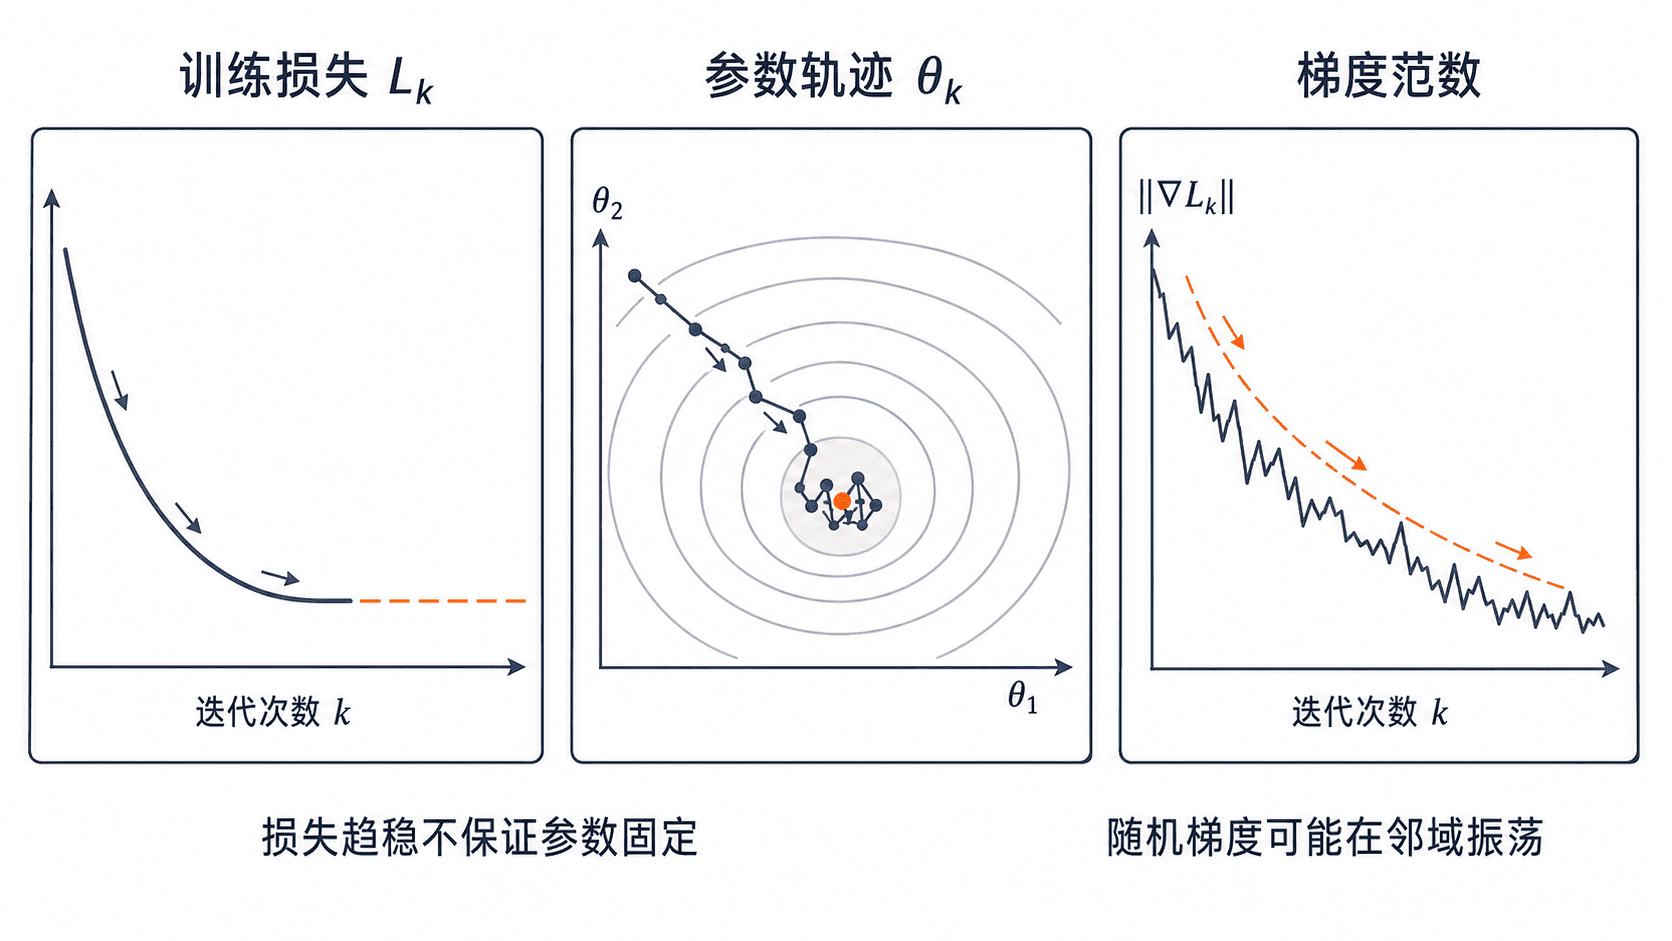
可以说损失序列收敛。但这只表示目标值趋于稳定,并不自动说明参数也收敛。
三种“收敛”并不等价
理想情况下,参数逐步接近某个固定点 :
若损失连续,则参数收敛蕴含 。梯度连续时, 趋于 ,这个值是否为零还取决于迭代规则。
例如对 使用固定学习率 ,从 出发,更新式 。参数在 与 间反复跳动,损失一直为 ,梯度范数一直为 。用下面的脚本可以同时观察三个量。
w = 1.0
for step in range(4):
    gradient = 2 * w
    print(step, w, w**2, abs(gradient))
    w -= gradient
四列依次为步数、参数、损失和梯度范数。第二列在 与 间交替,后两列始终为 和 。因此只检查损失变化,第一步就可能满足阈值,但参数还在振荡。随机梯度下降也可能在最优区域附近振荡。
固定点与优化目标
设确定性的更新规则为
那么满足 的点称为固定点。若 连续且参数序列收敛,对更新式两边取极限可知极限点是固定点。对梯度下降,更新规则是
其中 是学习率。若 固定且参数收敛,,所以 。再用梯度连续性可得极限点为驻点。若学习率本身趋于零,更新量小可能只说明步长变小,仍需独立观察梯度。但梯度为零只说明到达驻点,它可能是局部最小值、鞍点,甚至在特殊情况下是局部最大值,因此不能把“梯度趋零”直接等同于“找到全局最优解”。
如何设置停止训练条件
工程中无法等待 ,所以要把极限思想改写成有限步内可检查的阈值。常见条件包括:
- 损失变化足够小:。
- 参数变化足够小:。
- 梯度范数足够小:。
- 验证集指标连续若干轮没有改善,触发早停。
- 达到最大迭代次数,避免训练无限持续。
对小批量训练,应区分单个批次的损失和在固定评估样本上测得的损失。单次满足阈值可能只是随机波动,因此通常设置“连续若干轮满足”或使用滑动平均。对深度学习任务,验证集早停比只看训练损失更能防止过拟合。
收敛曲线的常见误判
损失下降很慢不一定表示已收敛,也可能是学习率过小;损失在固定范围内来回震荡,可能是学习率过大或小批量噪声较强;训练损失继续下降而验证损失上升,则说明模型正在过拟合,而不是训练效果继续改善。
因此,判断训练状态时至少要同时观察训练损失、验证指标和参数更新尺度。只凭一条变平的训练损失曲线,很难区分真正稳定、优化停滞和泛化恶化。