
高等数学 / 系统课时
优化问题的数学形式
优化问题的数学形式
优化的第一步不是选择算法,而是把问题写清楚。本课把目标函数、决策变量、可行域和最优解放进同一个数学表达式,并用一个可运行的梯度下降示例验证“不断降低目标值”究竟意味着什么。
学习目标
- 写出标准的最小化问题并解释各组成部分
- 区分全局最优解、局部最优解与驻点
- 将一个简单损失函数转化为可计算的优化过程
一条标准公式包含什么
若最小值可以取到,最优解满足
是决策变量,表示可以调整的参数; 是目标函数,用一个数衡量方案好坏; 是可行域,规定允许选择哪些变量; 表示所有使目标函数取得最小值的可行点,集合可能为空。例如 在实轴上的下确界是零,但没有有限的 能取到零。
在无约束优化中,通常取 。这里的“无约束”不是没有目标或边界条件,而是没有额外的等式、不等式约束,变量可在整个参数空间内搜索。
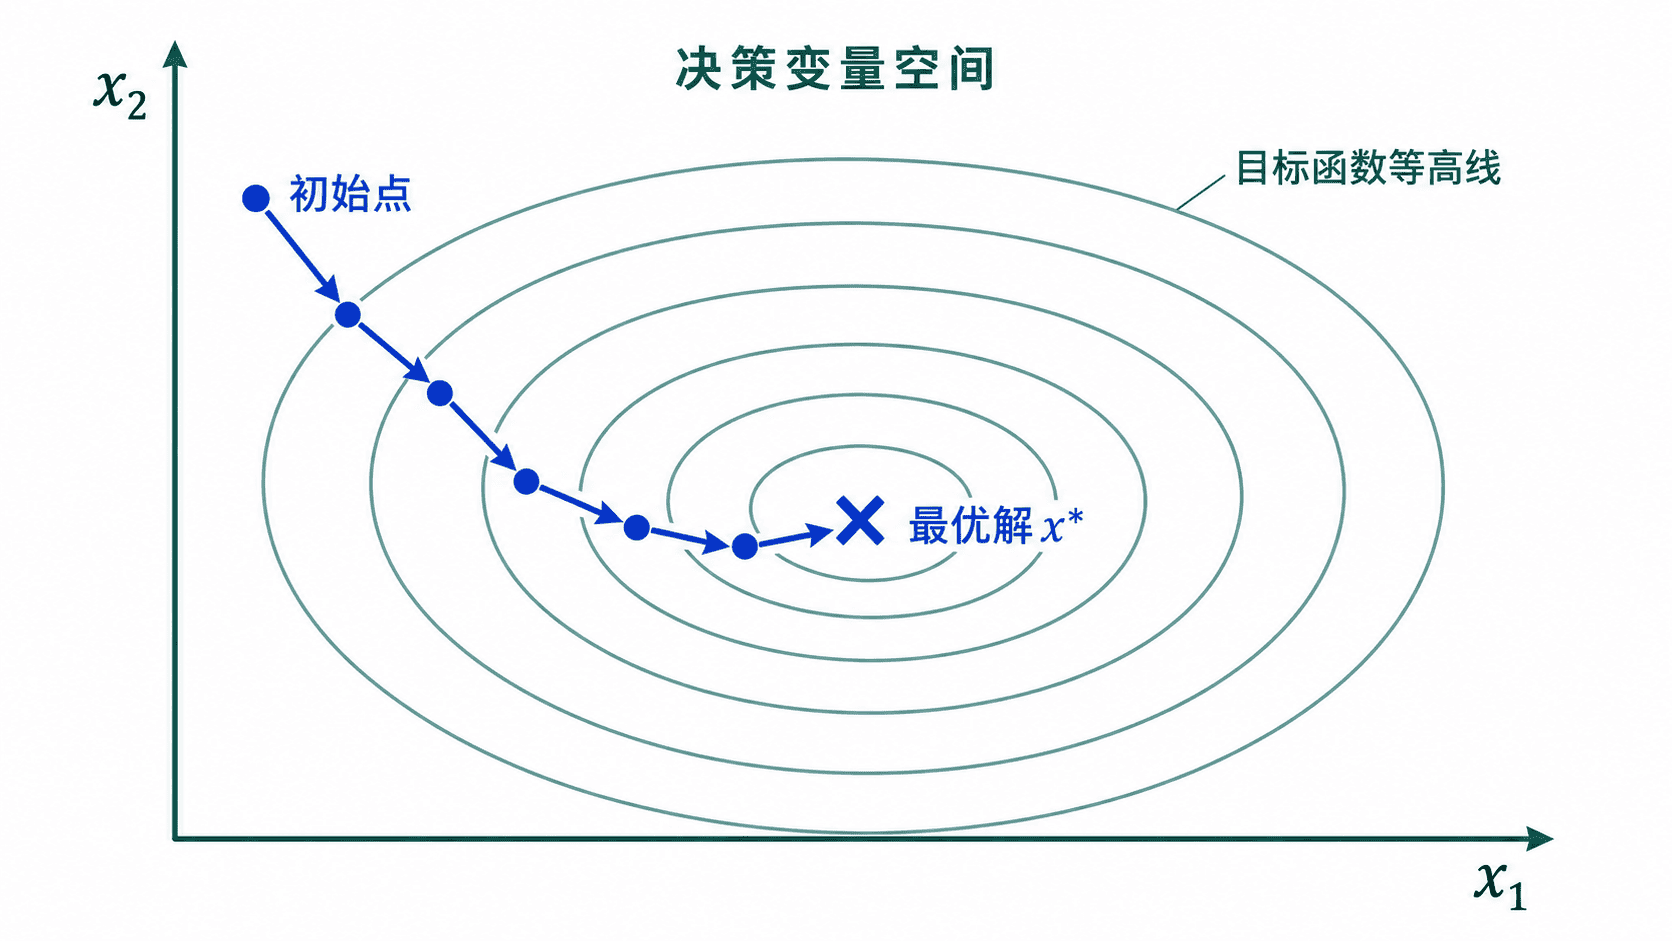
从机器学习损失到优化问题
训练模型时,决策变量通常是参数 ,目标函数是损失函数。以均方误差为例:
训练过程就是寻找 。数据和模型结构决定目标函数的形状,优化算法只负责在这个形状上寻找更低的位置。
主示例:用梯度下降求最小值
下面最小化函数 。其导数为 ,每次沿负梯度方向更新变量。
def objective(x: float) -> float:
    return (x - 3) ** 2 + 1

def gradient(x: float) -> float:
    return 2 * (x - 3)

x = -4.0
learning_rate = 0.1

# 重复沿负梯度方向移动,使目标函数逐步下降
for _ in range(20):
    x -= learning_rate * gradient(x)

print(f"x = {x:.6f}")
print(f"f(x) = {objective(x):.6f}")
预期输出
x = 2.919295
f(x) = 1.006513
理论最优解是 ,最小值为 。示例只迭代 20 次,因此结果已接近最优点但尚未完全到达;继续迭代会让误差进一步缩小。
最优解不止一种说法
全局最优解在整个可行域内都不比任何其他点差;局部最优解只在某个邻域内最好。驻点满足 ,但它可能是极小值、极大值或鞍点,因此“梯度为零”只是候选条件,不等于已经找到最优解。
当目标函数在凸可行域上是凸函数时,任意局部最小点都是全局最小点;非凸问题则可能包含多个局部极小值和鞍点。神经网络训练通常属于非凸优化,所以初始化、学习率和优化器都会影响最终到达的位置。
建模时的检查顺序
先确认哪些量可以被算法调整,再定义一个可比较的标量目标,最后写清变量的取值范围。若目标函数方向写反,例如本应最小化损失却误写成最大化,就会让后续算法完全偏离业务目的。
还应检查最优解是否存在、是否唯一,以及目标函数能否计算梯度。这些性质决定应使用解析方法、梯度法,还是无梯度搜索方法。