
高等数学 / 系统课时
AI工程师为什么要学高等数学
AI工程师为什么要学高等数学
本课从模型训练中的损失函数、梯度下降、反向传播和连续建模出发,说明高等数学并不是为了手算复杂题,而是为了读懂模型如何学习、判断训练是否正常,并能在工程中选择合适的优化方法。
学习目标
- 说清函数、导数、积分在模型训练中的职责
- 理解梯度下降与反向传播为什么依赖微分
- 判断AI工程中需要掌握高等数学的深度
数学在训练链路中的位置
一个监督学习任务通常先把输入送入模型,得到预测结果,再用损失函数衡量预测与真实答案的差距。训练过程不断调整参数,使损失逐步下降。高等数学主要负责描述“误差如何随参数变化”,并给出下一步应该往哪个方向调整。
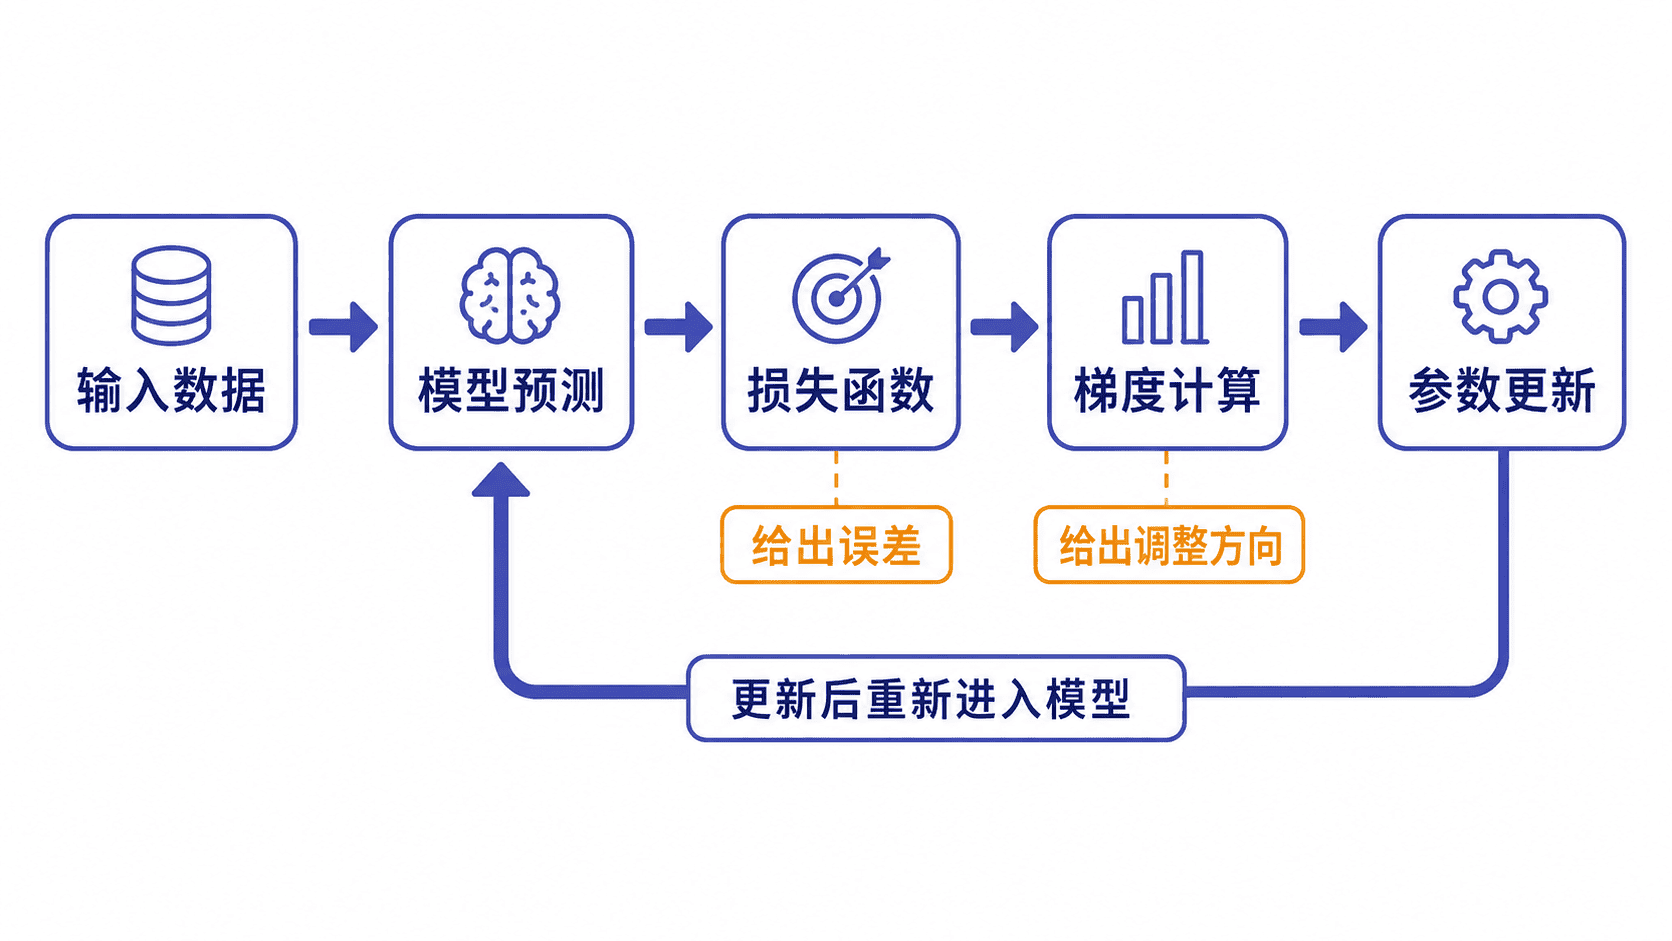
可以把训练理解为在一张起伏的地形图上寻找最低点。损失函数给出当前位置的高度,在欧氏距离下,非零梯度给出局部上升最快的单位方向。对于可微损失,沿反方向取足够小的正步长会让损失下降。一次更新跨得很远时,当前位置的梯度不能保证更新后的损失下降。常见更新形式为 ,其中 是学习率。
四类核心知识分别解决什么
函数用于描述输入、参数与输出之间的关系,例如神经网络本质上是多个函数的组合。极限用于讨论变量无限接近某个值时的趋势,是连续性和导数的基础。
导数与偏导数刻画输出对变量的敏感程度。模型包含大量参数时,需要用梯度同时表示损失对各参数的变化率。积分则用于累积连续量,在概率密度、期望、连续时间模型和部分生成模型中经常出现。
多元微积分把单变量方法扩展到参数向量。最优化进一步研究如何在约束、噪声和非凸条件下找到更好的参数,这直接对应优化器、学习率和收敛性问题。
梯度下降与反向传播
梯度下降负责回答“参数下一步怎么改”。若某个参数的偏导数为正,增大它会让损失上升,就应适当减小;若偏导数为负,则可以适当增大。学习率过大可能来回震荡,过小则训练缓慢。用同一个二次损失 从 出发,比较两个学习率,便能把方向和步长的作用分开观察。
def losses(rate: float) -> list[float]:
    w = 0.0
    values = [(w - 3) ** 2]
    for _ in range(3):
        w -= rate * 2 * (w - 3)
        values.append((w - 3) ** 2)
    return values


small = losses(0.25)
large = losses(1.1)
assert small == [9.0, 2.25, 0.5625, 0.140625]
assert all(a < b for a, b in zip(large, large[1:]))
print(small)
print([round(value, 6) for value in large])
两组更新都使用当前位置的负梯度。第一组每步把参数到最优点的距离减半。第二组每步越过最优点,并把距离放大到原来的 1.2 倍。这里损失增长的原因是步长,后续可通过损失曲线和梯度诊断区分它与求导错误。
反向传播负责高效计算梯度。神经网络由多层函数复合而成,直接逐参数计算代价很高。链式法则把总变化拆成各层局部变化,再从输出层向输入层依次传递,因此一次反向过程就能得到大量参数的梯度。
工程师需要学到什么程度
AI工程师不必追求复杂证明,但要能看懂函数、导数、偏导、梯度、积分和常见优化公式,知道符号对应的工程含义,并能通过损失曲线、梯度大小和学习率表现判断训练问题。
当出现损失不下降、梯度爆炸、梯度消失或优化器不稳定时,高等数学能帮助你区分是数据问题、模型结构问题,还是参数更新机制出了问题。只会调用框架可以完成训练,理解数学才能解释训练行为并做出可靠调整。