
高等数学 / 系统课时
Softmax分类器
Softmax分类器
本课把一组任意实数分类得分转换为可解释的概率,并将 Softmax 与交叉熵连成一个可训练的多分类模型。完成后,你能写出稳定实现,并直接判断每个类别得分应被怎样调整。
学习目标
- 理解 Softmax 如何把 logits 映射为概率分布
- 推导交叉熵对 logits 的梯度
- 使用数值稳定写法实现并验证分类器
从分类得分到概率
设模型输出 个类别得分 ,这些值称为 logits。Softmax 对每个得分取指数并归一化:
得到的每个 都在 0 到 1 之间,且总和为 1。较大的 logit 会获得更高概率,但所有类别仍会共同参与归一化,因此某一类得分上升也会压低其他类别的概率。
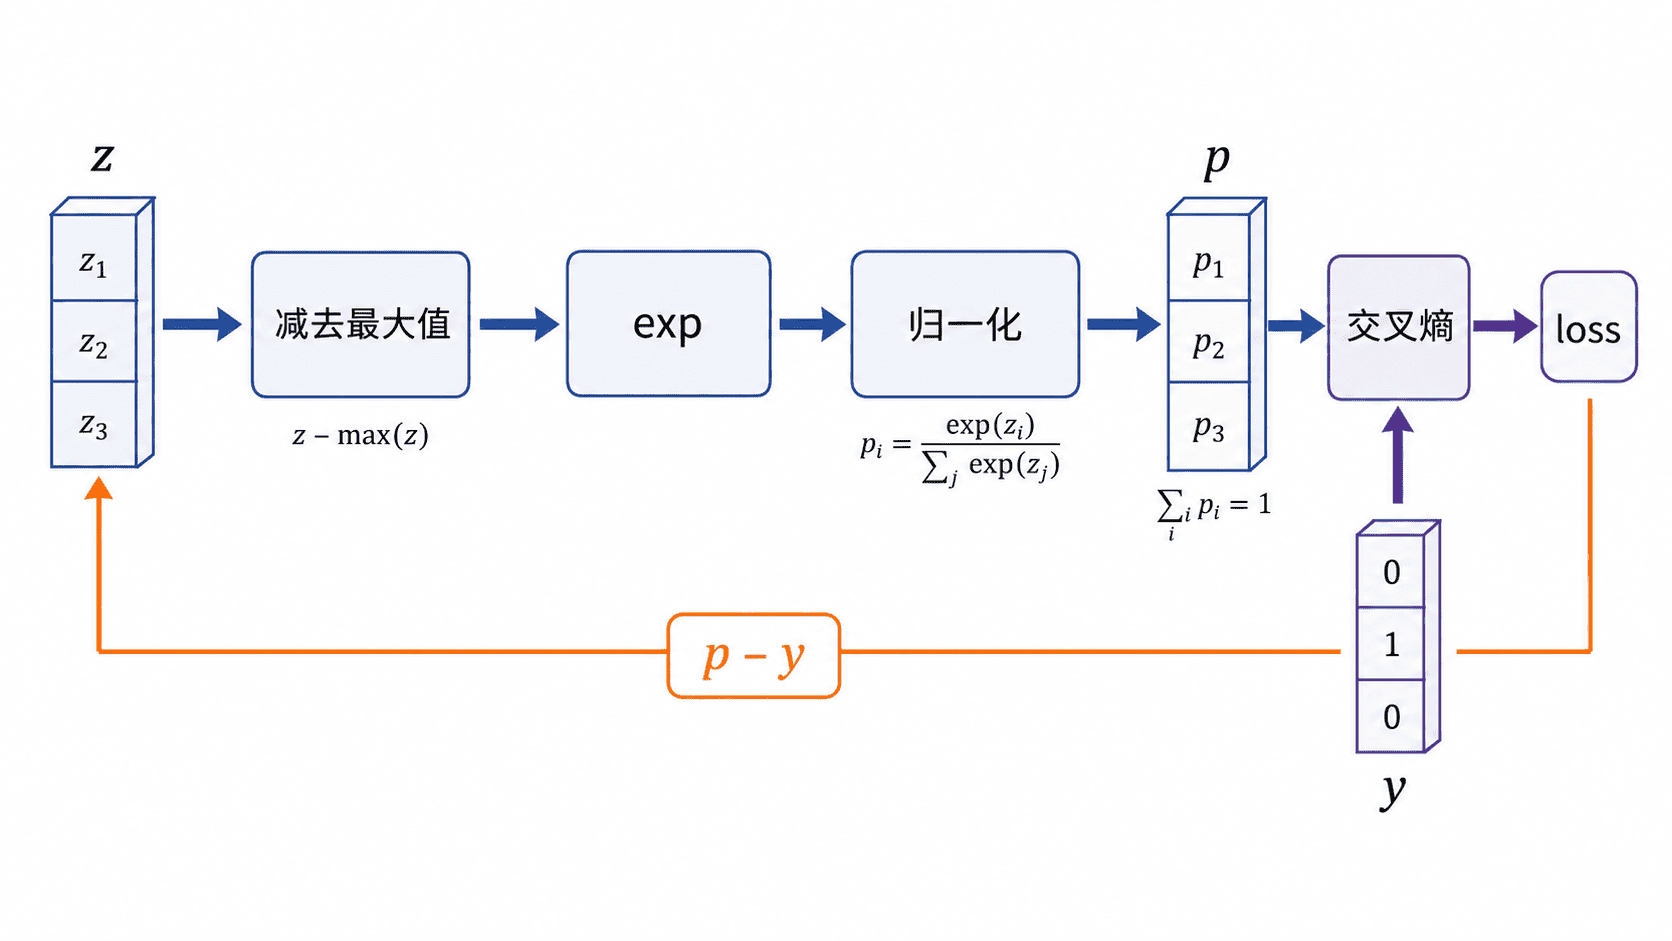
Softmax 对所有 logits 同时加上同一个常数不敏感。工程实现通常先计算 ,再取指数。这样概率不变,却能避免较大正数在指数运算中上溢。
交叉熵如何衡量分类误差
若真实类别使用 one-hot 向量 表示,交叉熵为:
因为只有真实类别位置的 等于 1,损失也可写成 ,其中 是真实类别。真实类别概率越接近 1,损失越接近 0;若模型把真实类别概率压得很低,损失会快速增大。
梯度为何简化为 p-y
Softmax 的局部导数同时包含同类和异类影响:
把它与交叉熵的导数按链式法则合并后,可得到非常紧凑的结果:
这意味着真实类别位置的梯度通常为负,梯度下降会提高该类 logit;其他类别位置的梯度为正,更新会降低它们的 logit。所有分量之和为 0,也符合 Softmax 对整体平移不敏感的性质。
可运行实现与验证
下面用 NumPy 完成单样本、三分类计算。先用平移后的 logits 计算对数归一化项,再减去平移后的目标 logit。梯度由概率减去 one-hot 标签得到。
import numpy as np

logits = np.array([2.0, 1.0, 0.1])
target = 0

# 平移 logits,避免指数上溢,同时保持概率不变
shifted = logits - np.max(logits)
exp_values = np.exp(shifted)
probabilities = exp_values / np.sum(exp_values)

# 从平移后的 logits 直接求交叉熵
loss = np.log(np.sum(exp_values)) - shifted[target]

# p - y:先复制概率,再在真实类别位置减 1
gradient = probabilities.copy()
gradient[target] -= 1.0

print("probabilities:", np.round(probabilities, 6))
print("loss:", round(float(loss), 6))
print("gradient:", np.round(gradient, 6))
预期输出
probabilities: [0.659001 0.242433 0.098566]
loss: 0.41703
gradient: [-0.340999  0.242433  0.098566]
输出表明第 0 类已经概率最高,但仍未达到 1,因此其梯度为负;另外两类梯度为正。三个梯度相加约等于 0,说明结果与理论一致。
训练中的关键边界
批量训练时,logits 通常形如 ,应沿类别维计算最大值、指数和归一化,并根据约定对样本损失求和或求平均。真实标签必须是 到 的整数。手写 NumPy 代码应显式校验范围,因为负下标会从数组尾部索引。
实际框架常把 Softmax 与交叉熵融合成一个算子,直接从 logits 计算损失。这样可以避免对已下溢为零的概率取对数。例如 logits 为 、目标类为 时,平移后的 logits 是 ,算得损失约为 ,即使目标类概率已舍入为零。推理需要概率时可单独执行 Softmax。