
高等数学 / 系统课时
连续模型与离散计算
连续模型与离散计算
数学常用连续函数描述时间、位置和损失的平滑变化,但计算机只能保存有限数量、有限精度的数据。本课将建立从连续模型到离散采样、数值近似和迭代计算的完整认识,并说明近似误差从何而来。
学习目标
- 区分连续模型、离散数据与有限精度表示
- 理解采样间隔如何影响信息保留和计算成本
- 认识数值积分、迭代优化中的近似思想
连续模型描述什么
连续模型假设自变量可以在某个区间内取任意实数。例如,函数 可以描述温度随时间变化,也可以描述神经网络损失随参数变化。即使只观察两个相邻位置,理论上它们之间仍存在无限多个可取点。
连续函数也可能有尖点。例如绝对值函数在零点连续,但零点左右斜率不同,因此在那里不可导。阶跃函数则在跳变点不连续。判断一个模型是否连续,关注的是输入发生足够小的变化时,输出能否保持足够小的变化。
计算机如何处理连续对象
计算机无法保存一个区间内的无限多个值,只能选择有限采样点。设连续信号为 ,采样间隔为 ,计算机实际保存的是
采样间隔越小,离散数据通常越接近原连续对象,但存储量和计算量也会增加。采样间隔过大时,不同频率可能产生完全相同的离散序列。以每秒 8 次采样两个零初相的余弦波为例,3 Hz 和 5 Hz 的采样值满足 ,其中 是整数。只看这些样本无法区分两者,这就是混叠。
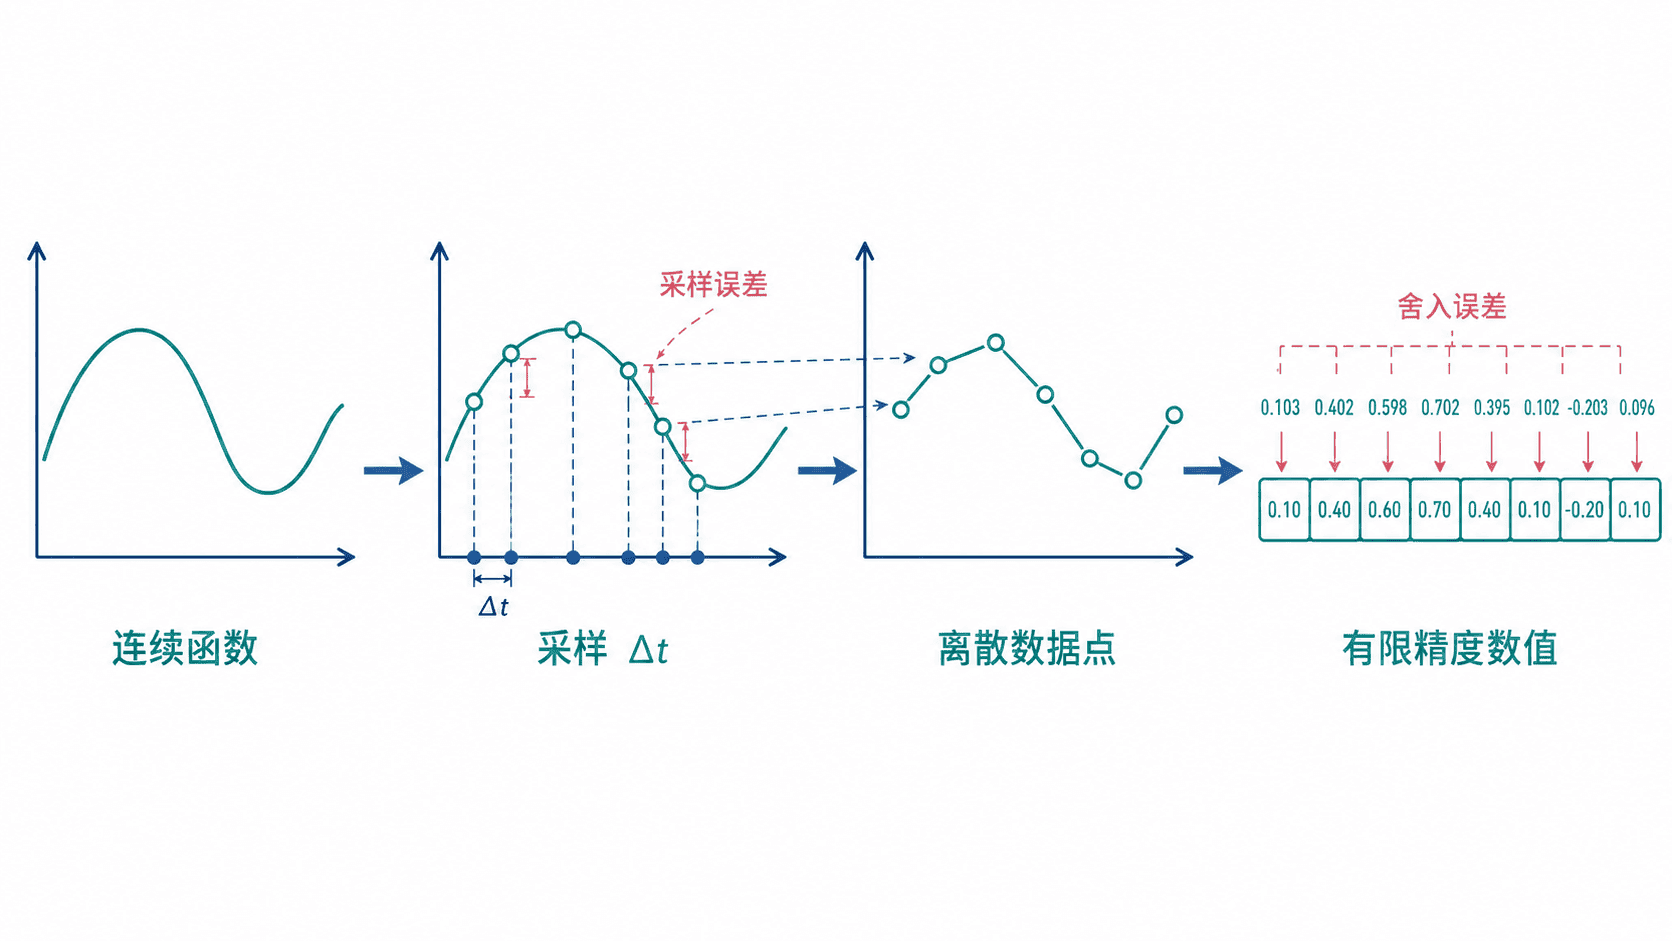
有限精度带来的误差
实数在数学中可以拥有无限小数位,但计算机通常用浮点数近似保存。像 这样的十进制小数,在二进制中可能无法有限表示,因此连续进行加减乘除时会产生微小舍入误差。
这类误差通常不会让单次计算完全失效,却可能在大量迭代中累积。比较近似计算结果时,可按误差预算选择绝对和相对容差。例如 Python 的 math.isclose(a, b, rel_tol=1e-9, abs_tol=1e-12) 同时考虑数值的量级和接近零时的误差。离散标记、计数等需要精确比较的量仍应按相应数据类型检查。
从积分到有限求和
积分表示连续区间上的累积量,但程序通常通过有限个小区间进行近似。将区间 划分为 份,宽度为 ,矩形近似可写成
当划分更细时,结果一般会更准确,但计算次数也随之增加。数值计算的核心并不是完全消除误差,而是在精度、时间和资源之间选择合理平衡。
迭代算法如何逼近答案
AI 训练中的梯度下降也属于离散迭代。理论上,参数可以沿连续轨迹变化;实际程序则按固定步骤更新:
其中 是离散迭代次数, 是学习率。学习率过大可能越过较优位置,过小则收敛缓慢。因此,离散步长不仅影响速度,也影响算法能否稳定接近目标。