
高等数学 / 系统课时
反向传播推导
反向传播推导
本课用一个“单输入、单隐藏神经元、单输出”的网络完整推导梯度。你会看到链式法则如何把损失从输出端逐层传回,并最终得到每个权重与偏置的更新依据。
学习目标
- 写出前向传播中各中间变量的计算关系
- 用链式法则推导权重和偏置的梯度
- 用数值程序验证手工推导结果
建立计算图与前向传播
设输入为 ,真实标签为 。隐藏层和输出层都使用 Sigmoid 激活函数,损失函数使用平方误差:
前向传播按 计算。反向传播则沿相反方向,把每个运算节点的局部导数逐段相乘。
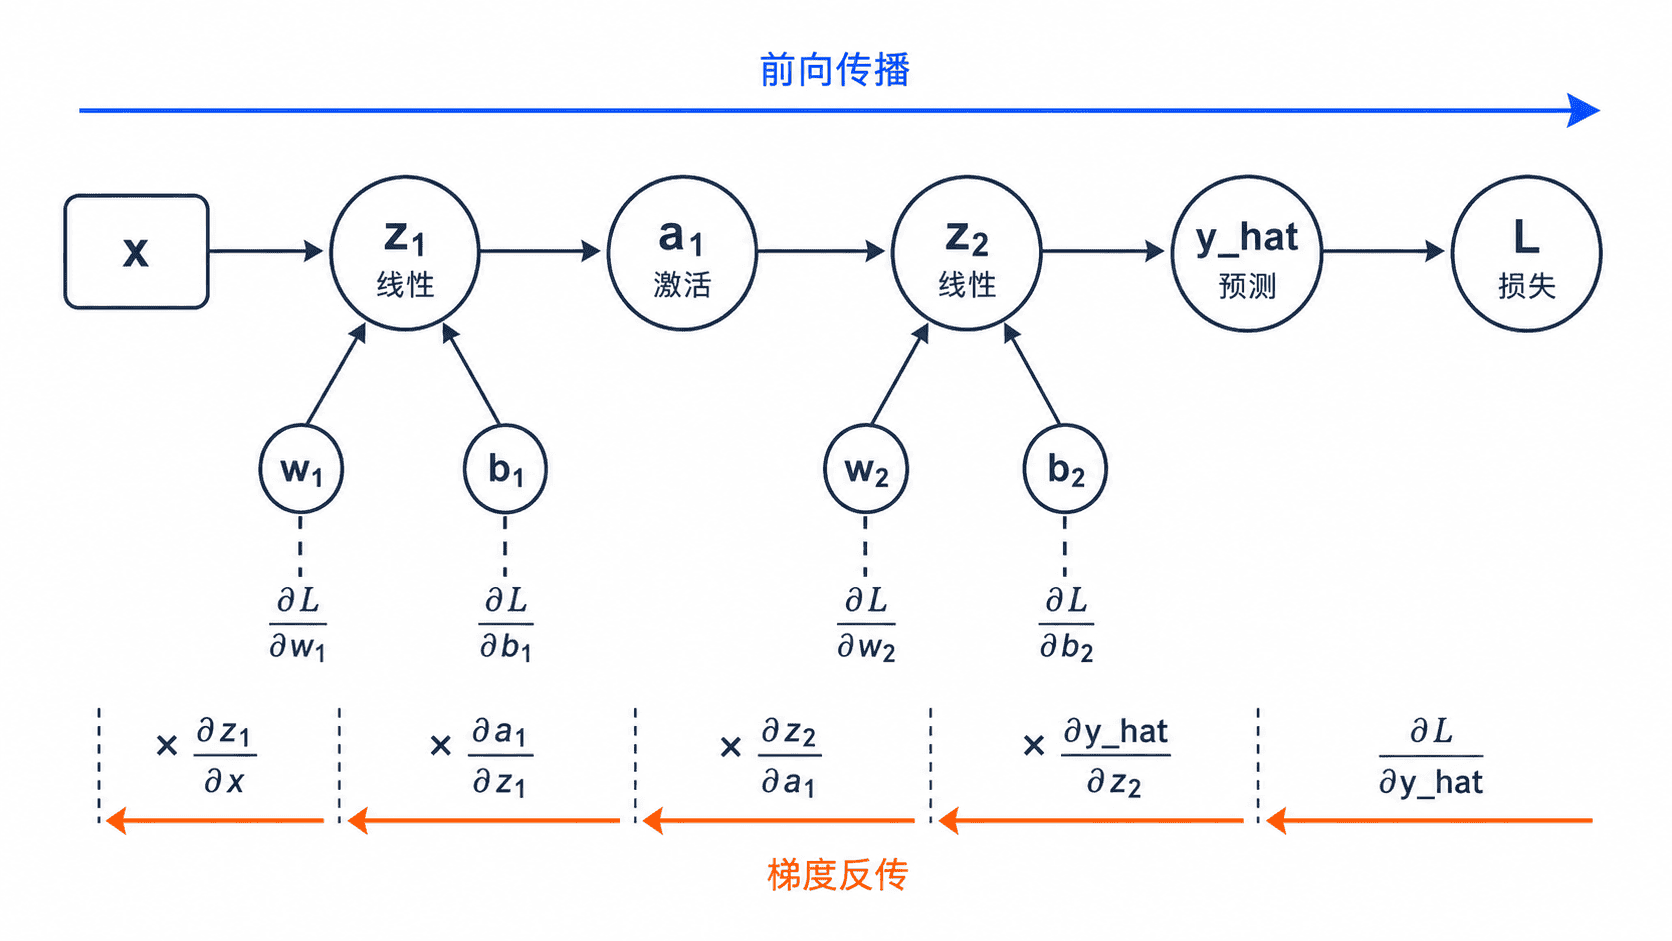
逐层推导参数梯度
先从损失对预测值的导数开始:
Sigmoid 的导数为 ,因此输出层误差信号是:
因为 ,输出层参数梯度为:
梯度继续经过输出权重 和隐藏层激活函数,形成隐藏层误差信号:
再利用 ,得到:
偏置梯度不再乘输入,是因为仿射表达式对偏置的导数为 。这里的误差信号以半平方误差为前提,换损失函数时要重新计算输出端的导数。整个过程可以概括为:接收上游梯度,乘当前节点的局部导数,再把结果传给更早的节点。
程序验证与易错点
下面的完整 Python 示例按上述公式计算前向结果和四个参数的梯度。
python
import math

def sigmoid(value: float) -> float:
    weight = math.exp(-abs(value))
    return 1.0 / (1.0 + weight) if value >= 0 else weight / (1.0 + weight)

x, y = 2.0, 1.0
w1, b1 = 0.5, 0.1
w2, b2 = -0.3, 0.2

# 前向传播保留中间值,供反向传播直接复用
z1 = w1 * x + b1
a1 = sigmoid(z1)
z2 = w2 * a1 + b2
y_hat = sigmoid(z2)
loss = 0.5 * (y_hat - y) ** 2

# 从输出层误差信号开始逐层反传
delta2 = (y_hat - y) * y_hat * (1.0 - y_hat)
grad_w2 = delta2 * a1
grad_b2 = delta2
delta1 = delta2 * w2 * a1 * (1.0 - a1)
grad_w1 = delta1 * x
grad_b1 = delta1

print(f"loss={loss:.6f}")
print(f"grad_w1={grad_w1:.6f}, grad_b1={grad_b1:.6f}")
print(f"grad_w2={grad_w2:.6f}, grad_b2={grad_b2:.6f}")
预期输出:
text
loss=0.128154
grad_w1=0.014227, grad_b1=0.007113
grad_w2=-0.094943, grad_b2=-0.126547
不要把反向传播和参数更新混为一步。反向传播只计算梯度,梯度下降再执行 。手工推导时也不要跳过中间变量;分别写出 、、 和 ,能显著减少漏乘局部导数的错误。
按自己的节奏,确认真正理解。