
高等数学 / 系统课时
分析训练失败案例
分析训练失败案例
模型训练失败时,盲目更换优化器或重复调参很难找到根因。本课建立一条从数值异常到学习率、梯度和激活分布的排查链,并用可运行脚本把日志指标转换为具体修复方向。
学习目标
- 按稳定顺序检查训练失败信号
- 根据学习率、梯度范数和激活范围推断根因
- 使用修复前后对照验证问题是否真正解决
建立排查顺序
排查应从最确定、最致命的信号开始。先确认损失、梯度和激活中是否出现 NaN 或 Inf;再观察参数相对更新量是否过大;随后检查梯度是爆炸、消失还是持续震荡;最后定位到具体层的激活分布和输入范围。参数相对更新量可按实际更新前后的差计算。
防止除零。只有在没有动量、裁剪、权重衰减等其他项的普通 SGD 中,更新分子才直接等于 。若参数范数接近零,还应查看绝对更新量,因为此时相对量对分母很敏感。
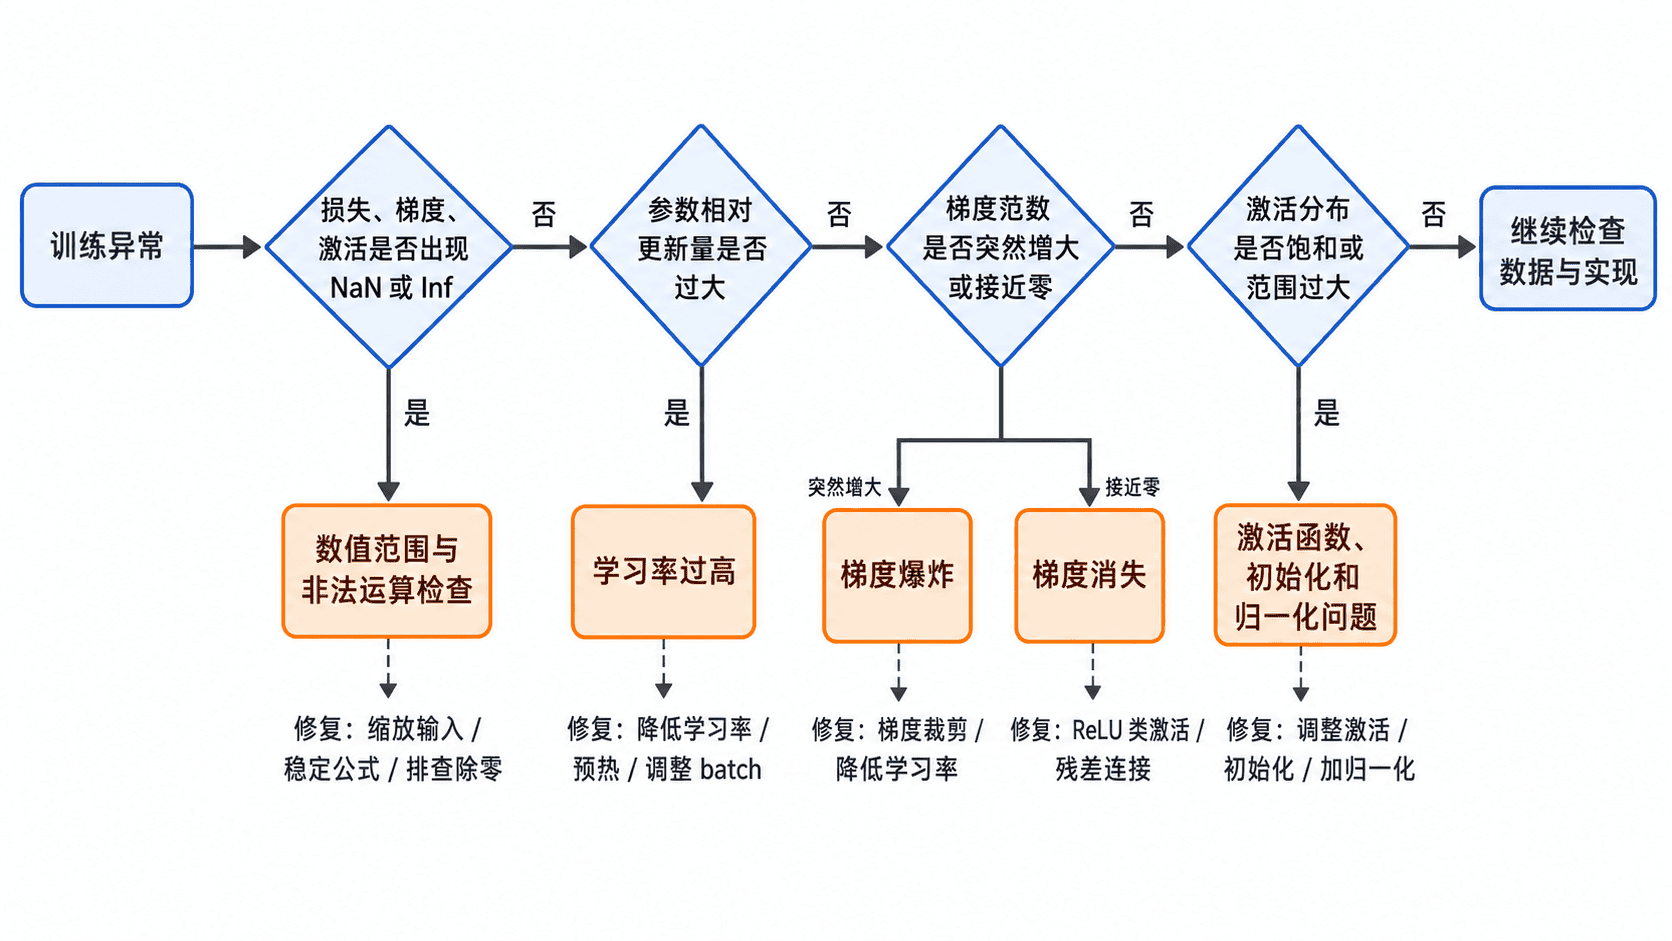
四类信号如何对应根因
| 观察信号 | 常见表现 | 优先检查 |
|---|---|---|
| 学习率或相对更新量过大 | 损失剧烈震荡,训练刚开始就恶化 | 降低学习率、增加预热、核对损失缩放 |
| 梯度范数持续增大 | 参数迅速发散,随后出现 Inf |
初始化、深层连乘、除法和指数运算 |
| 梯度范数长期接近零 | 损失几乎不变,前层参数不更新 | 饱和激活、过深链路、错误的停止梯度 |
| 激活范围异常 | 某层输出极大、全零或集中在边界 | 输入标准化、激活函数、归一化层位置 |
梯度裁剪限制传入优化器的梯度范数。实际更新还可能受到动量、自适应缩放等因素影响。它适合作为保护措施,但仍要继续追踪第一个出现异常的层。
完整诊断示例
下面的脚本接收训练快照,并按照固定优先级输出诊断。示例阈值用于演示,实际项目应根据模型规模和正常训练区间校准。
from dataclasses import dataclass
import math

@dataclass
class Snapshot:
    epoch: int
    loss: float
    learning_rate: float
    grad_norm: float
    parameter_norm: float
    activation_abs_max: float
    update_norm: float

def diagnose(snapshot: Snapshot) -> list[str]:
    values = (
        snapshot.loss,
        snapshot.grad_norm,
        snapshot.parameter_norm,
        snapshot.activation_abs_max,
        snapshot.learning_rate,
        snapshot.update_norm,
    )

    # 非有限值优先级最高,后续比例计算已经失去意义
    if not all(math.isfinite(value) for value in values):
        return ["出现 NaN/Inf:先排查溢出、除零和无效对数"]

    if any(value < 0 for value in values[1:]):
        raise ValueError("norms and learning rate must be nonnegative")

    issues: list[str] = []
    update_ratio = snapshot.update_norm / max(snapshot.parameter_norm, 1e-12)

    if snapshot.activation_abs_max > 1e4:
        issues.append(
            f"激活绝对值上限 {snapshot.activation_abs_max:.3e}:激活范围异常"
        )
    if snapshot.grad_norm > 100:
        issues.append(f"梯度范数 {snapshot.grad_norm:.3e}:可能发生梯度爆炸")
    if update_ratio > 0.1:
        issues.append(f"参数相对更新量 {update_ratio:.3e}:核对实际步长")
    if snapshot.grad_norm > 1e-8 and snapshot.update_norm == 0:
        issues.append("梯度非零但更新为零:核对优化器是否执行")

    return issues or ["当前快照未发现明显数值异常"]

def main() -> None:
    snapshots = [
        Snapshot(1, 2.30, 0.5, 8.0, 2.0, 12.0, 4.0),
        Snapshot(2, 6.80, 0.5, 120.0, 2.0, 1e5, 60.0),
        Snapshot(3, float("inf"), 0.5, float("inf"), 2.0, float("inf"), 0.0),
        Snapshot(4, 2.30, 0.5, 8.0, 2.0, 12.0, 0.0),
    ]

    for snapshot in snapshots:
        print(f"Epoch {snapshot.epoch}")
        for issue in diagnose(snapshot):
            print(f"  - {issue}")

if __name__ == "__main__":
    main()
预期输出
Epoch 1
  - 参数相对更新量 2.000e+00:核对实际步长
Epoch 2
  - 激活绝对值上限 1.000e+05:激活范围异常
  - 梯度范数 1.200e+02:可能发生梯度爆炸
  - 参数相对更新量 3.000e+01:核对实际步长
Epoch 3
  - 出现 NaN/Inf:先排查溢出、除零和无效对数
Epoch 4
  - 梯度非零但更新为零:核对优化器是否执行
这段程序不替代框架监控,而是演示如何把训练日志转成稳定的判断顺序。真实项目还应记录每层梯度、激活均值与方差,并保留首次失败的批次和随机种子。
从根因到修复
学习率过高时,先降低一个数量级并观察相对更新量是否回到稳定区间,再考虑预热或调度器。若只有个别批次突然爆炸,应检查异常样本、除零、log(0)、过大的指数输入和损失归一化方式。
激活饱和时,应查看问题是否集中在 sigmoid 或 tanh 的大绝对值区域,并检查初始化与输入标准化。梯度持续增大时,可临时启用裁剪保护训练,同时继续定位最先放大的层;梯度接近零时,则应检查停止梯度、错误掩码和过深的饱和链路。
混合精度训练出现非有限值时,还要确认损失缩放是否动态调整,并在关键归约、Softmax、对数和方差计算中保留更高精度。修复动作一次只改一类变量,否则无法确认真正原因。
验证修复是否有效
修复后至少使用同一批数据、同一随机种子和相同初始参数重复短训练。验收不只看损失下降,还要确认损失始终有限、梯度范数不再出现尖峰、参数相对更新量稳定,并且各层激活没有持续扩大或全部塌缩。
若异常只是延迟出现,应保留失败批次继续定位。验收时可用原失败批次做回归检查,再扩大观察步数和数据覆盖,记录是否还触发原异常。