
高等数学 / 系统课时
归一化常数
归一化常数
许多概率模型先给出一个非负的相对权重,而不是已经归一化的密度。本课说明如何用积分求出归一化常数,将权重转换为合法概率分布,并解释高维能量模型中这一积分为何常常成为计算瓶颈。
学习目标
- 会由未归一化函数计算归一化常数
- 理解配分函数在能量模型中的作用
- 能根据维度与函数结构选择合适的计算方法
为什么需要归一化
设 只描述不同位置的相对权重。要把它变成概率密度,需要令:
其中归一化常数 定义为:
只要 ,就有:
因此, 的作用不是改变各点之间的相对大小,而是把整条曲线的总面积缩放到 1。
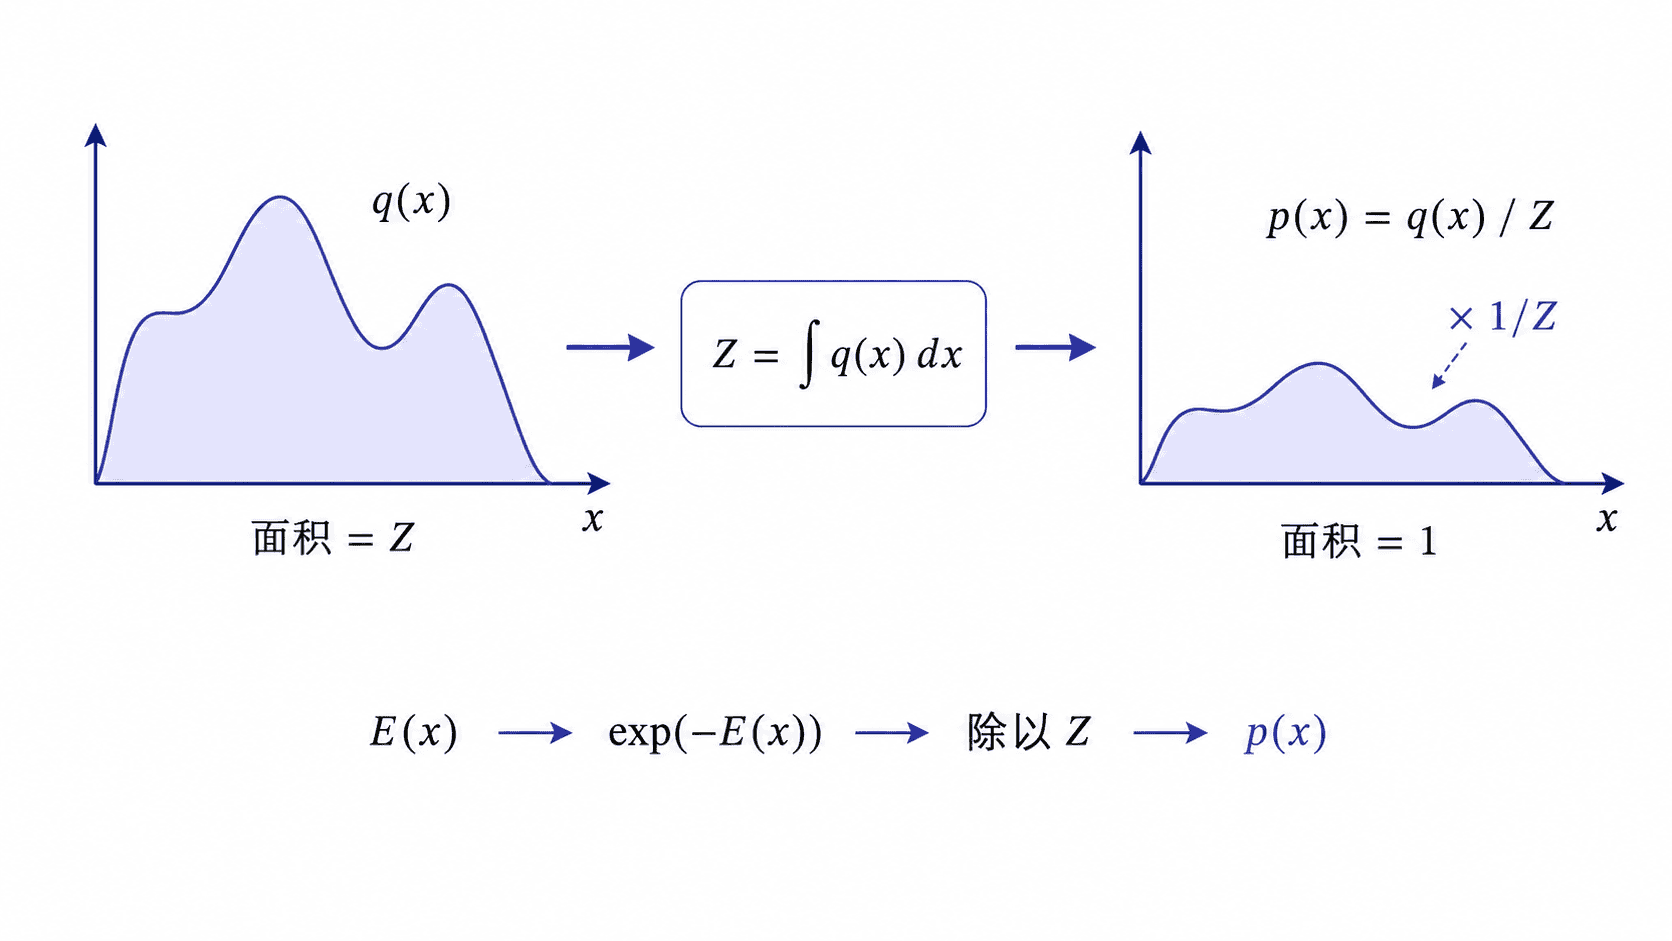
主示例:高斯形权重
设未归一化函数为:
它的积分为:
归一化后得到:
这就是均值为 0、标准差为 的高斯密度。若把支持域改成 ,应在该区间重新归一化。利用误差函数,区间内的权重积分为 ,约为全域积分的 99.73%。下例用 Python 标准库核对这两个常数。
import math

sigma = 2.0
full = sigma * math.sqrt(2 * math.pi)
truncated = full * math.erf(3 / math.sqrt(2))
print(f"full={full:.6f}, truncated={truncated:.6f}")
print(f"mass_in_interval={truncated / full:.6f}")
使用全域常数时,这个区间内的概率质量约为 0.997300。使用截断常数,并在区间外定义密度为零时,区间内概率质量才等于 1。
能量模型中的配分函数
能量模型通常写成:
其中:
越小,样本权重越大; 负责把所有权重统一缩放。它也常被称为配分函数。
当 依赖参数时,精确计算对数似然需要 。计算似然梯度时,可在适当的可微和可积条件下把归一化项的梯度写为模型分布下的期望,并用采样估计,无须先显式求出 。若 是一张包含成千上万个像素的图像,直接网格积分几乎不可行。
为什么高维积分困难
一维区间每个方向取 个网格点,只需约 次计算; 维空间则需要约 个点。维度增加后,计算量呈指数增长,这就是常说的维度灾难。
此外,权重可能集中在很小区域。普通均匀采样大多落在低权重位置,导致积分估计方差很大。若 极大或极小,直接计算 还可能出现浮点上溢或下溢。
计算方法与选择原则
低维、结构简单时,优先使用解析积分或数值求积。中高维问题通常采用重要性采样、马尔可夫链蒙特卡洛、退火重要性采样或变分近似。
对连续且足够光滑的密度,得分匹配比较 ,对 求导后与 无关的 会消去。噪声对比估计可把对数归一化常数作为参数,利用数据与噪声的分类目标估计。短链对比散度近似模型侧期望,其结果受采样链长度与混合情况影响。
实际使用时还要检查积分域。换成有限区间时要按新范围积分。离散集合以逐项求和代替积分。