
高等数学 / 系统课时
从零实现梯度下降
从零实现梯度下降
本课用 NumPy 从零训练一个一元线性模型,完整串起参数初始化、前向计算、梯度求解、参数更新与收敛判断。运行示例后,模型会从零参数逐步逼近真实关系 。
学习目标
- 写出均方误差及其对参数的梯度
- 使用 NumPy 实现完整的批量梯度下降循环
- 根据损失变化判断收敛并识别学习率问题
问题定义
给定样本 ,使用线性模型 预测结果,并最小化均方误差:
对两个参数求偏导,可得到更新所需的梯度:
梯度在欧氏度量下指出一阶变化最快的上升方向,因此参数要沿负梯度方向更新:,。其中 是学习率。
实现完整训练循环
下面的程序只依赖 NumPy。数据严格满足 ,因此训练是否正确可以直接通过最终的 、 和损失验证。
python
import numpy as np

def main() -> None:
    x = np.array([0., 1., 2., 3., 4.])
    y = 2 * x + 1

    # 从简单起点开始,便于观察参数如何被梯度逐步修正
    w, b = 0.0, 0.0
    learning_rate = 0.1
    tolerance = 1e-10
    grad_tolerance = 3e-5
    max_steps = 1000

    for step in range(1, max_steps + 1):
        prediction = w * x + b
        error = prediction - y
        loss = np.mean(error ** 2)

        # 均方误差对 w、b 的解析梯度
        dw = 2 * np.mean(error * x)
        db = 2 * np.mean(error)

        w -= learning_rate * dw
        b -= learning_rate * db

        # 损失变化很小时,再确认更新后的梯度也足够小
        new_error = w * x + b - y
        new_loss = np.mean(new_error ** 2)
        grad_norm = np.linalg.norm([2 * np.mean(new_error * x), 2 * np.mean(new_error)])
        if abs(loss - new_loss) < tolerance and grad_norm < grad_tolerance:
            break

    print(f"steps={step}")
    print(f"w={w:.6f}, b={b:.6f}")
    print(f"loss={new_loss:.12f}")
    print(f"grad_norm={grad_norm:.3e}")
    assert grad_norm < grad_tolerance

if __name__ == "__main__":
    main()
预期输出:
text
steps=141
w=2.000016, b=0.999955
loss=0.000000000687
grad_norm=2.864e-05
浮点计算通常不会得到完全等于 和 的参数,但当前误差已经足够小。若 NumPy 版本或硬件实现不同,最后几位小数可能略有差异。
更新流程与收敛判断
一次迭代依次完成前向预测、计算损失、求梯度、更新参数和检查收敛。只要没有满足停止条件,就用新参数进入下一轮。
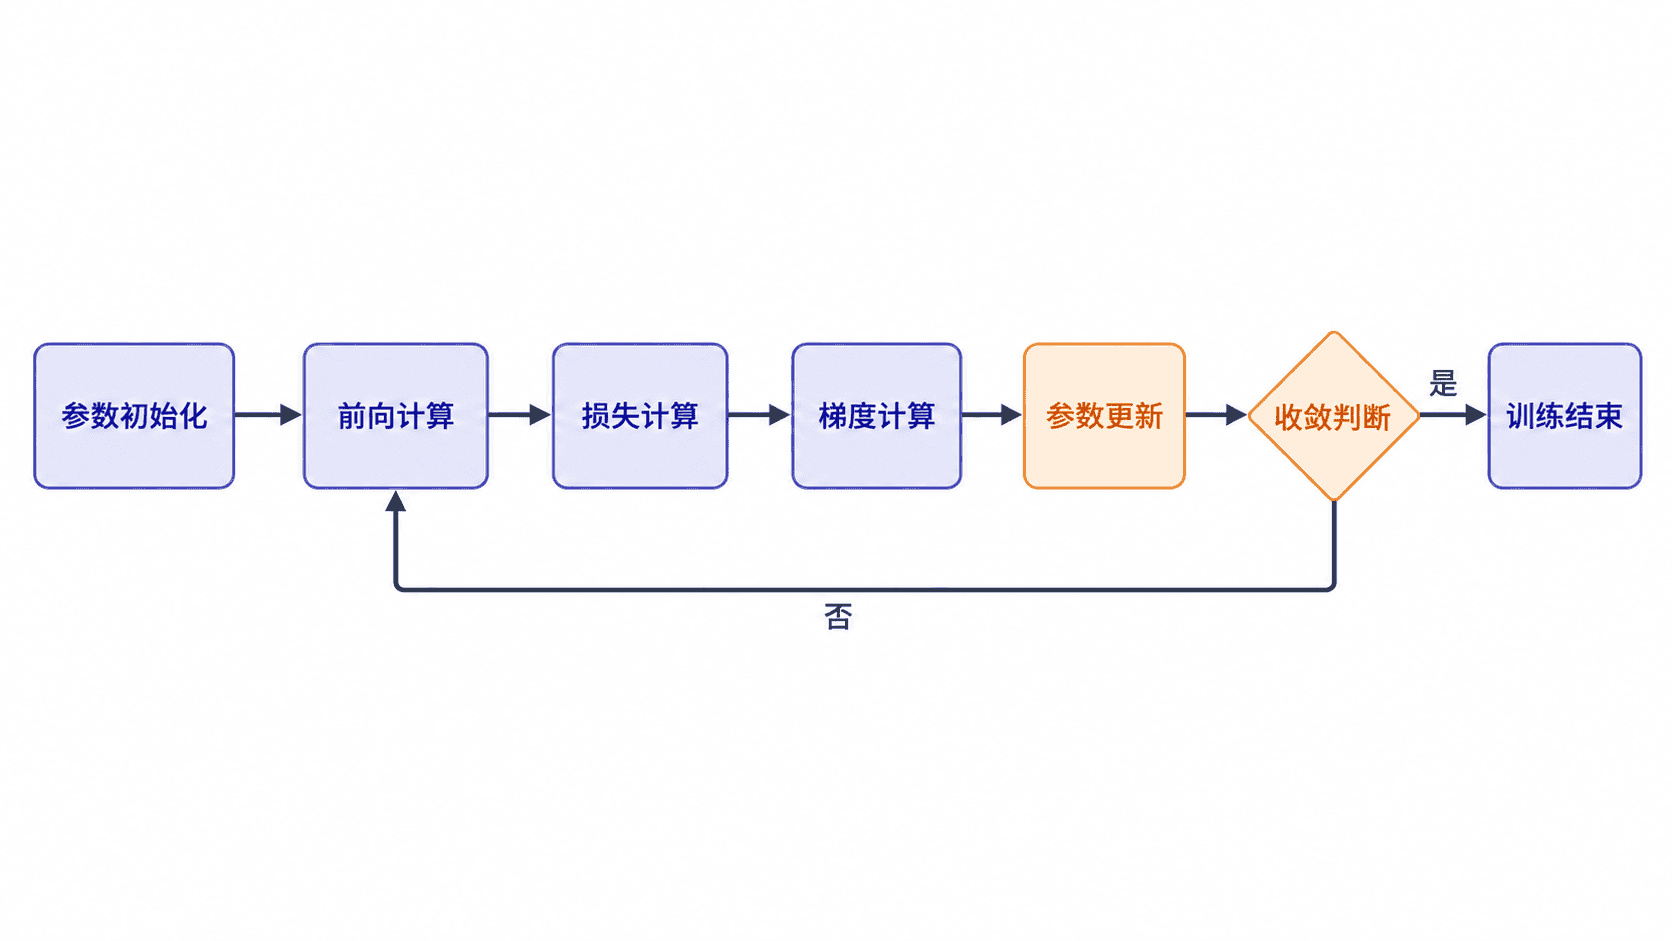
代码同时检查相邻两步损失差和新参数处的梯度范数,并设定最大步数。只用损失差可能因学习率太小而过早停止,最后的断言可帮助区分本例达到阈值和单纯耗尽步数。
学习率与常见边界
学习率过小会使参数变化缓慢,虽然稳定但训练轮数很多;学习率过大则可能跨过最低点,出现损失震荡甚至数值发散。在这组数据上,参数顺序为 时,Hessian 为 ,最大特征值为 。梯度下降在各特征方向的误差每步乘 ,所以 时收敛。这里的 在范围内, 会放大最大特征值方向的误差。换数据后必须重新考虑尺度。
损失非有限时先定位第一个异常运算,并核对输入范围。若输入和梯度始终有限但损失随更新增大,可以减小学习率做对照。
还要注意梯度必须基于当前参数统一计算,再同时更新所有参数。若先更新 w,再用新 w 计算 b 的梯度,就改变了原本的梯度下降步骤,结果可能难以复现。
按自己的节奏,确认真正理解。