
高等数学 / 系统课时
批量与随机梯度
批量与随机梯度
训练模型时,梯度可以由全部样本、单个样本或一小批样本估计。三种方式得到的方向并不总是相同,本课将从计算成本、噪声和收敛表现出发,说明它们各自适合什么场景,并用一次完整训练轮次观察差异。
学习目标
- 区分批量梯度、随机梯度和小批量梯度的计算方式
- 理解梯度噪声、更新频率与收敛稳定性的关系
- 能根据数据规模和硬件条件选择合适的批量大小
三种梯度如何产生
设训练集共有 个样本,单个样本损失为 。批量梯度使用全部样本计算平均值:
单样本更新使用一个样本的梯度,小批量更新使用一批样本梯度的平均。固定参数并均匀抽样时,单样本或小批量的梯度期望等于全批量梯度。非均匀采样、带权样本和不同数据分布需要另行检查估计的目标。
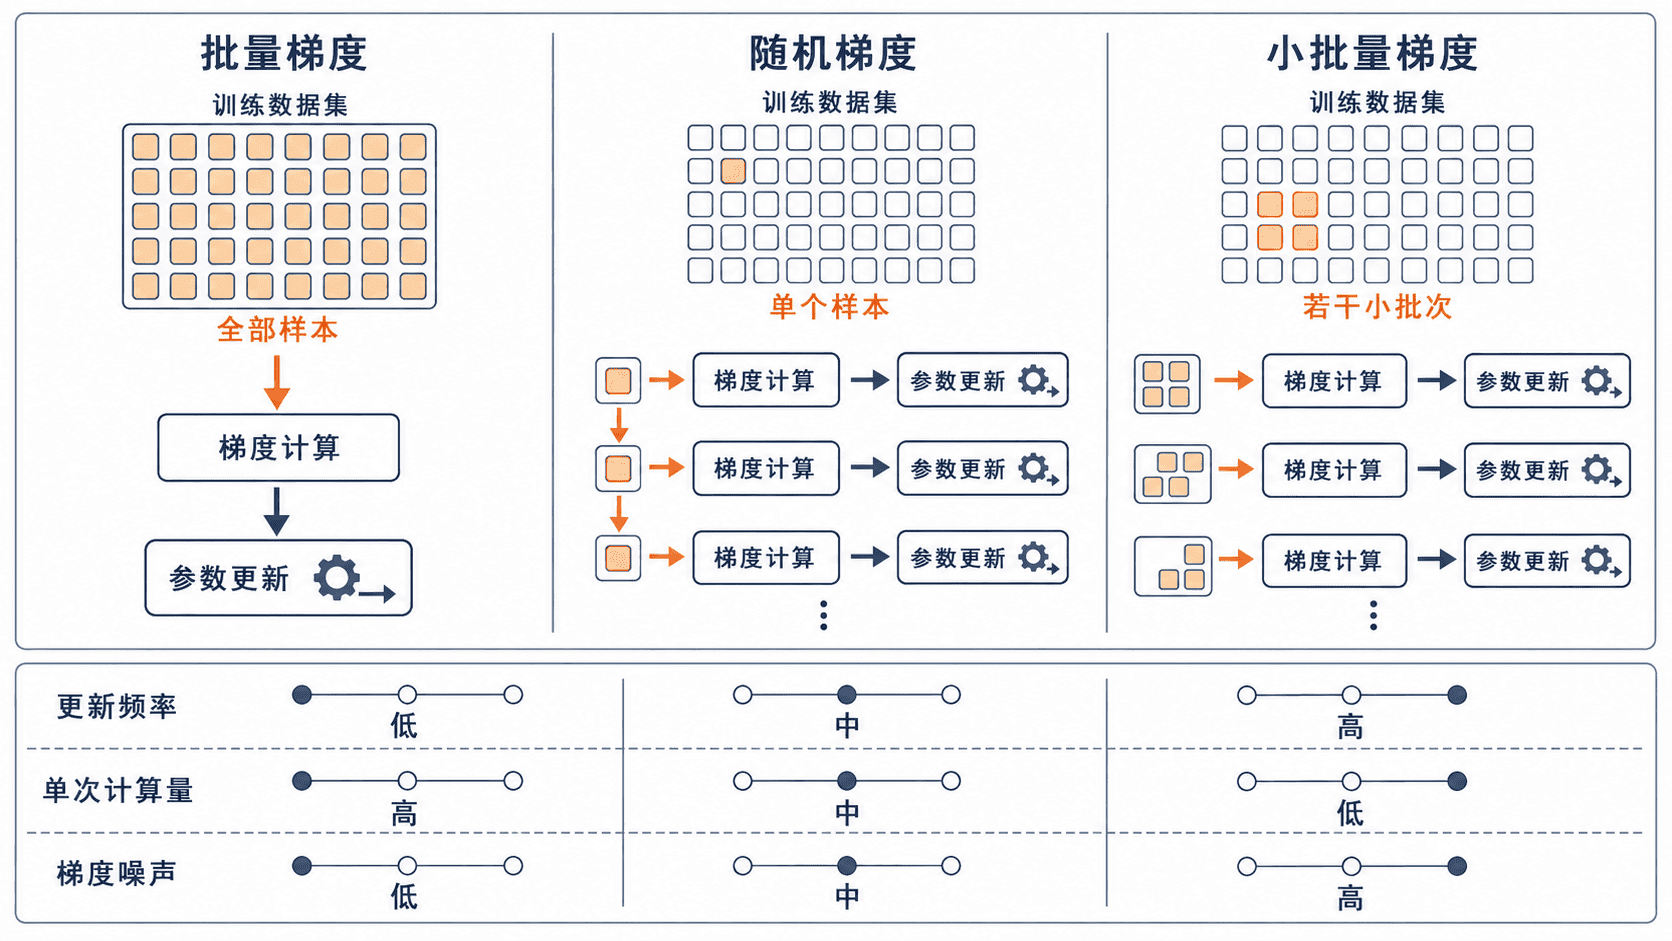
计算成本、噪声与收敛
| 方法 | 每次使用样本数 | 单次计算成本 | 梯度噪声 | 典型特点 |
|---|---|---|---|---|
| 批量梯度 | 高 | 对固定数据无抽样噪声 | 方向稳定,但大数据集上更新慢 | |
| 随机梯度 | 低 | 高 | 更新频繁,可跳出浅平区域,但轨迹抖动明显 | |
| 小批量梯度 | 中 | 中 | 兼顾并行效率与稳定性,是深度学习的常用选择 |
“噪声大”不等于算法错误。随机估计虽然会偏离真实批量梯度,但随机性会造成实际更新和全批量更新不同。即使估计无偏,给定一步也可能让全批量损失增加。噪声能否帮助离开鞍点取决于它在相关方向上的分量。
用一轮更新观察差异
下面用线性模型 拟合 。三种方法都按固定顺序遍历一次数据。本例用单样本更新演示 SGD 的更新粒度,实际训练可在每轮前打乱样本顺序。这里批量梯度更新 1 次,随机梯度更新 4 次,小批量梯度更新 2 次,因此结果不能只按“是否更接近 2”简单判断。
python
x = [1.0, 2.0, 3.0, 4.0]
y = [2.0, 4.0, 6.0, 8.0]
learning_rate = 0.05

def gradient(theta, xs, ys):
    # 均方误差对参数 theta 的平均梯度
    total = sum(2 * (theta * xi - yi) * xi for xi, yi in zip(xs, ys))
    return total / len(xs)

def train(mode):
    theta = 0.0

    if mode == "batch":
        theta -= learning_rate * gradient(theta, x, y)
    elif mode == "stochastic":
        for xi, yi in zip(x, y):
            theta -= learning_rate * gradient(theta, [xi], [yi])
    elif mode == "mini_batch":
        for start in range(0, len(x), 2):
            theta -= learning_rate * gradient(
                theta,
                x[start:start + 2],
                y[start:start + 2]
            )
    else:
        raise ValueError("unknown mode")

    return theta

for name in ("batch", "stochastic", "mini_batch"):
    print(f"{name}: {train(name):.4f}")
预期输出
text
batch: 1.5000
stochastic: 2.0648
mini_batch: 2.3750
同一轮数据访问下,更新次数、分批方式和数据顺序共同影响结果。后续更新所用的梯度在新的参数位置计算,无法把它们直接等同于一个全批量更新。比较优化方法时,应同时观察损失曲线、总计算量、更新次数和最终泛化效果,而不是只比较某一步参数。
如何选择批量大小
数据量较小、目标函数平滑时,批量梯度便于稳定分析。在线学习或数据持续到达时,随机梯度能立即更新。大多数神经网络训练优先采用小批量,并选择能充分利用 GPU、又不会造成显存不足的批量大小。
批量增大后,梯度通常更稳定,但每轮参数更新次数减少;批量过小则可能导致损失剧烈波动。实际训练中应把批量大小与学习率一起调节,而不是单独修改其中一个参数。
按自己的节奏,确认真正理解。