
高等数学 / 系统课时
函数近似与模型压缩
函数近似与模型压缩
复杂函数往往带来较高的计算延迟和存储开销。本课将用多项式近似与分段线性近似说明:如何在可控误差内,把昂贵函数替换成更简单的运算,并建立一套可验证的模型压缩流程。
学习目标
- 理解函数近似降低计算成本的基本原理
- 区分多项式近似与分段近似的适用场景
- 能用误差指标判断近似方案是否可部署
为什么近似能够降低成本
设原函数为 ,近似函数为 。用实际输入范围约束近似误差后,还需要验证端到端任务指标和目标硬件上的成本,才能决定是否替换。
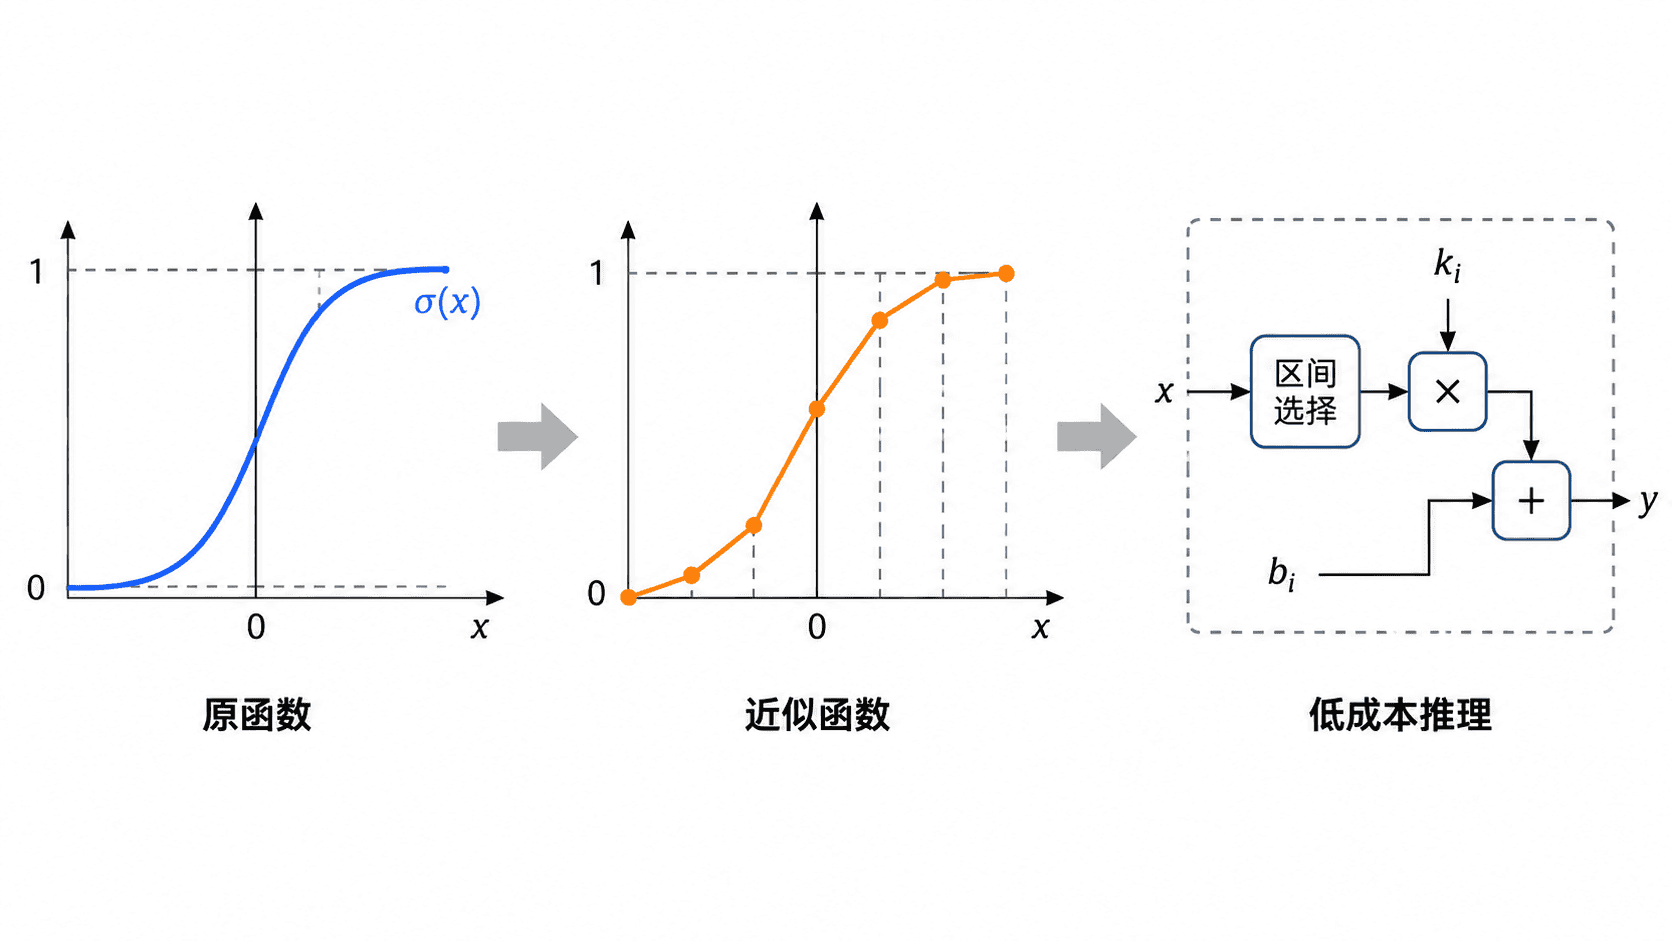
这种替换常见于激活函数、概率函数、归一化计算和嵌入式推理。例如,指数、对数或三角函数可能依赖专门指令或数学库,而低阶多项式通常只需要加法和乘法;分段线性函数则可以进一步简化为区间判断、乘法与加法。
两种常用近似方式
多项式近似
多项式使用 逼近目标函数。低阶多项式执行路径固定,适合向量化和硬件加速,但阶数过高会增加乘法次数,也可能在区间边缘出现较大振荡。
分段近似
分段近似先把输入区间切成若干段,再为每一段配置简单函数。分段线性近似只需保存节点及函数值,通常比全局高阶多项式更稳定,但节点越多,参数存储和区间定位成本越高。
| 方案 | 主要优势 | 主要限制 |
|---|---|---|
| 低阶多项式 | 无分支、便于批量计算 | 大区间内误差可能快速增大 |
| 分段线性 | 局部误差容易控制 | 需要节点存储与区间选择 |
主示例:近似 Sigmoid
下面的程序在区间 选取五个节点,并在相邻节点之间做线性插值。示例可直接使用 Python 3 运行,输入约定为有限实数。
import math

KNOTS = [-4.0, -2.0, 0.0, 2.0, 4.0]

def sigmoid(x: float) -> float:
    weight = math.exp(-abs(x))
    return 1.0 / (1.0 + weight) if x >= 0 else weight / (1.0 + weight)

VALUES = [sigmoid(x) for x in KNOTS]

def piecewise_linear(x: float) -> float:
    # 区间外采用端点值,避免无约束外推
    if x <= KNOTS[0]:
        return VALUES[0]
    if x >= KNOTS[-1]:
        return VALUES[-1]

    for i in range(len(KNOTS) - 1):
        if KNOTS[i] <= x <= KNOTS[i + 1]:
            ratio = (x - KNOTS[i]) / (KNOTS[i + 1] - KNOTS[i])
            return VALUES[i] + ratio * (VALUES[i + 1] - VALUES[i])

    raise RuntimeError("unreachable")

for value in [-3.0, -1.0, 1.0, 3.0]:
    exact = sigmoid(value)
    approx = piecewise_linear(value)
    error = abs(exact - approx)
    print(
        f"{value:>4.1f}: exact={exact:.4f}, "
        f"approx={approx:.4f}, error={error:.4f}"
    )
预期输出:
-3.0: exact=0.0474, approx=0.0686, error=0.0212
-1.0: exact=0.2689, approx=0.3096, error=0.0407
 1.0: exact=0.7311, approx=0.6904, error=0.0407
 3.0: exact=0.9526, approx=0.9314, error=0.0212
插值只在预计算节点时调用指数。区间外使用端点值,由 Sigmoid 的单调性和对称性可知,区间外的绝对误差不超过约 。四个采样点的误差只是观测值,不能作为区间内最大误差的保证。代码为便于阅读使用顺序查找,时间复杂度为 ;若节点等距,工程实现可直接计算区间下标,把定位成本降为 。
如何决定是否可以部署
先限定真实输入范围,覆盖节点、边界与高曲率位置,记录平均误差、采样中观察到的最大误差和任务指标变化。若业务要求严格的最大误差保证,应另用解析界或经过验证的误差估计。平均误差小并不代表安全,因为少量边界样本仍可能产生较大偏差。
部署前还要比较实际延迟、内存占用和硬件兼容性。若近似函数更快,但导致分类准确率、排序质量或数值稳定性明显下降,就不属于有效压缩。函数近似通常与量化、剪枝或知识蒸馏配合使用,而不是替代这些方法。