
容器与云原生 / 系统课时
设计项目部署架构
设计项目部署架构
这一节把一个典型微服务项目拆成前端、网关、业务服务、数据库和缓存五类运行单元,并明确它们在 Kubernetes 中的命名空间、暴露方式和依赖边界。最终你会得到一份可落地的部署架构,而不是只有组件名称的示意图。
学习目标
- 根据组件职责选择 Deployment、Service、Ingress 等 Kubernetes 资源
- 设计命名空间与服务依赖,避免跨层直接访问和资源混放
- 用最小配置创建项目命名空间并验证基础部署边界
从访问链路确定组件关系
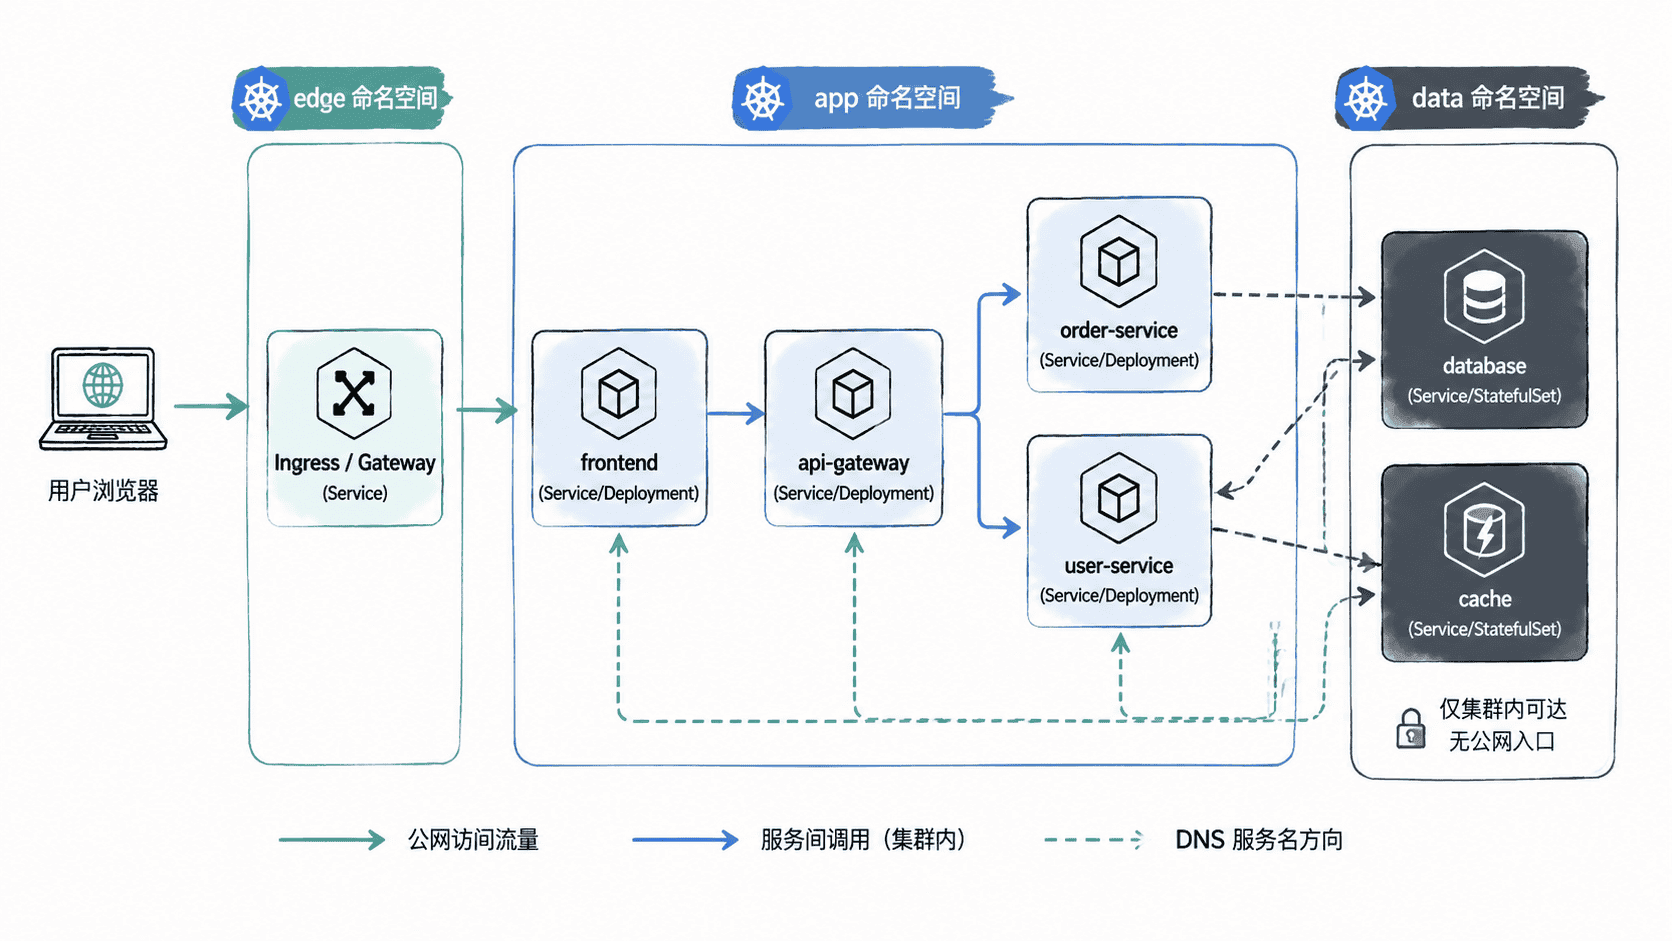
先从用户请求的真实路径设计,而不是先画 Kubernetes 资源。浏览器访问前端,前端调用统一网关,网关再路由到业务服务;业务服务访问数据库和缓存。数据库与缓存不应直接暴露给公网,业务服务之间也尽量通过稳定的 Service 名称通信。
前端、网关和无状态业务服务适合使用 Deployment 管理副本;集群内访问通过 ClusterIP Service;公网入口可由 Ingress 或 Gateway API 承载。数据库和缓存若由集群外托管服务提供,只需保留连接配置与网络策略;若部署在集群内,则需要额外设计持久卷、备份、反亲和性和故障恢复,不能把它们当成普通无状态 Deployment。
划分命名空间与资源边界
一个适合教学和小型生产项目的划分是 edge、app、data 三层:edge 放外部入口和网关,app 放前端与业务服务,data 放仅内部访问的数据组件。这样可以分别设置 ResourceQuota、RBAC、NetworkPolicy 和发布权限。
命名空间不是强安全边界,真正限制访问仍要依赖 RBAC 与 NetworkPolicy。不过它能先把“谁属于哪一层”固定下来,减少所有资源都堆在 default 中导致的权限和运维混乱。
下面先创建三个命名空间,并用统一标签标记它们的职责:
apiVersion: v1
kind: List
items:
  - apiVersion: v1
    kind: Namespace
    metadata:
      name: edge
      labels:
        project: shop
        layer: edge
  - apiVersion: v1
    kind: Namespace
    metadata:
      name: app
      labels:
        project: shop
        layer: app
  - apiVersion: v1
    kind: Namespace
    metadata:
      name: data
      labels:
        project: shop
        layer: data
这是配置文件示例,保存为 namespaces.yaml 后执行:
kubectl apply -f namespaces.yaml
kubectl get namespace -l project=shop
预期输出
namespace/edge created
namespace/app created
namespace/data created
NAME   STATUS   AGE
app    Active   <TIME>
data   Active   <TIME>
edge   Active   <TIME>
AGE 会随实际创建时间变化。若命名空间已存在,kubectl apply 可能显示 configured 或 unchanged,都表示声明式配置已成功应用。
选择每类资源的运行方式
前端与业务服务通常都由 Deployment 管理,重点差异在暴露范围。前端如果由 Ingress 直接路由,可以使用 ClusterIP Service;网关同样只需 ClusterIP,由 Ingress 或 Gateway 接收公网流量后转发。业务服务则完全保持集群内部访问。
数据库和缓存需要单独决策。如果课程目标是练习微服务发布流程,优先使用托管数据库和托管缓存可以减少存储运维变量;如果目标包含有状态服务治理,再考虑 StatefulSet、持久卷和备份策略。无论哪种方式,数据库凭据都应通过 Secret 注入,不能写进镜像或普通 ConfigMap。
| 组件 | 推荐工作负载 | 访问方式 | 关键关注点 |
|---|---|---|---|
| 前端 | Deployment | ClusterIP + Ingress/Gateway | 静态资源缓存、滚动发布 |
| API 网关 | Deployment | ClusterIP | 路由、超时、限流 |
| 业务服务 | Deployment | ClusterIP | 副本数、探针、资源请求 |
| 数据库 | 托管服务或 StatefulSet | 仅内部 | 持久化、备份、恢复 |
| 缓存 | 托管服务或 StatefulSet | 仅内部 | 内存上限、淘汰策略、可用性 |
固定服务发现和依赖方向
Kubernetes Service 提供稳定 DNS 名称。跨命名空间访问时可以使用 <service>.<namespace>.svc,例如网关访问 order-service.app.svc。架构设计阶段应把依赖方向固定为入口层到应用层,再到数据层,避免数据层反向依赖网关或服务绕过网关形成不可控调用。
同时为后续 NetworkPolicy 留出规则边界:edge 可以访问指定的 app Service,app 可以访问必要的 data Service,而 data 默认不接受其他来源。即使暂时不写 NetworkPolicy,也要先把允许的通信关系设计清楚,否则上线后很难判断某条跨服务连接是否合理。
用架构检查表完成验收
部署架构可以在真正创建业务 Deployment 前先验收。检查公网是否只有一个受控入口;业务服务是否只通过 Service 暴露;数据库和缓存是否没有公网 Service;每个组件是否有明确命名空间;跨命名空间依赖是否有稳定 DNS 名称;有状态组件是否已经明确托管或自建方案。
当这些关系明确后,后续编写 Deployment、Service、Ingress、ConfigMap、Secret、探针和弹性伸缩配置时,就能围绕既定边界逐项实现。架构设计的价值在于先消除资源关系的不确定性,使上线阶段只处理配置细节,而不是边部署边决定系统拓扑。