
容器与云原生 / 系统课时
接入监控与日志
接入监控与日志
本节把一个已运行在 Kubernetes 中的微服务接入统一可观测链路:指标进入 Prometheus,日志进入 Loki,并在 Grafana 中用仪表盘和基础告警形成可验证的上线闭环。
学习目标
- 让业务指标通过 ServiceMonitor 被 Prometheus 稳定抓取
- 让容器标准输出日志可按命名空间、应用和 Pod 检索
- 建立最小仪表盘与告警规则,并完成端到端验证
先确定可观测入口
应用应把指标和日志分别暴露到标准入口。指标由 HTTP 端点提供,例如 /metrics;日志直接写到 stdout/stderr,由节点上的日志采集组件读取容器日志文件。不要把日志写进 Pod 内部临时文件后再指望人工进入容器查看。
本节假设集群已经安装 Prometheus Operator、Grafana、Loki 及一个能够采集 Kubernetes 容器日志的 Loki Agent。应用位于 shop 命名空间,Service 名为 checkout,指标端口命名为 http-metrics,并带有 app: checkout 标签。
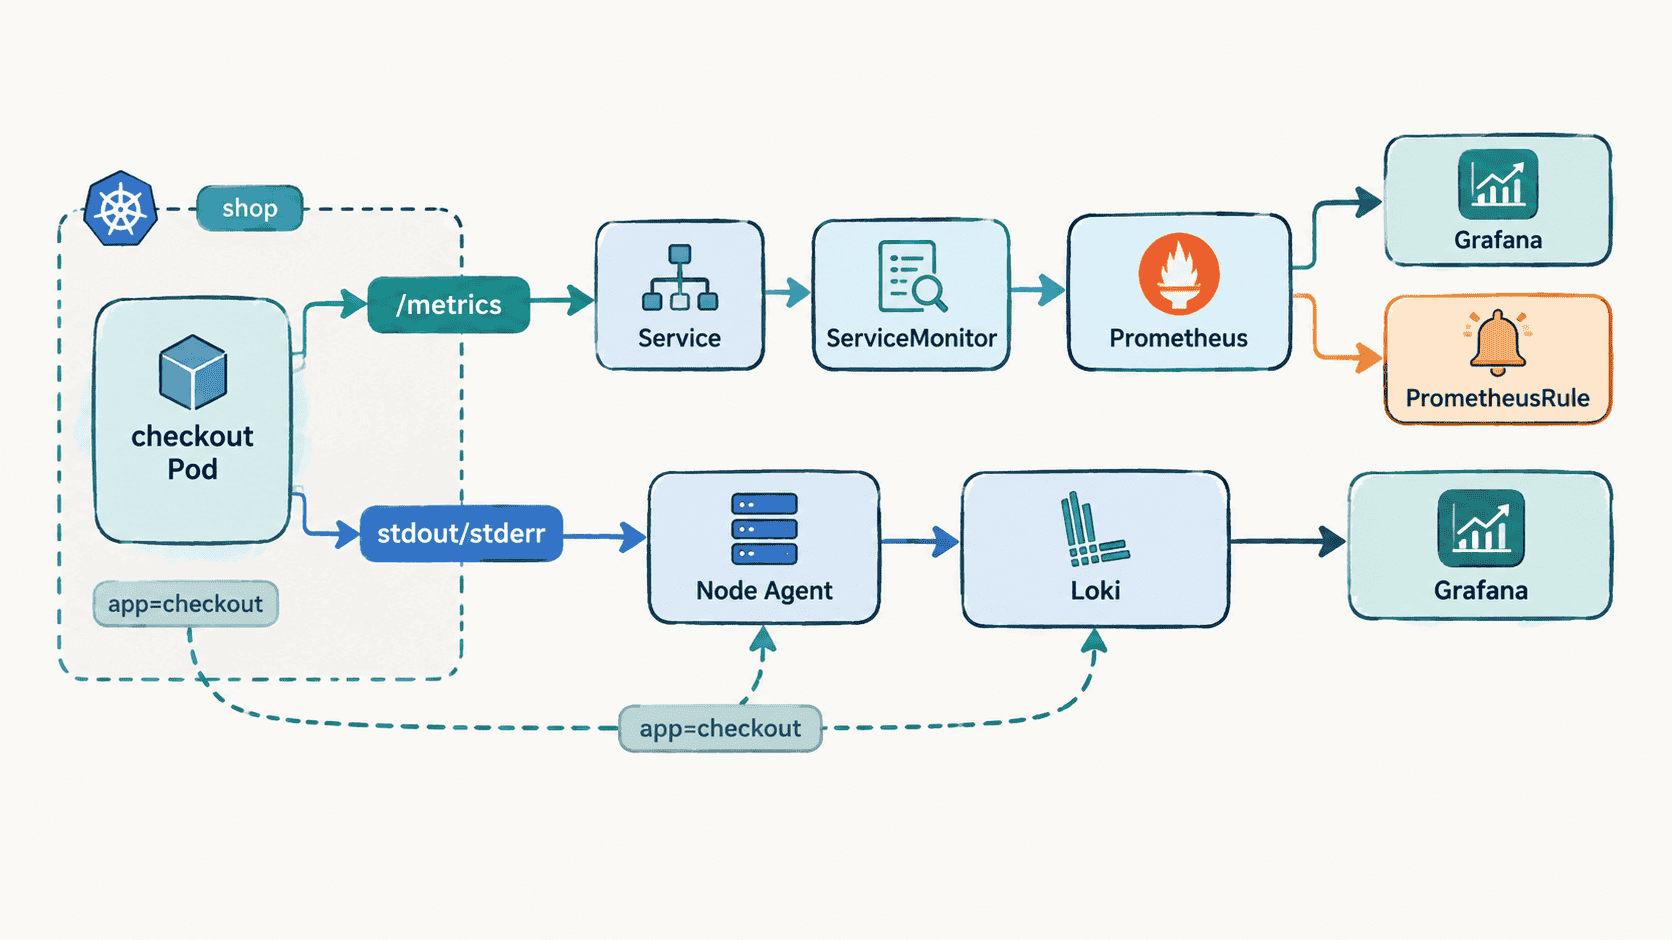
先确认 Service 的端口名和标签,因为 ServiceMonitor 会按这两个条件发现目标。
kubectl get svc checkout -n shop -o jsonpath='{.metadata.labels.app}{"\n"}{.spec.ports[?(@.name=="http-metrics")].name}{"\n"}'预期输出
checkout
http-metrics
如果实际端口名不同,应以后续 ServiceMonitor 中的 endpoints.port 与真实名称保持一致。
接入指标采集与告警
下面的配置同时创建 ServiceMonitor 和 PrometheusRule。示例假设 Prometheus Operator 会选择带 release: monitoring 标签的规则资源;如果你的监控栈使用其他选择器,应按实际安装值调整这个标签。
apiVersion: v1
kind: List
items:
  - apiVersion: monitoring.coreos.com/v1
    kind: ServiceMonitor
    metadata:
      name: checkout
      namespace: shop
      labels:
        release: monitoring
    spec:
      selector:
        matchLabels:
          app: checkout
      targetLabels:
        - app
      endpoints:
        - port: http-metrics
          path: /metrics
          interval: 30s
  - apiVersion: monitoring.coreos.com/v1
    kind: PrometheusRule
    metadata:
      name: checkout-alerts
      namespace: shop
      labels:
        release: monitoring
    spec:
      groups:
        - name: checkout.rules
          rules:
            - alert: CheckoutHigh5xxRate
              expr: |
                sum(rate(http_requests_total{app="checkout",status=~"5.."}[5m]))
                /
                clamp_min(sum(rate(http_requests_total{app="checkout"}[5m])), 0.001)
                > 0.05
              for: 10m
              labels:
                severity: warning
              annotations:
                summary: checkout 5xx rate is above 5%
这段配置依赖应用真实暴露 http_requests_total,并至少包含 status 标签;ServiceMonitor 的 targetLabels 会把 Service 上的 app 标签带入抓取目标。指标名或标签不一致时,告警表达式必须按应用实现调整。配置文件本身的生效方式是被 Prometheus Operator 转换为抓取目标和告警规则。
应用配置后检查 CRD 对象是否存在。
kubectl apply -f observability.yaml
kubectl get servicemonitor checkout -n shop -o name
kubectl get prometheusrule checkout-alerts -n shop -o name
预期输出
servicemonitor.monitoring.coreos.com/checkout created
prometheusrule.monitoring.coreos.com/checkout-alerts created
servicemonitor.monitoring.coreos.com/checkout
prometheusrule.monitoring.coreos.com/checkout-alerts
若资源创建成功但 Prometheus 没有目标,优先检查 Service 标签、端口名、ServiceMonitor 标签选择器以及 Prometheus 对命名空间的选择范围。
建立仪表盘与日志检索
仪表盘先保留最小的四类信号:请求速率、5xx 比例、P95 延迟和 Pod 重启次数。前三项来自业务指标,最后一项来自 Kubernetes 指标。面板数量不必多,关键是能直接回答“流量是否异常、错误是否上升、响应是否变慢、实例是否不稳定”。
例如 5xx 比例可以使用以下 PromQL:
sum(rate(http_requests_total{app="checkout",status=~"5.."}[5m]))
/
clamp_min(sum(rate(http_requests_total{app="checkout"}[5m])), 0.001)
验证时在 Prometheus 或 Grafana Explore 中执行该表达式。
预期结果
返回一个 5xx 请求比例的时间序列;正常情况下通常接近 0,发生 5xx 后数值会升高,具体值取决于实际流量。日志侧应确保应用把关键字段写入单行结构化日志,例如请求 ID、级别、路由和错误码。Loki 已按 Kubernetes 元数据打标签时,可以先用最小 LogQL 验证链路:
{namespace="shop", app="checkout"} |= "ERROR"预期结果
返回 shop 命名空间中 app=checkout 且正文包含 ERROR 的日志行;若当前没有错误日志,则结果为空。日志查不到时,不要先修改查询语句猜标签。先用 kubectl logs 验证应用确实输出日志,再检查日志 Agent 是否采集目标 Pod、Loki 是否收到流,以及 Grafana 数据源是否指向正确 Loki 实例。
用故障注入完成验收
上线前至少做一次小范围验证:发送正常请求确认请求速率面板变化,再制造一个受控 5xx 或调用测试错误端点,确认错误日志可检索且 5xx 比例上升。告警设置了 for: 10m 时,不应为了“马上看到告警”删掉持续时间;测试环境可以临时降低阈值或持续时间,完成后恢复生产配置。
最终验收的关键不是“Grafana 有图”,而是同一个故障能沿着指标、日志和告警三条证据链被定位到同一应用。这样监控才真正参与上线后的判断,而不是仅作为展示页面。