
容器与云原生 / 系统课时
查看资源状态与事件
查看资源状态与事件
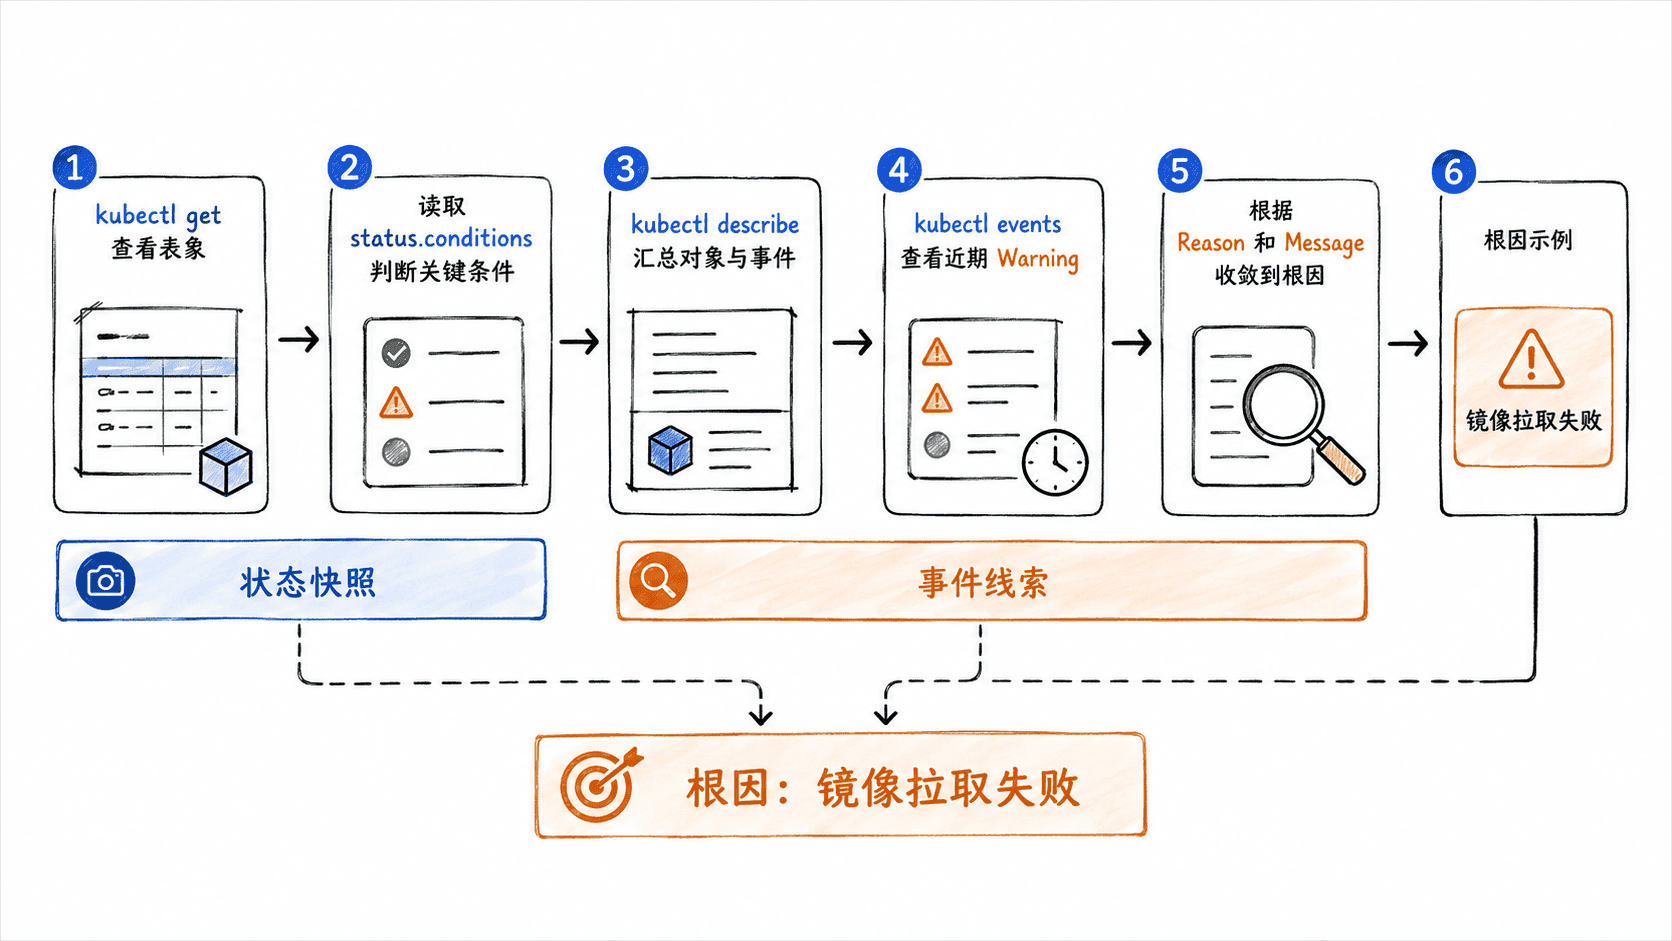
本节用一个故意拉取失败的 Pod 建立排障现场,练习从 kubectl get 的状态表象进入 status.conditions,再通过 describe 和事件定位失败原因,形成可重复的资源排查顺序。
学习目标
- 用
kubectl get快速判断资源是否处于期望状态 - 读取
status.conditions区分“对象存在”和“对象已就绪” - 用
kubectl describe与kubectl events找到失败原因和时间线索
构造一个可观察的失败现场
创建一个引用不存在镜像的 Pod。API Server 能正常接受对象,但 kubelet 无法完成镜像拉取,因此这个例子适合观察“资源已创建、工作负载却未就绪”的差异。
kubectl run event-demo \
  --image=registry.invalid/example/missing:v1 \
  --restart=Never
预期输出:
pod/event-demo created等待数秒后开始排查。由于镜像拉取会重试,不同观察时刻可能看到 ErrImagePull 或 ImagePullBackOff。
先用 get 看当前表象
kubectl get 适合回答“现在大概处于什么状态”。先看 Pod 的 READY、STATUS、RESTARTS 和所在节点,不要一上来就翻大量日志。
kubectl get pod event-demo -o wide预期结果类似:
NAME         READY   STATUS    RESTARTS   AGE      IP       NODE
event-demo   0/1     <VALUE>   0          <TIME>   <VALUE>  <VALUE>
这里最关键的是 READY 仍为 0/1,而 STATUS 会随重试过程变化。get 是入口,不足以直接说明根因。
用条件字段判断是否真正就绪
Kubernetes 对象的 status 表示当前状态;许多资源还会在 conditions 中记录控制器对关键条件的判断。对这个 Pod,直接抽取 Ready 条件可以避免只盯着简化后的 STATUS 列。
kubectl get pod event-demo \
  -o jsonpath='{range .status.conditions[?(@.type=="Ready")]}{.type}{"="}{.status}{" reason="}{.reason}{"\n"}{end}'
预期输出:
Ready=False reason=ContainersNotReadyReady=False 说明 Pod 对象虽然已经存在并可能已经调度到节点,但容器还没有满足就绪条件。排障时要把“资源创建成功”“Pod 已调度”“容器已启动”“应用已就绪”看成不同层次。
用 describe 和 events 收敛根因
kubectl describe 会把对象配置、当前状态和相关事件放到同一份可读输出中。对镜像拉取失败,重点寻找容器的 Waiting Reason,以及末尾 Events 中的 Reason 和 Message。
kubectl describe pod event-demo预期结果会出现类似关键信息,具体服务器错误文本可能不同:
Status:         Pending
State:          Waiting
  Reason:       ImagePullBackOff
Events:
  Type     Reason   <VALUE>   Message
  Warning  Failed   <VALUE>   Failed to pull image "<VALUE>"
如果只想聚焦近期告警,可以直接按资源过滤事件:
kubectl events --for pod/event-demo --types=Warning预期结果会看到与镜像拉取有关的 Warning;事件次数、时间和 Message 会随重试变化:
LAST SEEN   TYPE      REASON    OBJECT           MESSAGE
<TIME>      Warning   Failed    Pod/event-demo   <VALUE>
<TIME>      Warning   BackOff   Pod/event-demo   <VALUE>
事件适合解释“刚才发生了什么”,但它不是永久审计日志。线上排障应在事件仍可用时及时采集,并把关键事件接入集中式可观测系统。
固定一条排查顺序
面对 Pending、CrashLoopBackOff 或控制器副本不足时,可以先遵循同一条主线:get 确认现象,conditions 判断哪个关键条件未满足,describe 查看对象上下文,再用 events 还原近期失败原因。只有事件指向应用进程、探针或配置问题时,再进入日志、配置和依赖层继续排查。
完成练习后删除测试 Pod:
kubectl delete pod event-demo预期输出:
pod "event-demo" deleted这套顺序的价值在于先利用 Kubernetes 已经给出的状态和控制面证据缩小范围,再进入更昂贵的日志与应用分析,避免仅凭一个 STATUS 字段猜测根因。