
容器与云原生 / 系统课时
HPA 水平自动伸缩
HPA 水平自动伸缩
HPA 的目标不是“CPU 高就多起几个 Pod”这么简单,而是根据指标持续计算期望副本数,并通过工作负载的 scale 子资源调整副本。本课从指标链路开始,完成 CPU、内存和自定义指标三类伸缩配置。
学习目标
- 安装并验证 Metrics Server,让集群能够提供 Pod 的 CPU 和内存资源指标。
- 使用
autoscaling/v2为 Deployment 配置 CPU、内存双指标 HPA。 - 理解自定义指标所需的适配器,以及多指标、稳定窗口和资源请求对伸缩结果的影响。
HPA 实际控制什么
HPA 控制器周期性读取目标工作负载的当前副本数和指标值,再计算期望副本数,并写入 Deployment、StatefulSet 等对象暴露的 scale 子资源。真正创建或删除 Pod 的仍然是对应控制器,HPA 本身不会直接创建 Pod,也不会修改容器的资源请求。
对 CPU 利用率这类资源指标,核心近似关系是 期望副本数 = ceil(当前副本数 × 当前指标值 / 目标指标值)。实际控制器还会应用容忍区间、缺失指标处理、伸缩策略和稳定窗口,因此不会每次轻微抖动都立即扩缩容。
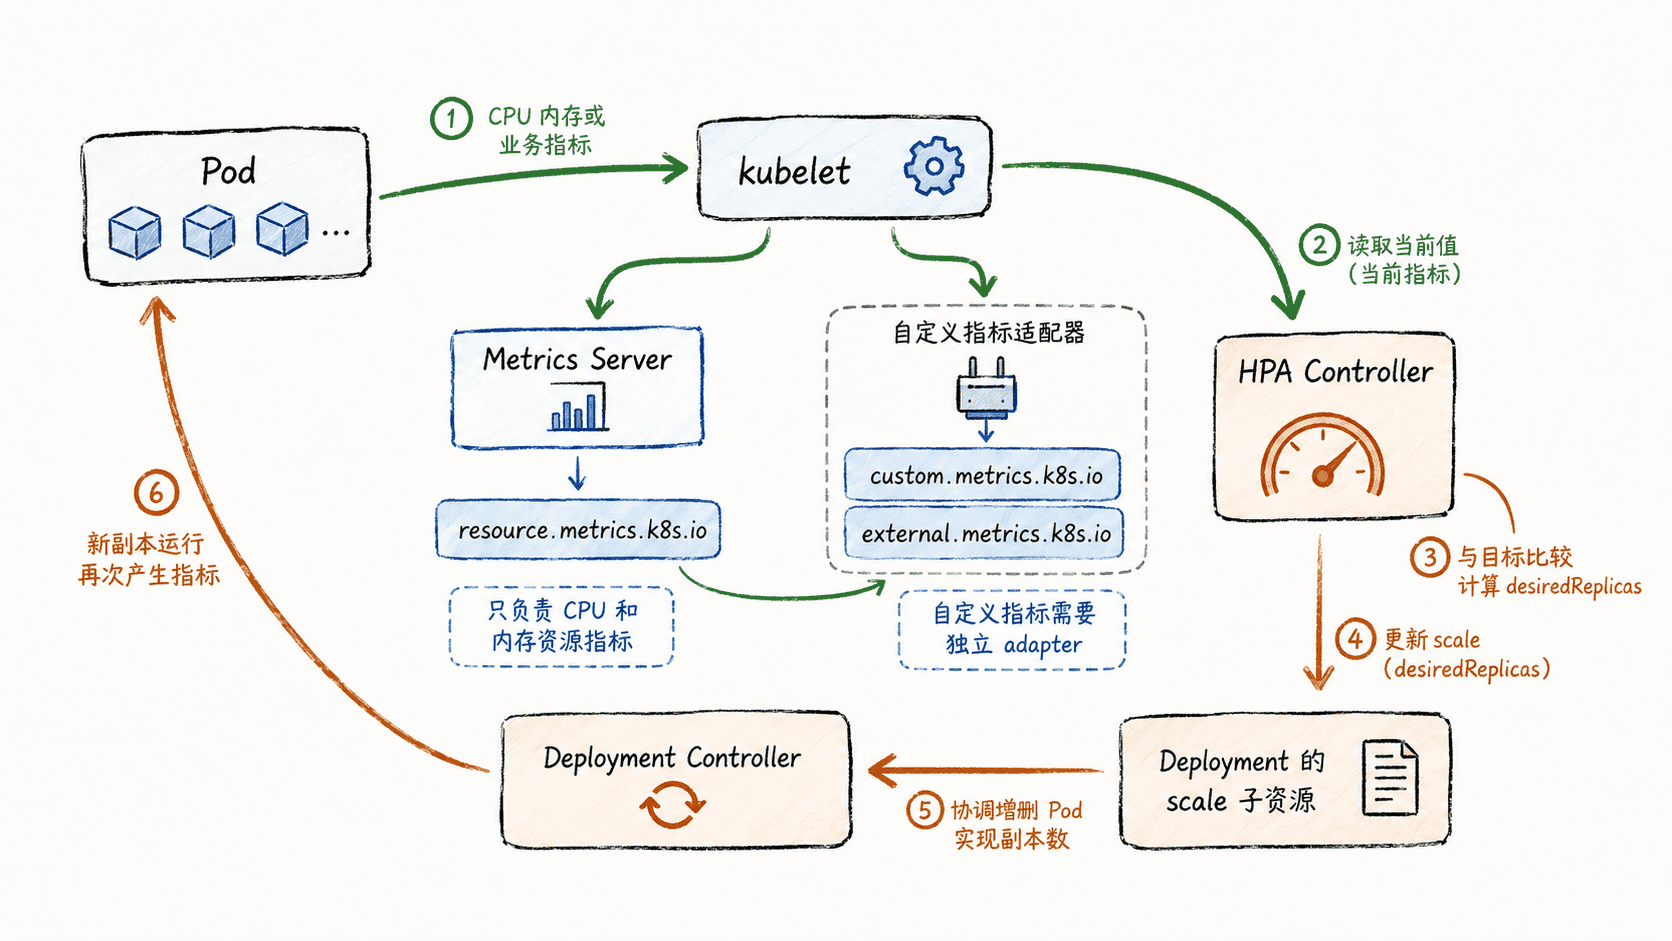
准备资源指标链路
许多托管 Kubernetes 已经提供资源指标 API;自建集群常需要安装 Metrics Server。下面使用官方发布清单安装,生产环境建议把 latest 固定为经过验证的具体版本。
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/latest/download/components.yaml预期输出
serviceaccount/metrics-server <VALUE>
service/metrics-server <VALUE>
deployment.apps/metrics-server <VALUE>
apiservice.apiregistration.k8s.io/v1beta1.metrics.k8s.io <VALUE>
<VALUE> 可能是 created、configured 或 unchanged,取决于集群中是否已有对应资源。接着等待聚合 API 可用:
kubectl wait --for=condition=Available apiservice/v1beta1.metrics.k8s.io --timeout=120s预期输出
apiservice.apiregistration.k8s.io/v1beta1.metrics.k8s.io condition met再读取节点指标:
kubectl top nodes预期结果
NAME          CPU(cores)   CPU%      MEMORY(bytes)   MEMORY%
<NODE_NAME>   <VALUE>      <VALUE>%  <VALUE>         <VALUE>%
如果 APIService 一直不可用,优先检查 Metrics Server Pod 日志、到 kubelet 的网络连通性以及 kubelet 证书。--kubelet-insecure-tls 只适合临时实验排障,不应作为生产环境长期配置。
部署可伸缩工作负载
下面部署 Kubernetes HPA 示例应用,并显式设置 CPU、内存请求。CPU 利用率目标依赖资源请求作为分母;缺少 requests.cpu 时,HPA 可能无法为相关 Pod 计算 CPU 利用率。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: php-apache
spec:
  replicas: 1
  selector:
    matchLabels:
      app: php-apache
  template:
    metadata:
      labels:
        app: php-apache
    spec:
      containers:
        - name: php-apache
          image: registry.k8s.io/hpa-example
          ports:
            - containerPort: 80
          resources:
            requests:
              cpu: 200m
              memory: 64Mi
            limits:
              cpu: 500m
              memory: 128Mi
---
apiVersion: v1
kind: Service
metadata:
  name: php-apache
spec:
  selector:
    app: php-apache
  ports:
    - port: 80
      targetPort: 80
把内容保存为 app.yaml 后执行:
kubectl apply -f app.yaml预期输出
deployment.apps/php-apache created
service/php-apache created
这里 CPU 目标利用率会相对 200m 的请求值计算,而不是相对 500m 的 limit 计算。
配置 CPU 与内存双指标
autoscaling/v2 可以同时配置多个指标。HPA 会分别计算每个指标需要的副本数,再选择其中最大的结果,因此任意一个指标达到扩容条件都可能把副本数推高。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: php-apache
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: php-apache
  minReplicas: 2
  maxReplicas: 10
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 300
      policies:
        - type: Percent
          value: 50
          periodSeconds: 60
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 50
    - type: Resource
      resource:
        name: memory
        target:
          type: Utilization
          averageUtilization: 70
把内容保存为 hpa.yaml 后应用:
kubectl apply -f hpa.yaml预期输出
horizontalpodautoscaler.autoscaling/php-apache created等待指标出现后查看状态:
kubectl get hpa php-apache预期结果
NAME         REFERENCE               TARGETS                         MINPODS   MAXPODS   REPLICAS   AGE
php-apache   Deployment/php-apache   <VALUE>%/70%, <VALUE>%/50%    2         10        <VALUE>    <TIME>
TARGETS 的显示顺序可能与清单顺序不同;关键是当前值不再是 <unknown>,并且副本数始终位于 2 到 10 之间。scaleDown.stabilizationWindowSeconds: 300 会让缩容更保守,避免负载短暂下降就立即删除大量 Pod。
触发扩容并观察
创建一个持续请求 Service 的临时负载 Pod:
kubectl run load-generator --image=busybox:1.36 --restart=Never -- /bin/sh -c 'while true; do wget -q -O- http://php-apache; done'预期输出
pod/load-generator created等待若干个指标采样和 HPA 控制周期后再次查看:
kubectl get hpa php-apache预期结果
NAME         REFERENCE               TARGETS                         MINPODS   MAXPODS   REPLICAS   AGE
php-apache   Deployment/php-apache   <VALUE>%/70%, <VALUE>%/50%    2         10        <VALUE>    <TIME>
当 CPU 或内存指标持续超过目标时,REPLICAS 应从最小副本数向上增加;具体数值取决于节点容量、请求速率和采样时刻。停止压测后删除负载 Pod:
kubectl delete pod load-generator预期输出
pod "load-generator" deleted由于配置了 300 秒缩容稳定窗口,负载消失后副本数不会立刻降到 2,这是预期行为。
使用自定义指标
Metrics Server 只提供 CPU、内存这类资源指标。若要按每个 Pod 的请求速率、队列长度或业务指标伸缩,需要先部署与监控系统匹配的 metrics adapter,并让 Kubernetes API 聚合层暴露 custom.metrics.k8s.io 或 external.metrics.k8s.io。
下面是片段示例,用于替换前面 HPA 的 spec.metrics;它依赖适配器已经提供名为 http_requests_per_second 的 Pod 指标,不能脱离该前提单独生效。
metrics:
  - type: Pods
    pods:
      metric:
        name: http_requests_per_second
      target:
        type: AverageValue
        averageValue: 20
Pods 指标表示按 Pod 平均值伸缩;如果指标来自集群外部队列或云服务,通常使用 External 类型。应用自定义指标 HPA 前,应先确认对应指标 API 能返回当前值,再用 kubectl describe hpa 检查是否存在 FailedGetPodsMetric、FailedGetExternalMetric 等事件。
HPA 最常见的失效点不是公式,而是指标链路不完整:资源指标长期 <unknown> 时先查 Metrics Server;CPU 利用率不可计算时先查容器资源请求;自定义指标取不到时先查 adapter 和聚合 API。先保证指标可读,再调目标值和伸缩窗口,才能避免“配置看起来正确但副本始终不动”的情况。