
容器与云原生 / 系统课时
Job 批处理任务
Job 批处理任务
Job 用来运行“执行完成后退出”的一次性任务,而不是长期常驻服务。本节通过一个需要成功完成 6 次、最多并行 2 个 Pod 的示例,配置完成次数、并行度、失败重试与总超时,并用 kubectl 验证最终状态。
学习目标
- 使用
completions与parallelism控制批处理完成次数和并发量。 - 使用
backoffLimit与activeDeadlineSeconds限制失败重试和总执行时间。 - 通过 Job 状态判断任务是否完成、失败或仍在运行。
Job 如何判断完成
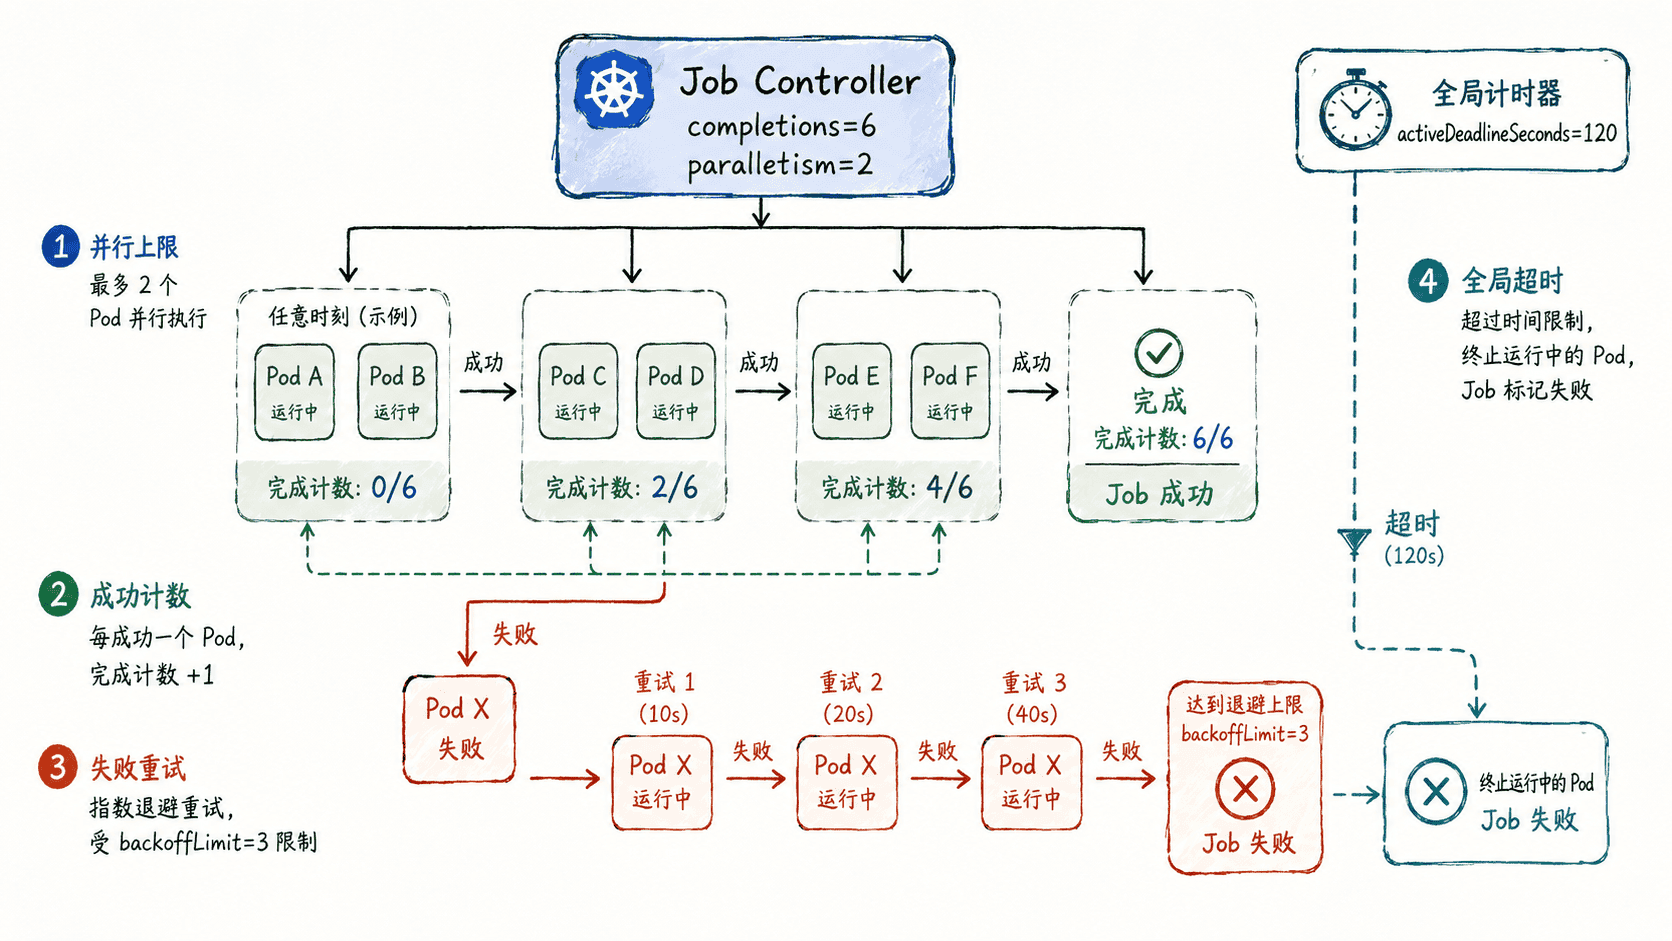
Job 控制器持续创建 Pod,直到成功完成次数达到 completions。parallelism 只是同时运行 Pod 的上限,并不保证每一批耗时完全一致;当某个 Pod 失败时,控制器会按退避策略重试,直到成功、达到 backoffLimit,或整个 Job 超过 activeDeadlineSeconds。
定义一次性批处理
下面的 Job 需要 6 个 Pod 成功结束,同时最多运行 2 个 Pod。restartPolicy: Never 让失败由 Job 控制器重新创建 Pod 处理;ttlSecondsAfterFinished 则在任务结束一段时间后自动清理 Job 及其 Pod。
apiVersion: batch/v1
kind: Job
metadata:
  name: batch-demo
spec:
  completions: 6
  parallelism: 2
  backoffLimit: 3
  activeDeadlineSeconds: 120
  ttlSecondsAfterFinished: 300
  template:
    spec:
      restartPolicy: Never
      containers:
        - name: worker
          image: busybox:1.36.1
          command:
            - sh
            - -c
            - |
              echo "processing item"
              sleep 2
这份配置的生效行为是:控制器尽量维持最多 2 个活跃 Pod,累计 6 个成功 Pod 后把 Job 标记为完成;连续失败超过允许重试范围,或总运行时间超过 120 秒,则 Job 进入失败状态。
运行并验证完成状态
将配置保存为 job.yaml 后创建 Job,并等待 Complete 条件出现。这里把等待命令的客户端超时设为 150 秒,略大于 Job 自身的 120 秒截止时间,便于得到明确结果。
kubectl apply -f job.yaml
kubectl wait --for=condition=complete job/batch-demo --timeout=150s
kubectl get job batch-demo预期结果如下;DURATION 与 AGE 的实际时间会不同。
job.batch/batch-demo created
job.batch/batch-demo condition met
NAME         STATUS     COMPLETIONS   DURATION   AGE
batch-demo   Complete   6/6           <TIME>     <TIME>
如果 kubectl wait 超时,不要只重复执行等待命令。应先查看 Job 状态和事件,确认是 Pod 失败、镜像或调度问题,还是 Job 已触发自身截止时间。
理解重试与超时边界
backoffLimit 控制失败后的重试上限,适合限制持续报错的任务占用资源;activeDeadlineSeconds 是整个 Job 的总时间预算,一旦超过截止时间,控制器会终止仍在运行的 Pod,并将 Job 标记为失败。两者同时存在时,总超时可以先于重试次数耗尽发生。
completions: 6 与 parallelism: 2 也不等于严格的“三批两任务”。某些 Pod 可能更快完成,控制器会立即补充新的 Pod,因此应把它理解成“需要 6 次成功,活跃并发最多 2”,而不是固定波次调度。
清理一次性任务
示例已经配置 ttlSecondsAfterFinished: 300,完成或失败后会等待约 300 秒再自动清理。需要立即释放资源时可以手动删除 Job,默认会级联删除其创建的 Pod。
kubectl delete job batch-demo预期输出如下。
job.batch "batch-demo" deletedJob 的关键是把“完成条件、并发上限、失败预算、时间预算”同时写进规范中。完成次数决定什么时候算做完,并行度决定同时跑多少,重试和截止时间则共同限制异常任务的资源消耗。