
容器与云原生 / 系统课时
告警规则与通知
告警规则与通知
告警的目标不是“指标一异常就发消息”,而是把持续、可行动的问题可靠地送到正确的人。本节以 Prometheus 与 Alertmanager 为例,完成规则、持续时间、分组与通知路由的最小闭环。
学习目标
- 编写包含阈值、标签、说明和持续时间的指标告警规则
- 用通知路由控制分组、重复间隔和不同严重级别的接收方
- 通过语法检查与受控故障验证告警链路,减少瞬时抖动和重复通知
先设计一条可行动的告警
一条告警至少要回答三个问题:哪个对象出问题、问题持续多久才算成立、收到后应该做什么。例如 Deployment 暂时少一个副本,几十秒内可能只是滚动发布;如果连续 5 分钟仍存在不可用副本,就更值得通知。
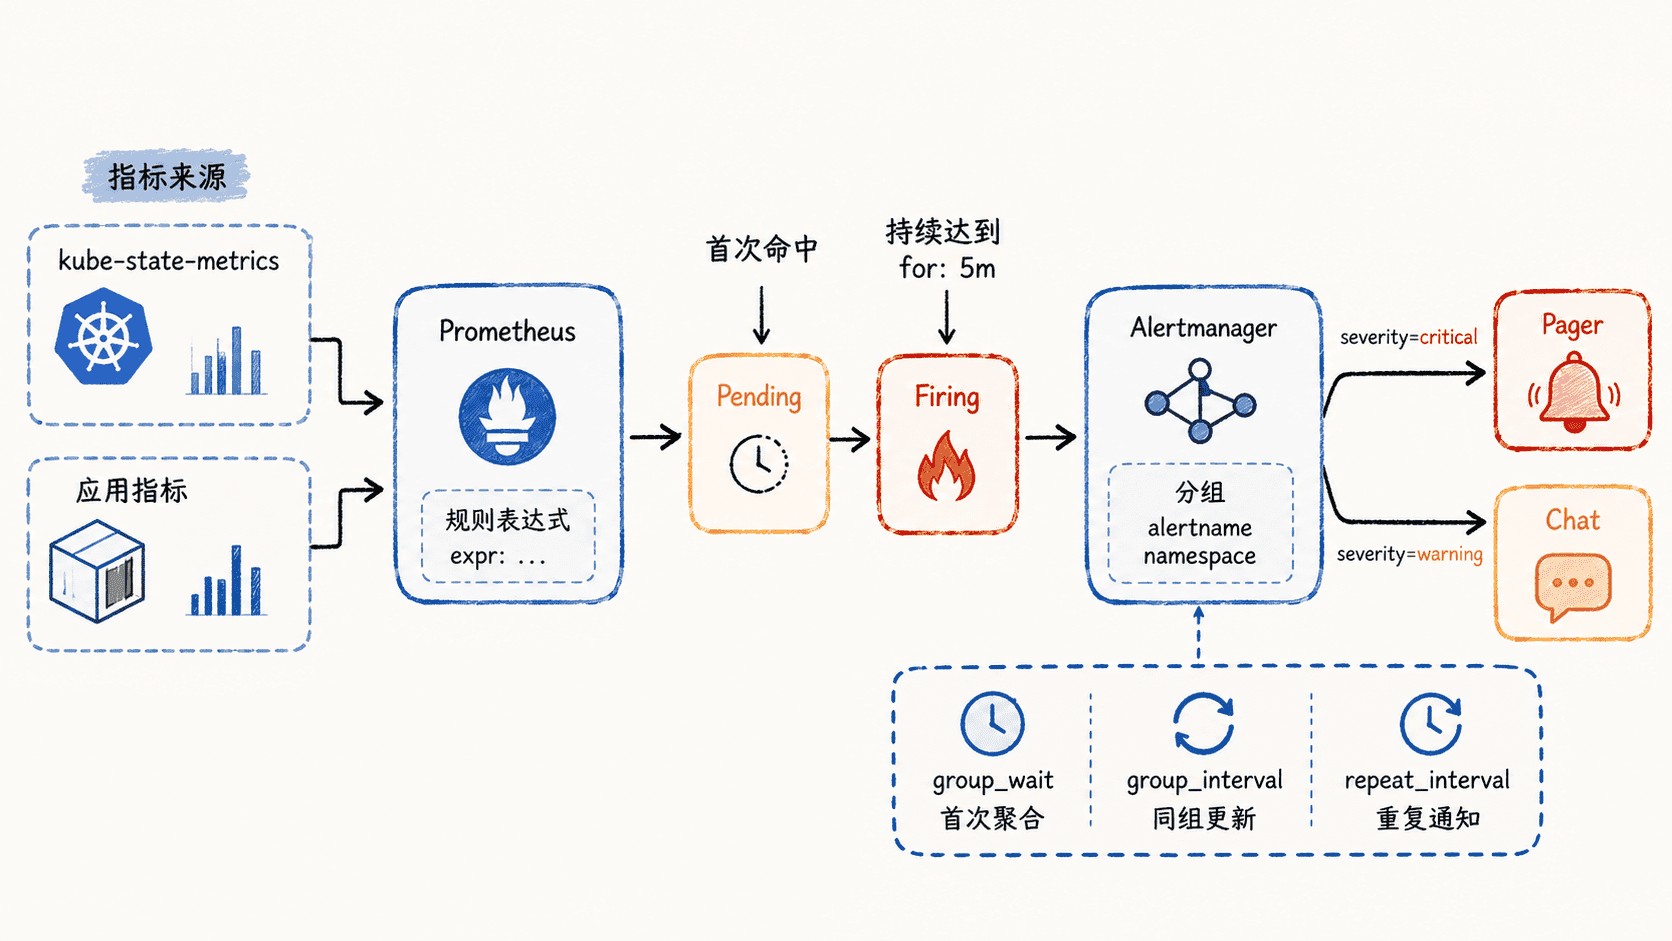
告警链路中会同时出现指标、规则状态、路由和接收方。把这几个对象放在一张图里,比单独记参数更容易理解 for、group_interval 和 repeat_interval 分别解决什么问题。
编写带持续时间的规则
以下规则监控 production 命名空间中 Deployment 的不可用副本,前提是 Prometheus 已采集 kube-state-metrics。for: 5m 表示表达式必须连续成立 5 分钟才进入 Firing;短暂滚动发布即使瞬时命中,也不会立刻通知。
groups:
  - name: kubernetes-workload
    rules:
      - alert: KubeDeploymentReplicasUnavailable
        expr: kube_deployment_status_replicas_unavailable{namespace="production"} > 0
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "Deployment has unavailable replicas"
          description: "Deployment {{ $labels.deployment }} in {{ $labels.namespace }} has unavailable replicas for 5 minutes."
将内容保存为 alerts.yml 后,可以先做规则语法检查。
promtool check rules alerts.yml预期输出
Checking alerts.yml
  SUCCESS: 1 rules found
不同 Prometheus 版本可能附加文件路径或空行,关键结果是检查成功且识别到 1 条规则。生产环境中还要确认 Prometheus 实际加载了该文件;如果使用 Prometheus Operator,应把同样的规则写入 PrometheusRule,并确保对象标签能被 Prometheus 的 ruleSelector 选中。
用路由降低重复通知
规则决定“什么时候算故障”,Alertmanager 路由决定“通知发给谁、怎样合并、多久重复”。下面是一个可直接理解的完整配置示例,接收地址使用占位符,部署时替换为实际 Webhook。
global:
  resolve_timeout: 5m

route:
  receiver: chat
  group_by: ["alertname", "namespace"]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 2h
  routes:
    - matchers:
        - severity="critical"
      receiver: pager
    - matchers:
        - severity="warning"
      receiver: chat

receivers:
  - name: chat
    webhook_configs:
      - url: "<CHAT_WEBHOOK_URL>"
        send_resolved: true
  - name: pager
    webhook_configs:
      - url: "<PAGER_WEBHOOK_URL>"
        send_resolved: true
group_wait 给同一批告警一个短暂聚合窗口,group_interval 控制同组新增或变化后的再次发送,repeat_interval 则避免未恢复故障被高频重复提醒。不要把 repeat_interval 当成告警持续时间;真正过滤瞬时抖动的是规则里的 for。
验证通知闭环
先做语法检查,再通过可控方式制造一次持续超过 for 的异常,观察规则是否经历 Pending 到 Firing,并确认只进入预期接收方。恢复故障后,还要确认 send_resolved: true 能发送恢复通知。
如果规则由 Prometheus Operator 管理,可以先确认规则资源存在;实际名称按你的部署替换。
kubectl get prometheusrule -n <NAMESPACE>预期输出
NAME               AGE
<RULE_NAME>        <TIME>
仅看到资源存在还不代表 Prometheus 已加载规则;最终要以 Prometheus 规则状态和 Alertmanager 通知结果为准。排查无通知时按“指标是否有值 → 表达式是否命中 → for 是否满足 → 告警是否进入 Alertmanager → 路由是否匹配 → 接收端是否成功”这一顺序检查,能避免在接收端反复试错。