
容器与云原生 / 系统课时
排查 Pod 启动失败
排查 Pod 启动失败
Pod 启动失败时,最快的方法不是反复删除重建,而是先判断它停在调度、镜像拉取、容器创建还是进程运行阶段。本节用状态、事件和日志建立一条固定排查路径,覆盖最常见的四类故障。
学习目标
- 根据
Pending、ImagePullBackOff、CreateContainerError和CrashLoopBackOff判断失败阶段 - 用
kubectl get、describe、logs --previous收集能够证明根因的证据 - 修复后用 Ready 条件和重启次数验证问题真正消失
先判断失败发生在哪一层
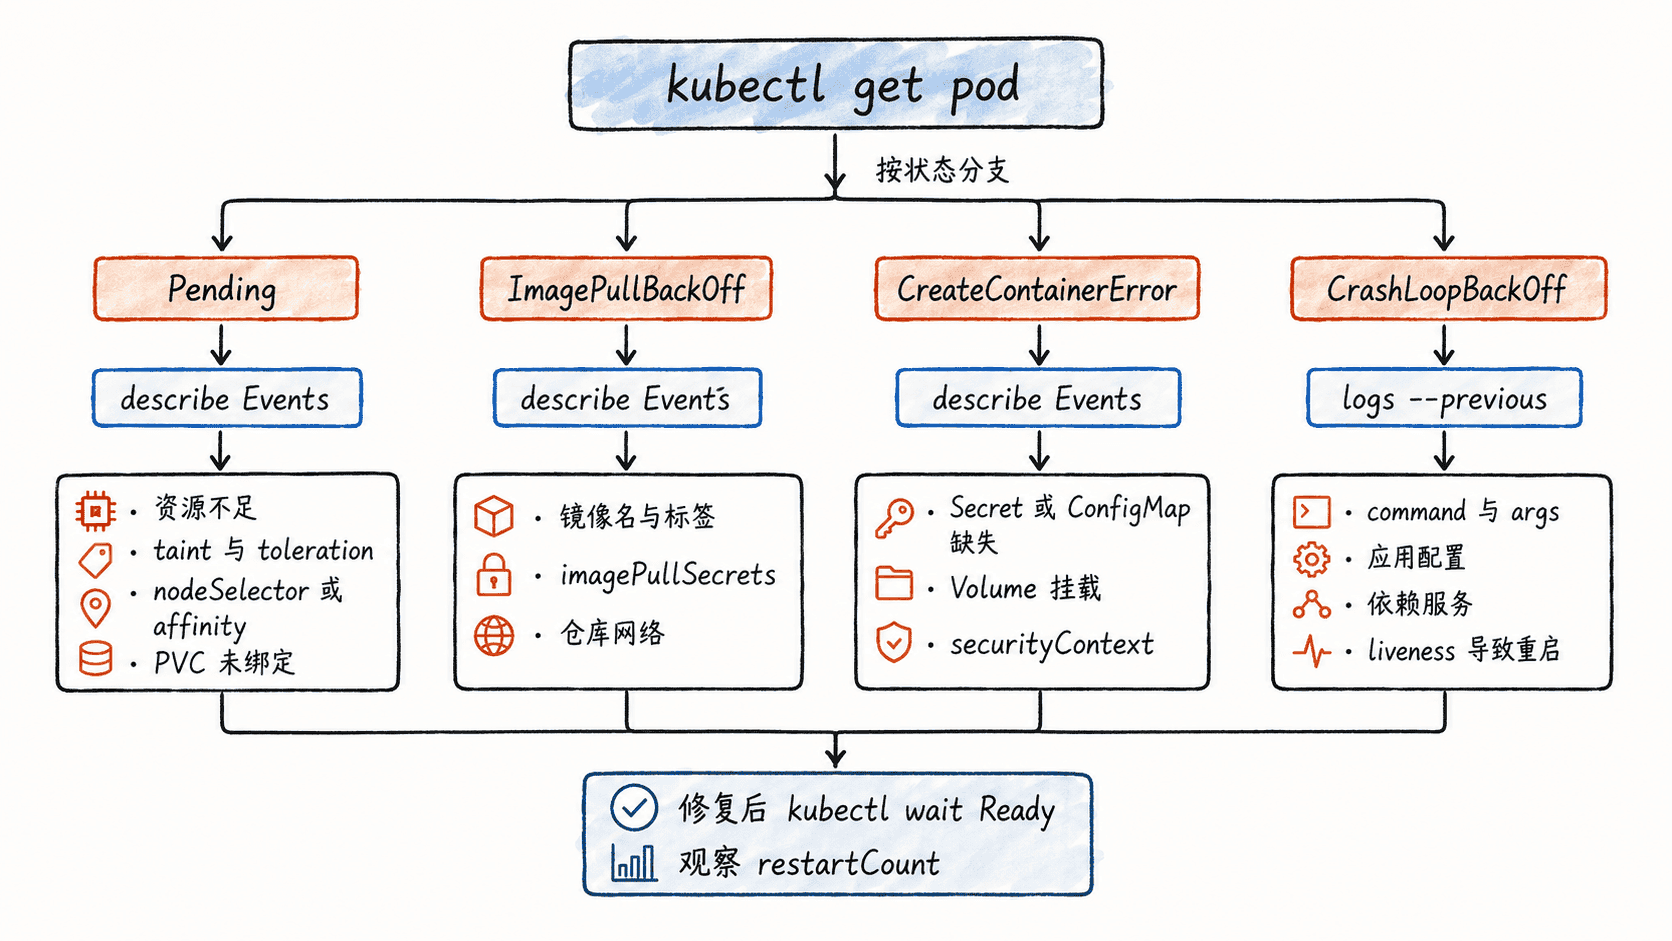
Pod 从提交到稳定运行会经过调度、镜像准备、容器创建和进程运行。状态名称不是根因,而是“故障停在哪个阶段”的线索:Pending 常指向调度或存储,ImagePullBackOff 指向镜像获取,CreateContainerError 指向容器创建前置条件,CrashLoopBackOff 则说明容器已经启动过但持续退出。
先收集状态与事件
先不要删除 Pod。删除会让最有价值的现场证据变少,尤其是上一次容器退出日志。第一步记录当前状态,再看 Events;下面命令中的命名空间和 Pod 名按实际值替换。
kubectl get pod -n <NAMESPACE> <POD> -o wide
kubectl describe pod -n <NAMESPACE> <POD>
预期输出
NAME    READY   STATUS                  RESTARTS   AGE    IP        NODE
<POD>   0/1     <POD_STATUS>            <VALUE>    <TIME> <IP>      <NODE>

Events:
  Type     Reason   Age     From     Message
  <TYPE>   <REASON> <TIME>  <SOURCE> <MESSAGE>
实际列值会不同。重点记录 STATUS、容器状态、Reason 和最后几条 Events,然后再进入对应分支。
按四类状态定位根因
Pending 首先看 FailedScheduling、PVC 绑定和节点约束。常见根因包括 CPU 或内存不足、节点带有未容忍的 taint、nodeSelector 或 affinity 无法匹配、PVC 仍处于 Pending。此时应用日志通常没有价值,因为容器根本还没运行。
ImagePullBackOff 重点看事件中的 Failed to pull image。依次核对镜像仓库地址和 tag、imagePullSecrets 是否存在且被 ServiceAccount 或 Pod 引用、节点到镜像仓库的 DNS 与网络是否正常。先修复最具体的事件错误,不要通过增加重试次数掩盖认证或镜像名错误。
CreateContainerError(以及常见的 CreateContainerConfigError)表示镜像通常已经准备好,但 kubelet 在创建容器或准备其配置时失败。事件里常能直接看到 secret not found、configmap not found、Volume 挂载失败或权限配置错误。对照 Pod 模板检查 Secret、ConfigMap、PVC、挂载路径和 securityContext。
CrashLoopBackOff 与前三类不同:容器已经启动并退出,退避只是 Kubernetes 控制重启频率。最关键的证据是上一次实例的日志,而不是当前刚启动的新进程。
kubectl logs -n <NAMESPACE> <POD> --all-containers=true --previous --tail=100预期输出
<APPLICATION_LOG>
<APPLICATION_ERROR>
实际内容由应用决定。如果返回“previous terminated container not found”,说明该容器还没有可读取的上一实例日志;这时改查当前日志和 describe 中的终止原因。常见根因包括启动命令错误、配置缺失、依赖服务不可达、进程主动退出,以及 liveness probe 反复失败触发重启。
修复后验证是否真正恢复
修复 Deployment、Secret、镜像或存储配置后,不要只看 Pod 从错误状态短暂变成 Running。真正的验收条件是 Pod 达到 Ready,并且重启次数不再持续增长。
kubectl wait --for=condition=Ready pod/<POD> -n <NAMESPACE> --timeout=120s
kubectl get pod -n <NAMESPACE> <POD>
预期输出
pod/<POD> condition met
NAME    READY   STATUS    RESTARTS   AGE
<POD>   1/1     Running   <VALUE>    <TIME>
如果 kubectl wait 超时,继续回到 describe 和日志,而不是再次删除 Pod。稳定的排查习惯应该始终沿着“状态确定阶段 → 事件证明外部失败 → 日志证明进程失败 → 修复 → Ready 与重启次数复验”推进,这样即使故障类型变化,也能快速缩小范围。