
容器与云原生 / 系统课时
Prometheus 指标监控
Prometheus 指标监控
Prometheus 在 Kubernetes 中最关键的不是“装一个监控组件”,而是建立从目标发现、周期抓取、时序存储到 PromQL 查询的完整链路。本节用节点、工作负载和应用三类指标说明采集边界,并用 ServiceMonitor 完成一个可验证的应用抓取配置。
学习目标
- 理解 Kubernetes 服务发现、指标抓取与时序存储之间的关系
- 区分节点资源、工作负载状态和应用业务指标的常见来源
- 配置并验证一个基于
ServiceMonitor的应用指标抓取目标
先看清指标链路
Prometheus 采用拉取模型:它先通过 Kubernetes API 或 Operator 生成的配置发现目标,再按抓取间隔访问目标的 /metrics 端点,把“指标名 + 标签集合 + 时间戳 + 数值”写入时序数据库。Grafana、告警规则和排障查询读取的都是这些已存储样本,而不是直接读取 Pod。
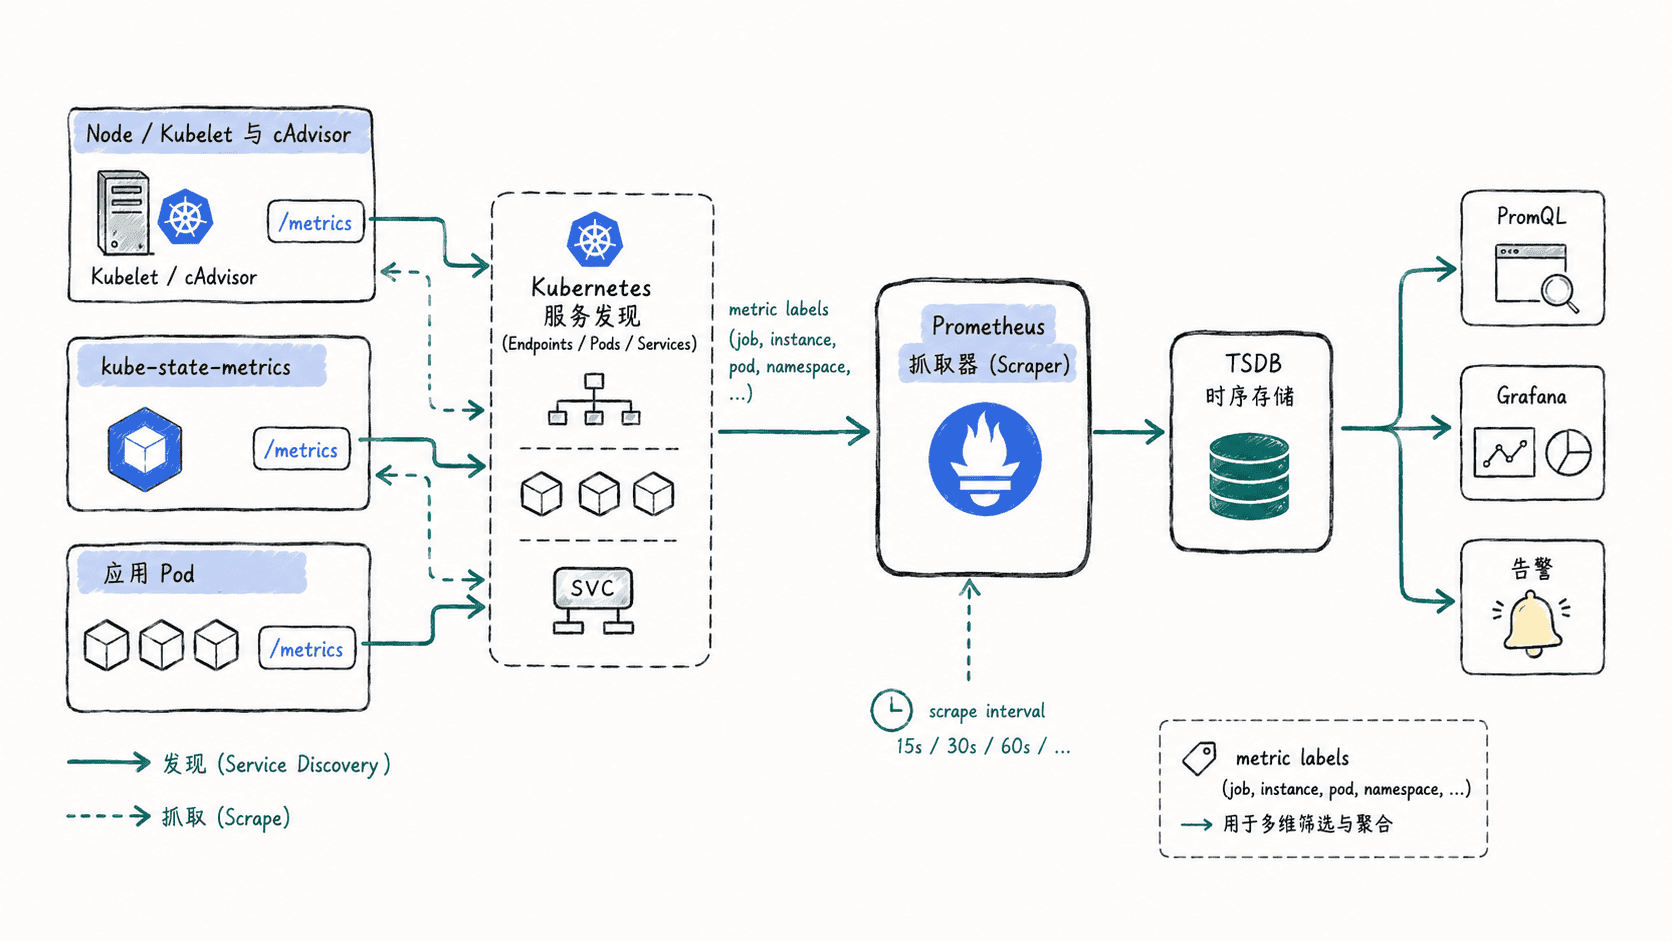
节点和容器资源使用率通常来自 kubelet 暴露的指标,其中容器资源统计与 cAdvisor 数据有关;Kubernetes 对象的期望状态与实际状态通常由 kube-state-metrics 转换成指标,例如 Pod 阶段、副本数和节点条件;应用自身则应主动暴露 HTTP 请求量、延迟、错误数等业务指标。
这三类数据不能互相替代。CPU 很高说明资源压力,但不能直接说明 Deployment 少了副本;Pod 全部 Running 也不能证明接口没有报错。因此仪表盘与告警通常需要组合三个层次的指标。
为应用声明抓取目标
下面假设集群已运行 Prometheus Operator,业务命名空间 default 中已有名为 demo-api 的 Service,并且 Service 的标签为 app: demo-api,指标端口名称为 metrics,应用在 /metrics 暴露 Prometheus 格式指标。ServiceMonitor 选择的是 Service,不是 Deployment。
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: demo-api
  namespace: monitoring
spec:
  namespaceSelector:
    matchNames:
      - default
  selector:
    matchLabels:
      app: demo-api
  endpoints:
    - port: metrics
      path: /metrics
      interval: 30s
将配置保存为 demo-api-monitor.yaml 后创建资源:
kubectl apply -f demo-api-monitor.yaml
kubectl get servicemonitor -n monitoring demo-api
预期输出
servicemonitor.monitoring.coreos.com/demo-api created
NAME       AGE
demo-api   <TIME>
如果是重复应用,第一行可能显示 configured 或 unchanged;AGE 也会随实际创建时间变化。还要确认 Prometheus 的 serviceMonitorNamespaceSelector 能看到 monitoring 命名空间,并且 serviceMonitorSelector 能选中这个对象;某些发行版会要求 ServiceMonitor 带特定标签。
用 PromQL 验证三层数据
先查询抓取健康度。up 为 1 表示最近一次抓取成功,为 0 表示目标已被发现但抓取失败。
up预期结果
up{instance="<IP>:<PORT>",job="<VALUE>"} 1实际标签和值会不同。确认抓取链路通畅后,再按数据层选择指标:节点或容器资源可查询 container_cpu_usage_seconds_total 等 kubelet/cAdvisor 指标;工作负载状态可查询 kube_pod_status_phase 等 kube-state-metrics 指标;应用则查询自己暴露的指标,例如 http_requests_total。如果某个指标根本不存在,应先检查采集源是否部署并被抓取,而不是直接修改 Grafana。
抓取失败时按链路定位
发现失败与抓取失败要分开判断。看不到目标时,先核对 ServiceMonitor 的命名空间选择、Service 标签选择器,以及 Prometheus 是否选择了该 ServiceMonitor。目标已出现但 up=0 时,再检查 Service 端口名称、path、网络策略、TLS 与鉴权配置。
最后直接验证应用自身是否真的在目标端口返回 Prometheus 文本格式。只有“目标可发现、端点可访问、格式可解析、样本持续写入”四个条件同时成立,节点、工作负载和应用指标才算真正进入监控链路。