
容器与云原生 / 系统课时
排查控制平面故障
排查控制平面故障
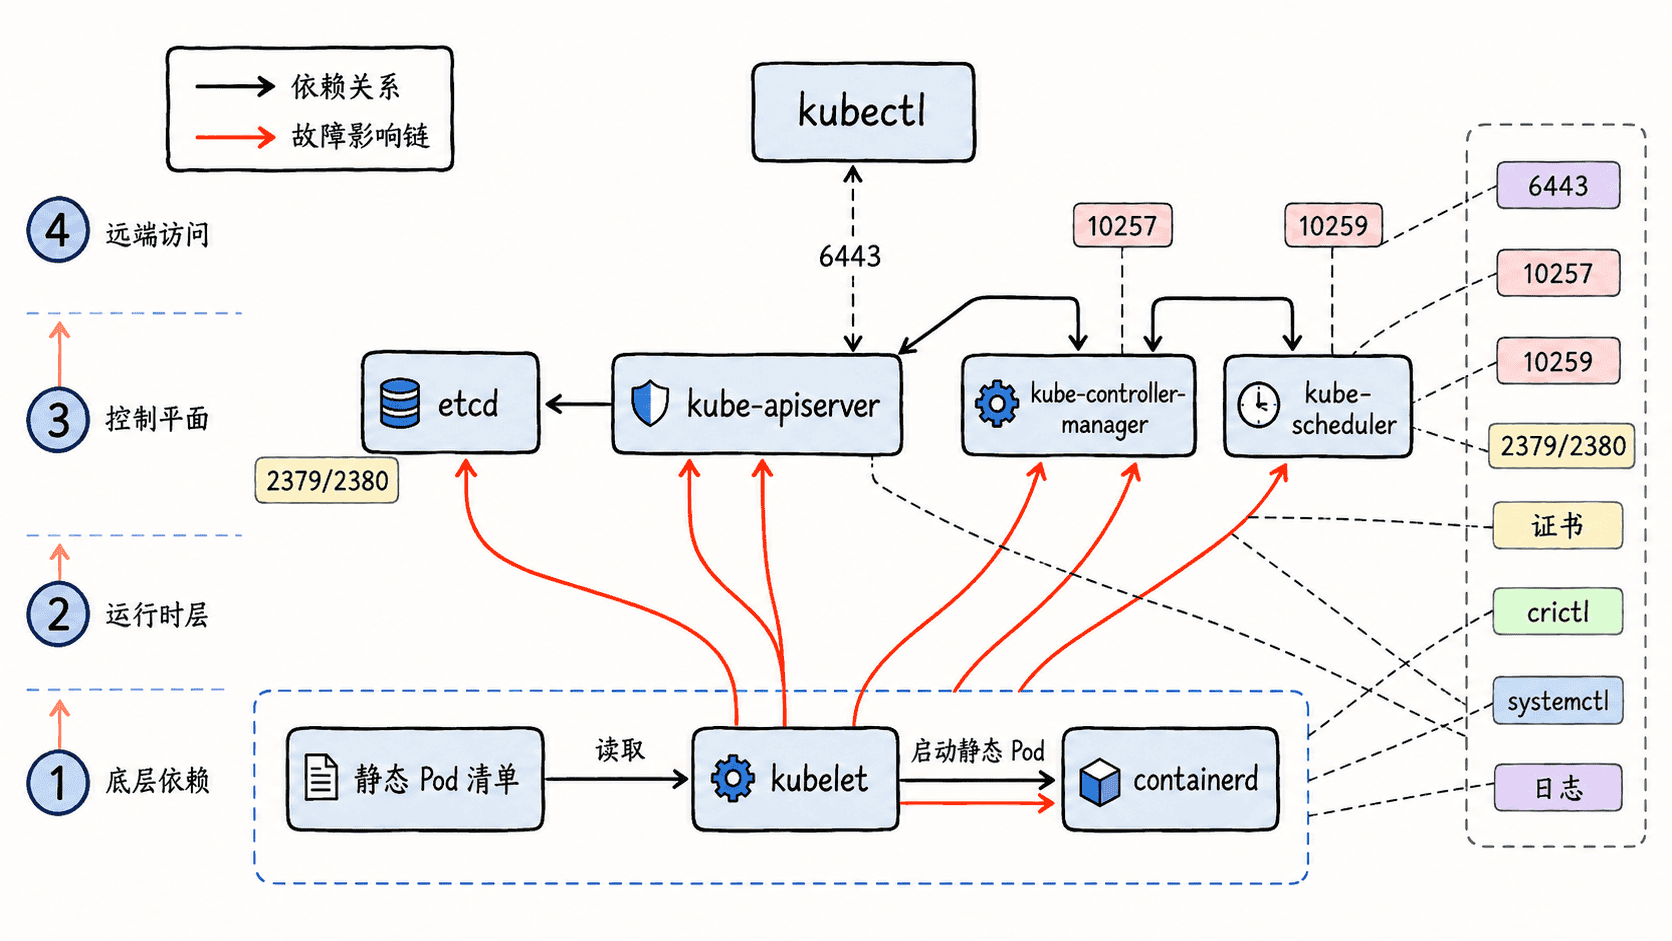
控制平面异常时,kubectl 超时只是表象。更可靠的做法是从控制平面节点本机出发,依次确认 kubelet 与静态 Pod、API Server 端口、组件日志、证书和 etcd 健康状态,再按依赖关系恢复,避免同时重启多个组件导致证据丢失。
学习目标
- 区分 API Server 不可达、静态 Pod 未启动、证书失效和 etcd 异常。
- 使用
crictl、端口检查、组件日志和证书工具建立控制平面证据链。 - 按 etcd → API Server → controller-manager/scheduler 的依赖顺序完成恢复验证。
先判断 API Server 是否真的不可用
如果远端 kubectl 失败,先登录控制平面节点,从本机检查 kubelet、容器和监听端口。对 kubeadm 风格的控制平面,核心组件通常由 kubelet 根据静态 Pod 清单拉起,因此即使 API Server 已不可访问,仍可以用 systemd、crictl 和本机端口继续排查。
sudo systemctl is-active kubelet
sudo crictl ps -a --name kube-apiserver
sudo ss -lntp | grep -E ':6443|:2379|:2380|:10257|:10259'
curl -k https://127.0.0.1:6443/livez
预期输出
active
CONTAINER   IMAGE      CREATED   STATE     NAME
<ID>        <VALUE>    <VALUE>   Running   kube-apiserver
LISTEN <VALUE> 127.0.0.1:2379 <VALUE>
LISTEN <VALUE> <IP>:6443 <VALUE>
ok
如果 6443 没有监听,问题落在 API Server 启动链路;如果 2379 不监听,优先检查 etcd。若 6443 正常且 /livez 返回 ok,远端访问失败更可能是负载均衡、VIP、防火墙、路由或客户端 kubeconfig 问题。
检查静态 Pod 清单与组件日志
下面的路径适用于常见的 kubeadm 管理节点;其他发行版如果使用不同的控制平面部署方式,应以实际 manifest、systemd 单元或托管服务为准。先确认静态 Pod 文件存在,再确认容器是否反复退出。
sudo ls -l /etc/kubernetes/manifests/
sudo crictl ps -a --name kube-apiserver
APISERVER_ID=$(sudo crictl ps -a --name kube-apiserver -q | head -n 1)
sudo crictl logs "$APISERVER_ID" | tail -n 80
预期输出
<VALUE> etcd.yaml
<VALUE> kube-apiserver.yaml
<VALUE> kube-controller-manager.yaml
<VALUE> kube-scheduler.yaml

CONTAINER   IMAGE      CREATED   STATE     NAME
<ID>        <VALUE>    <VALUE>   <VALUE>   kube-apiserver

<TIME> <VALUE>
如果 APISERVER_ID 为空,说明 kubelet 没有成功创建该容器,此时应回头检查 kubelet 日志和 kube-apiserver.yaml 的语法、镜像、挂载与参数。若容器存在但反复退出,组件日志通常能直接指向证书、端口冲突、etcd 连接失败或配置参数错误。
核对证书是否在有效期内
证书过期或节点时间严重偏差,会让 API Server、etcd 或组件之间的 TLS 握手失败。kubeadm 管理的集群可先用 kubeadm 查看证书到期情况,再直接检查关键证书的签发者与有效期。
sudo kubeadm certs check-expiration
sudo openssl x509 -in /etc/kubernetes/pki/apiserver.crt -noout -subject -issuer -dates
预期输出
CERTIFICATE                EXPIRES                  RESIDUAL TIME   CERTIFICATE AUTHORITY
<VALUE>                    <TIME>                   <VALUE>         <VALUE>

subject=<VALUE>
issuer=<VALUE>
notBefore=<TIME>
notAfter=<TIME>
实际表格列和证书列表会随 kubeadm 版本及集群配置变化。重点确认关键证书没有过期,并同时检查主机时间同步;如果集群不是 kubeadm 管理,不要直接套用 kubeadm 的续期命令,而应按照该发行版的证书管理方式处理。
验证 etcd 健康而不是只看进程
etcd 进程存在不代表能提交写入。对 kubeadm 的 stacked etcd,可在 etcd 容器内使用已有客户端证书执行健康检查。外部 etcd 集群应改用实际 endpoint 和凭据。
ETCD_ID=$(sudo crictl ps --name etcd -q | head -n 1)
sudo crictl exec "$ETCD_ID" etcdctl --endpoints=https://127.0.0.1:2379 --cacert=/etc/kubernetes/pki/etcd/ca.crt --cert=/etc/kubernetes/pki/etcd/healthcheck-client.crt --key=/etc/kubernetes/pki/etcd/healthcheck-client.key endpoint health
预期输出
https://127.0.0.1:2379 is healthy: successfully committed proposal: took = <TIME>如果健康检查失败,继续检查 etcd 容器日志、成员状态、磁盘空间、数据目录权限和 2379/2380 端口。多控制平面集群还要确认多数成员可用;没有法定多数时,API Server 即使进程存在也可能无法正常读写集群状态。
按依赖关系恢复并完成验证
修复底层问题后,优先确认 etcd 健康,再确认 API Server 的 livez/readyz,最后检查 controller-manager 和 scheduler。不要一次性重启全部控制平面组件,否则很难判断究竟是哪一层恢复了服务。
sudo KUBECONFIG=/etc/kubernetes/admin.conf kubectl get --raw='/livez?verbose'
sudo KUBECONFIG=/etc/kubernetes/admin.conf kubectl get --raw='/readyz?verbose'
sudo KUBECONFIG=/etc/kubernetes/admin.conf kubectl get nodes
sudo crictl ps --name kube-controller-manager
sudo crictl ps --name kube-scheduler
预期输出
[+]ping ok
<VALUE>
livez check passed

[+]ping ok
<VALUE>
readyz check passed

NAME      STATUS   ROLES           AGE      VERSION
<VALUE>   Ready    control-plane   <VALUE>  <VALUE>

CONTAINER   IMAGE      CREATED   STATE     NAME
<ID>        <VALUE>    <VALUE>   Running   kube-controller-manager
CONTAINER   IMAGE      CREATED   STATE     NAME
<ID>        <VALUE>    <VALUE>   Running   kube-scheduler
<VALUE> 代表不同版本可能出现的其他健康检查项或节点信息。最终应同时满足:etcd 可提交请求、API Server 的 livez/readyz 通过、控制平面节点可查询、controller-manager 与 scheduler 持续运行,并且远端客户端重新能通过正常入口访问 6443。