
容器与云原生 / 系统课时
节点排空与维护
节点排空与维护
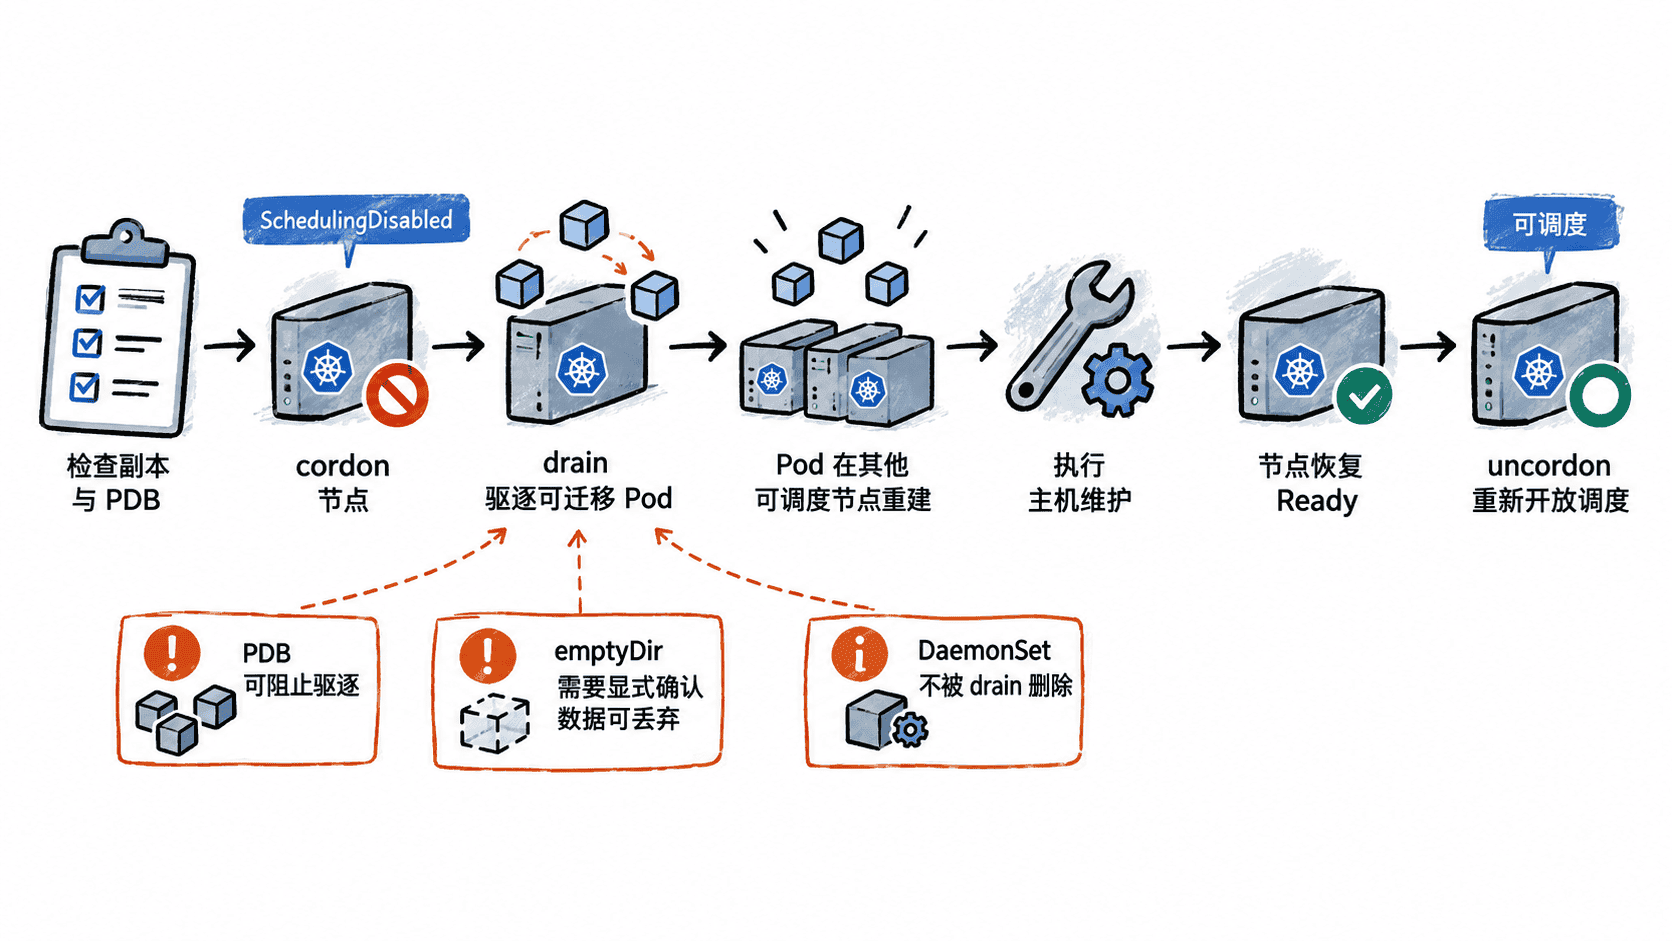
节点维护的关键不是把机器直接关掉,而是先停止新调度,再按中断策略迁移可驱逐工作负载,完成维护后重新开放调度。本节用 cordon、drain 和 uncordon 串起标准流程,并说明 DaemonSet、本地临时数据和 PDB 的限制。
学习目标
- 能按正确顺序执行节点下线、排空和恢复
- 能判断 DaemonSet、
emptyDir与 PodDisruptionBudget 对排空的影响 - 能在维护前后验证节点与 Pod 状态
维护前确认影响范围
先确认目标节点上的 Pod、业务副本数和中断预算。只有当关键工作负载在其他节点有可用副本,或业务明确允许短暂中断时,才进入排空流程。
kubectl get pods -A --field-selector spec.nodeName=<NODE> -o custom-columns=NAMESPACE:.metadata.namespace,NAME:.metadata.name,PHASE:.status.phase,NODE:.spec.nodeName
kubectl get pdb -A -o custom-columns=NAMESPACE:.metadata.namespace,NAME:.metadata.name,ALLOWED:.status.disruptionsAllowed
预期输出
NAMESPACE   NAME    PHASE     NODE
<NS>        <POD>   Running   <NODE>
NAMESPACE   NAME    ALLOWED
<NS>        <PDB>   <VALUE>
重点看是否存在单副本关键 Pod、允许中断数为 0 的 PDB,以及依赖节点本地数据的工作负载。实际名称和数值会随集群变化。
用 cordon 和 drain 转移工作负载
cordon 只把节点标记为不可调度,不会移动已经运行的 Pod;drain 会保持节点不可调度,并通过驱逐流程处理可迁移 Pod。显式先执行 cordon,便于把“停止新工作负载进入节点”和“迁移现有工作负载”分成两个可观察阶段。
kubectl cordon <NODE>
kubectl drain <NODE> --ignore-daemonsets --grace-period=60 --timeout=10m
预期输出
node/<NODE> cordoned
node/<NODE> already cordoned
evicting pod <NAMESPACE>/<POD>
pod/<POD> evicted
node/<NODE> drained
实际会按 Pod 数量输出多条驱逐记录。如果命令在超时前没有完成,不要直接关机;先读取报错,确认是 PDB、本地数据、非受管 Pod还是终止时间过长造成阻塞。
处理三个常见限制
DaemonSet Pod 不会被 drain 删除,因为控制器通常需要它们继续承担节点级职责,所以常规排空需要 --ignore-daemonsets 才能继续。节点维护结束后,这些 Pod 会继续运行或由 DaemonSet 控制器恢复。
如果 Pod 使用 emptyDir,默认排空会阻止继续执行,避免无意删除节点本地临时数据。只有确认这些数据可以丢弃时,才加 --delete-emptydir-data;数据库文件、未落盘缓存或任务中间结果不能仅凭“会重建 Pod”就判断安全。
PDB 会限制自愿中断数量。若允许中断数为 0,应先恢复副本、等待其他 Pod 就绪或调整业务维护计划。--disable-eviction 会绕过基于 Eviction API 的 PDB 保护,不应作为常规维护的默认选项。
恢复调度并验收
主机维护完成后,先确认 kubelet、容器运行时和网络组件恢复,再把节点重新设为可调度。随后检查节点状态,必要时继续观察 DaemonSet 与业务 Pod 是否回到稳定状态。
kubectl uncordon <NODE>
kubectl get node <NODE>
预期输出
node/<NODE> uncordoned
NAME     STATUS   ROLES    AGE     VERSION
<NODE>   Ready    <ROLE>   <TIME>  <VERSION>
cordon 负责阻止新 Pod 进入,drain 负责在中断约束内迁出现有工作负载,uncordon 负责恢复调度资格。把这三个动作和维护前检查、维护后验收组合起来,才能把节点维护从“关机操作”变成可控的集群变更。