
容器与云原生 / 系统课时
备份与恢复 etcd
备份与恢复 etcd
etcd 保存 Kubernetes 控制平面的关键状态。本节完成一次可验证的快照备份,并按 kubeadm 常见的静态 Pod 布局演练恢复,让你知道备份文件是否可用、恢复时要停什么,以及控制平面何时算真正恢复。
学习目标
- 使用 TLS 凭据创建 etcd 快照,并读取快照的 revision、键数量和大小
- 将快照恢复到新的数据目录,避免直接覆盖现有数据
- 按控制平面可用性和对象状态验证恢复结果
先确认备份边界
etcd 快照包含 Kubernetes API 对象状态,例如 Deployment、Secret、RBAC 和自定义资源,但不包含持久卷里的业务数据,也不替代外部数据库备份。快照本身可能含有 Secret 等敏感信息,因此应放入受控目录,并在离开节点后使用加密、访问控制和异地副本保护。
下面以 kubeadm 常见的本地 etcd 为例,端点为 https://127.0.0.1:2379,证书位于 /etc/kubernetes/pki/etcd/。如果使用外置 etcd 或发行版定制路径,应先从 etcd 或 kube-apiserver 的实际启动参数确认端点和证书位置。
创建并验证快照
先创建权限收紧的备份目录,再从一个在线 etcd 成员保存快照。<TIME> 代表实际执行时间,建议替换为可排序的时间戳。
sudo install -d -m 0700 /var/backups/etcd
SNAPSHOT="/var/backups/etcd/snapshot-<TIME>.db"

sudo ETCDCTL_API=3 etcdctl \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key \
  snapshot save "$SNAPSHOT"
预期输出:
Snapshot saved at /var/backups/etcd/snapshot-<TIME>.db创建成功不等于备份可恢复,还要读取快照状态。较新的 etcd 使用 etcdutl 检查快照;不要只看文件是否存在。
SNAPSHOT="/var/backups/etcd/snapshot-<TIME>.db"
sudo etcdutl --write-out=table snapshot status "$SNAPSHOT"
预期输出类似:
+---------+----------+------------+------------+
|  HASH   | REVISION | TOTAL KEYS | TOTAL SIZE |
+---------+----------+------------+------------+
| <VALUE> | <VALUE>  | <VALUE>    | <VALUE>    |
+---------+----------+------------+------------+
HASH、revision、键数量和大小会随集群变化。备份任务应同时记录快照文件、生成时间、etcd 版本、集群标识和状态检查结果,并把快照复制到与控制平面故障域隔离的位置。
从快照恢复控制平面数据
恢复的关键不是“把旧文件拷回去”,而是从快照生成新的 etcd 数据目录,再让 etcd 静态 Pod 指向它。这样原目录仍可作为故障回退证据,也能避免新旧成员数据混用。
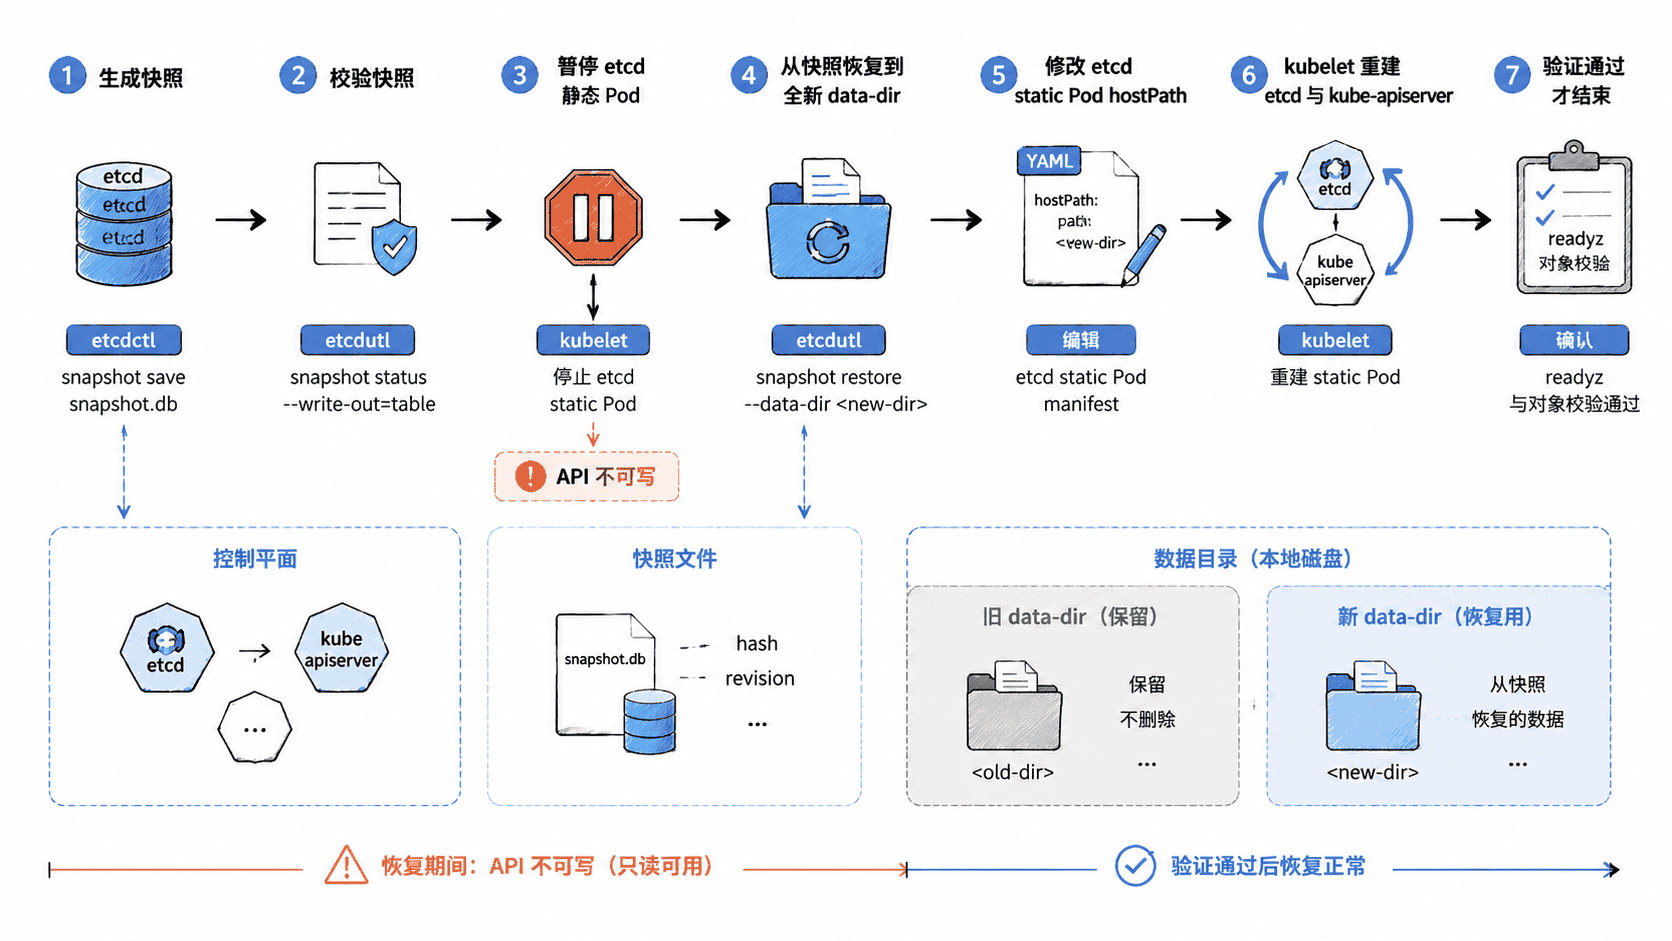
下面的单节点演练先把静态 Pod 清单移出监控目录,再恢复到新目录。etcdutl snapshot restore 会创建目标目录,因此目标路径必须事先不存在。
SNAPSHOT="/var/backups/etcd/snapshot-<TIME>.db"

sudo mv /etc/kubernetes/manifests/etcd.yaml /etc/kubernetes/etcd.yaml.off
sudo rm -rf /var/lib/etcd-from-backup
sudo etcdutl snapshot restore "$SNAPSHOT" \
  --data-dir=/var/lib/etcd-from-backup
sudo test -d /var/lib/etcd-from-backup/member && echo RESTORE_DIR_READY
预期结果:
RESTORE_DIR_READY对于支持 revision bump 的较新 etcd,Kubernetes 场景恢复旧快照时应结合 --bump-revision 与 --mark-compacted 设计恢复命令,以使 watch 客户端重新建立缓存;是否可用应以当前 etcdutl snapshot restore --help 为准。不要为了兼容示例而在不支持的版本上强行添加参数。
接着把原静态 Pod 清单中的 etcd-data 主机路径切换到新数据目录。容器内的 /var/lib/etcd 挂载点和 --data-dir 参数保持不变,只修改宿主机 hostPath.path。
sudo sed 's#path: /var/lib/etcd#path: /var/lib/etcd-from-backup#' \
  /etc/kubernetes/etcd.yaml.off \
  | sudo tee /etc/kubernetes/manifests/etcd.yaml >/dev/null

grep -q 'path: /var/lib/etcd-from-backup' \
  /etc/kubernetes/manifests/etcd.yaml && echo MANIFEST_SWITCHED
预期输出:
MANIFEST_SWITCHEDkubelet 发现静态 Pod 清单重新出现后,会使用新 hostPath 重建 etcd,随后 kube-apiserver 才可能恢复服务。
验证恢复是否真的成功
首先检查 API Server 就绪端点;只有返回 ok,才继续核对业务对象和控制器状态。
kubectl get --raw='/readyz'预期输出:
ok随后核对快照时应该存在的 Namespace、Deployment、StatefulSet、RBAC 与自定义资源,并确认快照之后才创建的测试对象没有“穿越”回来。还要观察控制器是否重新获得 leader、节点是否 Ready,以及关键工作负载是否能重新调度。
真正可靠的 etcd 备份标准不是“定时生成了一个 .db 文件”,而是快照能通过状态检查、能在隔离环境恢复成新的数据目录,并且恢复后的 Kubernetes API 与关键对象都能通过验收。