
容器与云原生 / 系统课时
集群日志架构
集群日志架构
单个 Pod 可以用 kubectl logs 排查,但生产集群中的 Pod 会扩缩容、重建并分散到多个节点。本节建立集中式日志链路:由节点级代理持续读取容器日志,经处理和缓冲后发送到独立存储,再通过查询系统统一检索。
学习目标
- 识别节点级日志代理、日志后端和查询层的职责边界
- 理解从容器标准输出到集中存储的数据流
- 根据可靠性、容量和查询需求规划日志链路
集中式日志链路
应用最简单可靠的职责是把结构化日志写到 stdout 或 stderr,而不是自行连接远端日志服务。节点级采集代理通常以 DaemonSet 运行,每个节点部署一个实例,读取本节点容器日志并补充 namespace、Pod、container 等 Kubernetes 元数据。
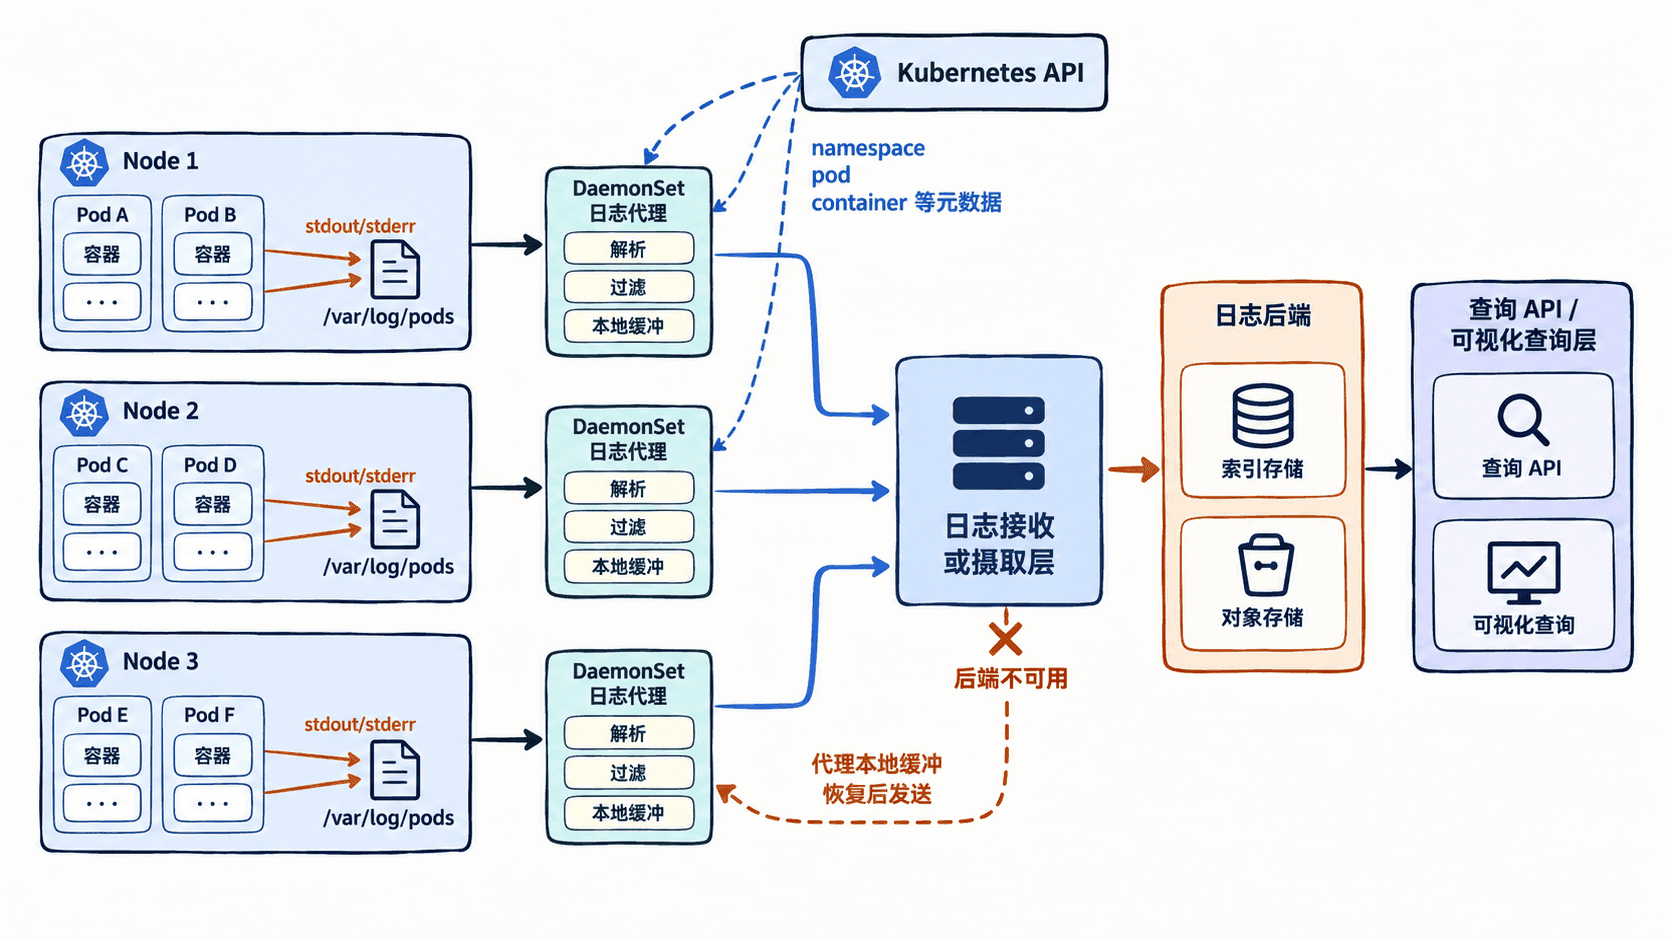
这条链路把应用生命周期与日志生命周期解耦。即使 Pod 被删除,只要日志已经发送到独立后端,仍然可以按照工作负载、时间和标签检索历史记录。
节点级代理负责什么
节点级代理的核心任务不是简单复制文件,而是稳定地完成读取、解析、补充元数据、过滤和转发。采用 DaemonSet 可以让新增节点自动获得采集实例,也避免每个业务 Pod 都额外运行一个日志 sidecar。
如果集群已经部署日志代理,可以先确认它是否覆盖了预期节点。下面假设代理位于 <NAMESPACE>,名称为 <LOG_AGENT>:
kubectl get daemonset <LOG_AGENT> -n <NAMESPACE>预期输出:
NAME          DESIRED   CURRENT   READY   UP-TO-DATE   AVAILABLE   NODE SELECTOR   AGE
<LOG_AGENT> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <TIME>正常情况下,DESIRED、CURRENT、READY 和 AVAILABLE 应与需要采集日志的节点数量相符;实际值取决于节点选择器、污点容忍和代理健康状态。如果某个节点没有对应代理,该节点上的日志就可能形成采集盲区。
代理通常只需要以只读方式访问容器日志目录,并获得读取必要 Kubernetes 元数据的最小权限。不要为了方便直接授予广泛的集群管理权限,也不要让采集器修改宿主机日志文件。
存储与查询层怎么分工
采集代理之后通常还有摄取、存储和查询三个逻辑职责。它们可以由同一产品实现,也可以拆成多个组件,因此设计时应先明确职责,而不是先绑定具体软件。
摄取层负责接收并控制写入压力;存储层负责索引、压缩、保留周期和冷热数据;查询层负责根据时间、namespace、Pod、容器、应用标签以及日志正文检索数据。日志量很大时,索引字段越多并不一定越好,高基数字段会显著提高存储和查询成本。
为故障设计缓冲和背压
集中式日志系统本身也会故障。如果后端短暂不可用,节点代理应有受限的内存或磁盘缓冲,并在恢复后继续发送;如果积压持续增长,则必须设置容量上限和丢弃策略,避免日志采集反过来耗尽节点磁盘。
因此规划链路时至少要回答三个问题:后端不可用多久仍允许保留日志、缓冲满后优先丢弃哪些日志、恢复发送时允许给后端多大压力。很多日志链路提供的是至少一次传输语义,网络重试可能产生重复记录,业务分析不能默认每条日志绝对只出现一次。
验收一条集中式日志链路
部署完成后,不应只检查 DaemonSet 为 READY。更可靠的验收方法是选择一个测试 Pod 写入带唯一标识的日志,然后确认该标识能够经过节点代理进入集中后端,并能在约定时间内查询到。
kubectl run log-check --image=busybox:1.36 --restart=Never -- sh -c 'echo log-check-<ID>; sleep 30'
kubectl logs log-check
预期输出:
log-check-<ID>随后在集中式查询系统中检索同一个 log-check-<ID>。若 kubectl logs 能看到而后端查不到,应沿“节点文件 → 代理读取 → 缓冲与发送 → 摄取端 → 存储索引”方向逐段检查,而不是先修改应用。验证结束后可删除测试 Pod;真正可用的集群日志架构,应在 Pod 生命周期结束之后仍能按照保留策略查询到已经采集的历史日志。