
容器与云原生 / 系统课时
备份应用资源与数据
备份应用资源与数据
应用备份不能只导出 YAML,也不能只做磁盘快照。本节把 Kubernetes 资源、持久卷和外部数据库拆成独立备份层,给出可执行的保留与恢复顺序,使一次恢复能够重新得到“配置正确、数据一致、服务可用”的应用。
学习目标
- 划分 Kubernetes 资源、持久卷和外部数据库的备份范围
- 为不同数据层设置 RPO、保留周期和副本位置
- 按依赖关系恢复资源与数据,并用应用级检查完成验收
先做备份范围清单
etcd 备份解决的是集群状态灾难恢复,但应用级恢复通常还要面对单个 Namespace 误删、PVC 损坏、数据库回滚或跨集群迁移。最少应把备份拆成三层,并为每层指定恢复负责人和验证方法。
| 备份层 | 典型对象 | 备份重点 | 恢复验收 |
|---|---|---|---|
| Kubernetes 资源 | Deployment、StatefulSet、Service、ConfigMap、Secret、RBAC、CRD/CR | 保留声明式配置和必要的集群级依赖 | 对象可创建,引用关系完整 |
| 持久卷数据 | PVC 对应的块存储或文件系统 | CSI/存储后端快照、跨故障域副本、应用一致性 | 新 PVC 可挂载,关键文件或数据页可读 |
| 外部数据服务 | 托管数据库、对象存储、消息系统 | 服务原生备份、PITR 日志、账号与网络依赖 | 恢复到目标时间点,应用能读写 |
备份 Kubernetes 资源
声明式 Git 仓库应是资源配置的首选来源,但生产备份仍应保存“当时实际存在什么”的清单,尤其是运行时生成的 RBAC、Operator 自定义资源和 PVC。下面用 payments Namespace 做一次最小资源导出,<TIME> 需要替换为实际时间戳。
BACKUP_DIR="/var/backups/payments-<TIME>"
mkdir -p "$BACKUP_DIR"

kubectl get -n payments \
  deployment,statefulset,daemonset,service,configmap,secret,serviceaccount,role,rolebinding,ingress,pvc \
  -o yaml > "$BACKUP_DIR/resources.yaml"

test -s "$BACKUP_DIR/resources.yaml" && echo RESOURCE_BACKUP_READY
预期输出:
RESOURCE_BACKUP_READY这个导出适合盘点和应急取证,但其中会包含 resourceVersion、uid、status 等服务端字段,不应不经清理就当作唯一恢复源。正式方案应同时备份 CRD、集群级 RBAC、StorageClass、Operator 及其自定义资源,并使用经过验证的备份工具或 GitOps 清单恢复声明式对象。
备份持久卷与外部数据库
如果 CSI 驱动、snapshot-controller 和 VolumeSnapshot CRD 都可用,可以用卷快照保存 PVC 的存储状态。先确认集群中存在适配当前存储驱动的 VolumeSnapshotClass,再创建快照;下面的类名只是示例,必须替换为集群真实值。
apiVersion: snapshot.storage.k8s.io/v1
kind: VolumeSnapshot
metadata:
  name: payments-data-backup
  namespace: payments
spec:
  volumeSnapshotClassName: <VALUE>
  source:
    persistentVolumeClaimName: payments-data
将配置保存为 volume-snapshot.yaml 后创建快照,并等待它进入可恢复状态。
kubectl apply -f volume-snapshot.yaml
kubectl wait -n payments \
  --for=jsonpath='{.status.readyToUse}'=true \
  volumesnapshot/payments-data-backup \
  --timeout=5m
预期结果:
volumesnapshot.snapshot.storage.k8s.io/payments-data-backup created
volumesnapshot.snapshot.storage.k8s.io/payments-data-backup condition met
卷快照不天然等于应用一致性备份。正在写数据库的进程可能只得到崩溃一致性快照,因此数据库应优先使用数据库或云服务原生备份,并按业务需要保留事务日志、WAL 或 binlog 以支持时间点恢复。外部数据库还要记录版本、实例参数、账号权限、加密密钥引用和网络入口,否则“数据已恢复”也可能无法重新接入应用。
设计保留策略与恢复顺序
先由业务给出 RPO 和 RTO,再反推频率与保留期。一个常见起点是保留 7 个每日副本、4 个每周副本和 6 个每月副本;关键数据库如果要求更小 RPO,应再配连续日志或服务端 PITR。至少保留一份跨故障域副本,并定期验证不可变副本真的能读取。
恢复顺序必须按依赖关系执行,而不是按“哪个文件先找到”执行。
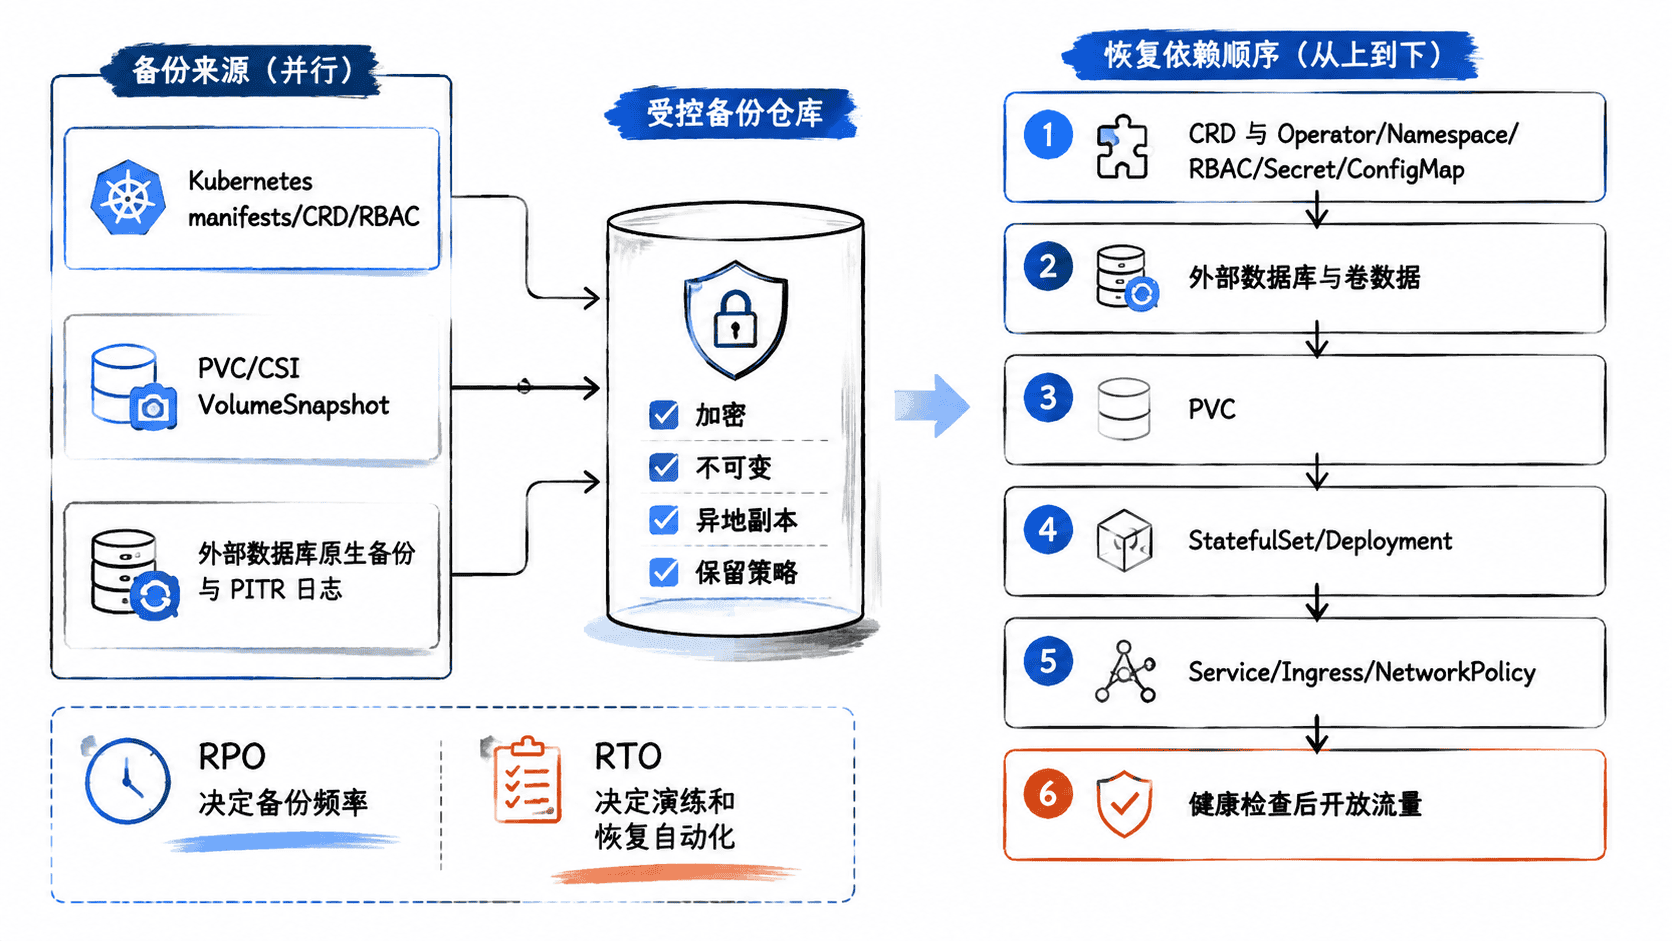
实际恢复时,先恢复 CRD、Operator、Namespace、RBAC、Secret 和 ConfigMap 等前置依赖;随后恢复外部数据库与卷数据,再创建 PVC;数据可读后才启动 StatefulSet、Deployment 等工作负载;最后恢复 Service、Ingress、NetworkPolicy 等流量路径,并在健康检查通过后开放入口。这样可以避免应用在旧数据、空卷或缺少配置时提前启动并写入错误状态。
用恢复演练验证备份
每次演练都应记录恢复开始时间、数据恢复到的时间点和业务恢复完成时间,用它们反证 RPO/RTO 是否真实可达。验收至少覆盖资源、存储和业务三层:关键对象存在,PVC 为 Bound 且数据校验通过,外部数据库时间点正确,应用健康检查成功,核心读写链路可以完成。
备份策略最终应形成一张可执行清单:备什么、多久备一次、保存多久、存在哪里、先恢复什么、谁负责验证。只有这些答案都能在隔离环境中复现,应用备份才具备生产恢复价值。