
容器与云原生 / 系统课时
Kubernetes 集群架构
Kubernetes 集群架构
理解 Kubernetes 的关键不是记住组件名称,而是看清两类职责:控制平面负责接收目标状态并做出全局决策,工作节点负责真正运行应用并执行这些决策。掌握这条主线后,后续学习 Pod、Deployment 和调度机制会更容易定位到整体架构中。
学习目标
- 区分控制平面与工作节点承担的职责
- 认识 API Server、etcd、Scheduler、Controller Manager 与节点组件的协作关系
- 能沿着一次工作负载创建过程说明关键组件如何配合
集群由控制平面和工作节点组成
Kubernetes 集群可以先理解成两个区域。控制平面维护整个集群的目标状态并进行协调;工作节点提供 CPU、内存和运行时环境,真正承载业务容器。一个集群通常拥有多个工作节点,生产环境中的控制平面也会通过多副本提高可用性。
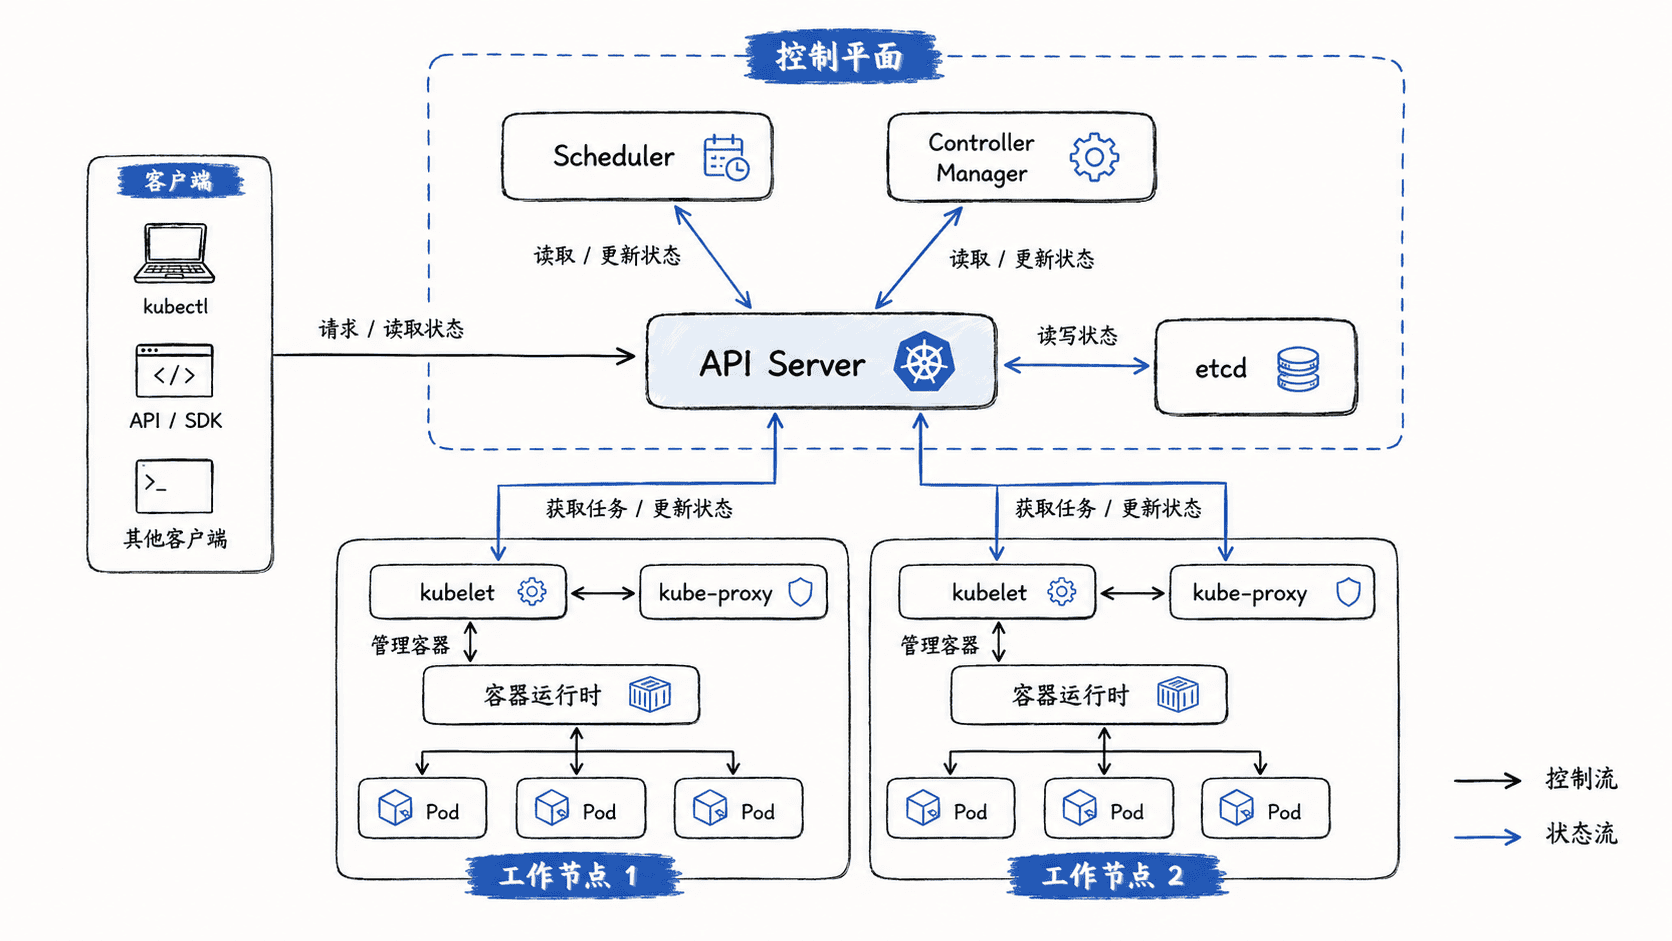
这套架构最重要的边界是:控制平面通常不直接启动业务容器,而是通过集群状态和节点代理驱动工作节点完成实际操作。这样,集群决策与具体节点执行可以分离。
API Server 是控制平面的统一入口
API Server 是 Kubernetes 控制平面的核心入口。用户、自动化系统以及其他控制平面组件,都通过 Kubernetes API 查询或修改资源。创建 Deployment、读取 Pod 状态、更新配置等行为,最终都会经过这个入口。
这种设计意味着各组件通常不会彼此随意直接修改内部数据,而是围绕统一 API 协作。权限认证、准入控制以及资源对象校验也集中在这条请求链路上,因此理解 Kubernetes 时可以把 API Server 看作整个集群的“交通枢纽”。
etcd 保存集群需要持久化的状态
etcd 是 Kubernetes 使用的分布式键值存储,用于保存集群资源和控制状态。API Server 将需要持久化的数据写入 etcd,并从中读取当前资源信息。
etcd 并不负责运行 Pod,也不负责决定 Pod 放在哪台机器上。它的重要性在于保存集群事实,因此生产环境需要特别关注它的数据可靠性、备份和高可用。若持久状态不可恢复,即使工作节点上的部分容器仍暂时运行,控制平面也无法可靠地继续管理整个集群。
调度器与控制器负责做决定
Scheduler 关注尚未确定运行节点的 Pod。它根据资源需求、节点可用容量和调度约束选择合适节点,并把调度结果写回集群状态。它负责的是“选择节点”,而不是亲自在目标节点启动容器。
Controller Manager 中运行着多种控制器。控制器持续比较期望状态和实际状态,并尝试消除差异。例如期望有 3 个副本而当前只有 2 个时,相关控制器会推动系统创建缺少的实例。Kubernetes 的自愈能力,本质上就建立在这种持续协调机制之上。
工作节点执行应用运行任务
每个工作节点上的 kubelet 负责关注分配给本节点的 Pod,并通过容器运行时创建、停止和检查容器。容器运行时承担实际的容器生命周期操作,而 kubelet负责把节点上的实际运行状态反馈给控制平面。
节点网络还需要让 Service 等抽象能够把流量送到正确的后端。传统集群中通常可以看到 kube-proxy 参与实现服务转发规则;实际生产环境也可能由不同网络插件采用其他数据平面实现,因此不要把某一种转发实现误认为 Kubernetes API 的唯一实现方式。
一次创建过程如何串起所有组件
假设用户提交一个需要多个副本的工作负载。请求首先进入 API Server,资源的期望状态被持久化;控制器观察到需要创建新的 Pod,于是生成相应对象;Scheduler 为尚未绑定节点的 Pod 选择工作节点;目标节点上的 kubelet发现新的任务后调用容器运行时启动容器,并持续上报状态。
这条链路体现了 Kubernetes 架构的核心思想:API Server 统一承载状态交互,etcd保存持久状态,控制器不断协调差异,调度器完成节点选择,工作节点负责落地执行。后续遇到任何 Kubernetes 资源,都可以先判断它处于“声明状态、控制决策还是节点执行”中的哪一层。