
容器与云原生 / 系统课时
排查节点异常
排查节点异常
节点进入 NotReady 时,关键不是先重启 kubelet,而是先判断故障落在资源压力、kubelet 心跳、容器运行时还是 CNI 网络。按照从集群视角到节点本机的顺序收集证据,可以更快定位根因,并避免把短暂恢复误当成问题已经解决。
学习目标
- 根据
NodeCondition、事件和 Lease 判断节点失联还是本机组件异常。 - 按系统资源、kubelet、containerd、CNI 的顺序定位
NotReady根因。 - 修复后用节点状态和节点上的系统 Pod 验证恢复是否稳定。
先用 NodeCondition 缩小故障面
先从控制端查看节点状态和事件,不要一上来登录节点执行重启。Ready=False 表示 kubelet 仍在上报但当前无法提供正常工作能力;Ready=Unknown 更常见于控制平面长时间收不到 kubelet 心跳。MemoryPressure、DiskPressure、PIDPressure 则直接指向对应资源压力。
kubectl get nodes -o wide
kubectl describe node worker-1
kubectl get lease -n kube-node-lease worker-1
预期输出
NAME       STATUS     ROLES    AGE      VERSION   INTERNAL-IP
worker-1   NotReady   <none>   <VALUE>  <VALUE>   <IP>

Conditions:
  Type             Status   Reason
  MemoryPressure   False    KubeletHasSufficientMemory
  DiskPressure     False    KubeletHasNoDiskPressure
  PIDPressure      False    KubeletHasSufficientPID
  Ready            False    KubeletNotReady

NAME       HOLDER     AGE
worker-1   worker-1   <VALUE>
实际的时间、版本、IP 和 Reason 可能不同。重点是把 Ready 与三个 Pressure 条件、节点事件一起看:如果压力条件为 True,先解决资源问题;如果 Ready 为 Unknown,优先检查 kubelet、主机网络和节点到 API Server 的连通性。
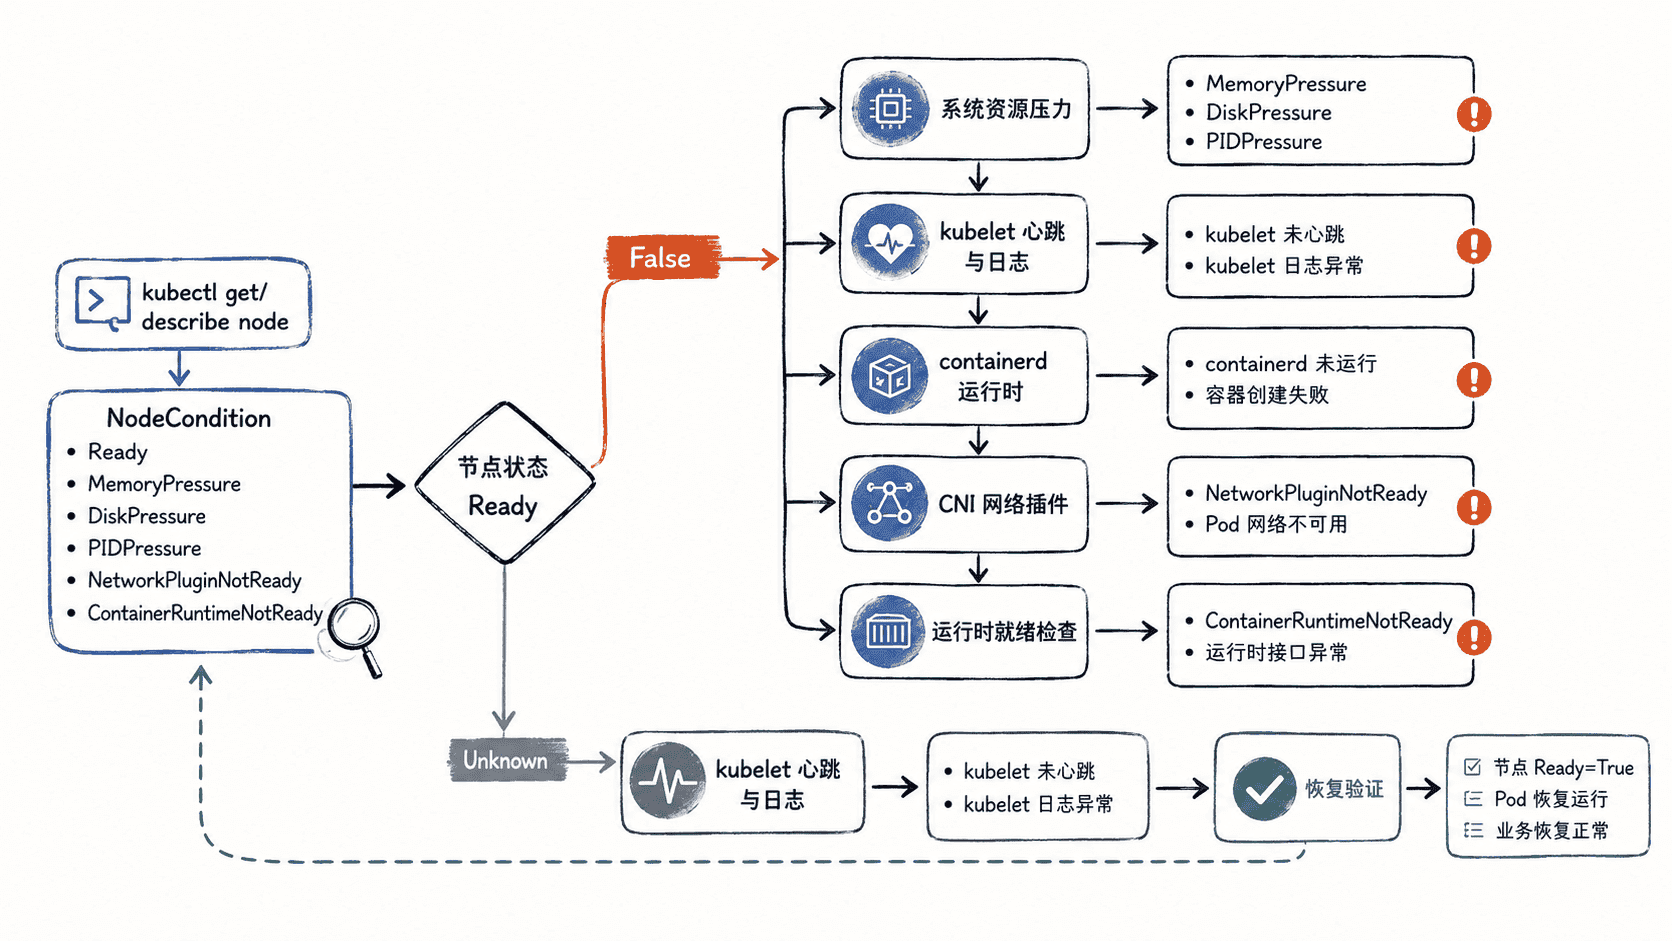
在节点本机检查资源和核心服务
登录异常节点后,先确认磁盘、内存和 PID 没有耗尽,再检查 kubelet 与 containerd。磁盘空间充足但 inode 耗尽同样会导致镜像、日志或临时文件无法创建,因此 df -h 和 df -i 应一起检查。
df -h
df -i
free -h
systemctl is-active kubelet
systemctl is-active containerd
预期输出
Filesystem      Size  Used Avail Use% Mounted on
<VALUE>         <VALUE> <VALUE> <VALUE> <VALUE> /
Filesystem      Inodes IUsed IFree IUse% Mounted on
<VALUE>         <VALUE> <VALUE> <VALUE> <VALUE> /
               total        used        free
Mem:           <VALUE>     <VALUE>     <VALUE>
active
active
如果 kubelet 或 containerd 不是 active,继续看服务状态和最近日志。先找到退出原因,再决定是否重启;直接重启可能暂时恢复,却会覆盖故障发生时最有价值的线索。
sudo systemctl status kubelet --no-pager
sudo journalctl -u kubelet --since "15 min ago" -n 80 --no-pager
sudo systemctl status containerd --no-pager
sudo journalctl -u containerd --since "15 min ago" -n 80 --no-pager
预期输出
● kubelet.service - kubelet: The Kubernetes Node Agent
   Active: active (running) since <TIME>
<TIME> <VALUE> kubelet[<PID>]: <VALUE>

● containerd.service - containerd container runtime
   Active: active (running) since <TIME>
<TIME> <VALUE> containerd[<PID>]: <VALUE>
这里的 <VALUE> 应替换为现场日志内容。重点搜索认证失败、磁盘错误、PLEG 不健康、容器运行时不可达、CNI 未初始化等信息,而不是只看服务进程是否存在。
把 kubelet、containerd 与 CNI 分开验证
kubelet 负责节点状态和 Pod 生命周期,containerd 负责容器运行,CNI 插件负责 Pod 网络。三者任何一层失败都可能让节点不可用,因此要分别验证,不要把“containerd 正常”直接等同于“节点正常”。
sudo crictl info
sudo crictl ps -a
ls -la /etc/cni/net.d/
kubectl -n kube-system get pods -o wide --field-selector spec.nodeName=worker-1
预期输出
<container runtime information>
<container list, including system containers if present>
total <VALUE>
<VALUE> <CNI_CONFIG_FILE>

NAME      READY   STATUS    RESTARTS   AGE      IP     NODE
<VALUE>   <VALUE> <VALUE>   <VALUE>    <VALUE>  <IP>   worker-1
crictl info 应能正常返回运行时信息;如果命令连接不到 runtime socket,先处理 containerd。若 kubelet 日志出现 NetworkPluginNotReady,继续检查 /etc/cni/net.d/、对应 CNI DaemonSet 在该节点上的 Pod 状态和日志。不同网络插件的资源名称不同,不要把某个插件名写死成通用判断条件。
按根因修复而不是按症状重启
资源压力导致的 NotReady,应先释放磁盘、inode、内存或 PID,并确认压力条件回落。containerd 异常时先修复配置、存储或 socket 问题,再重启 containerd;kubelet 配置、证书或连接异常时先修复对应原因,再重启 kubelet。
sudo systemctl restart containerd
sudo systemctl restart kubelet
sudo systemctl is-active containerd kubelet
预期输出
active
active
只有在日志已经指向服务异常且根因已处理后,才执行上述重启。若问题来自 CNI,应优先恢复该插件在异常节点上的 DaemonSet Pod,并确认配置文件重新就绪,而不是反复重启 kubelet。
验证 Ready 恢复并保持稳定
修复完成后,不只看一次 Ready。还要确认 Lease 持续更新、节点事件不再产生新错误,节点上的 kube-system Pod 回到正常状态。等待一小段观察窗口能发现“服务刚重启就短暂变绿、随后再次失败”的问题。
kubectl get node worker-1
kubectl get lease -n kube-node-lease worker-1
kubectl -n kube-system get pods -o wide --field-selector spec.nodeName=worker-1
kubectl describe node worker-1
预期输出
NAME       STATUS   ROLES    AGE      VERSION
worker-1   Ready    <none>   <VALUE>  <VALUE>

NAME       HOLDER     AGE
worker-1   worker-1   <VALUE>

NAME      READY   STATUS    RESTARTS   AGE      IP     NODE
<VALUE>   <VALUE> Running   <VALUE>    <VALUE>  <IP>   worker-1
最终判断标准是节点持续保持 Ready、Lease 持续刷新、系统 Pod 正常运行且事件中没有新的资源、运行时或网络错误。这样得到的是可解释的恢复链路,而不是一次偶然变绿。