
容器与云原生 / 系统课时
执行故障演练与验收
执行故障演练与验收
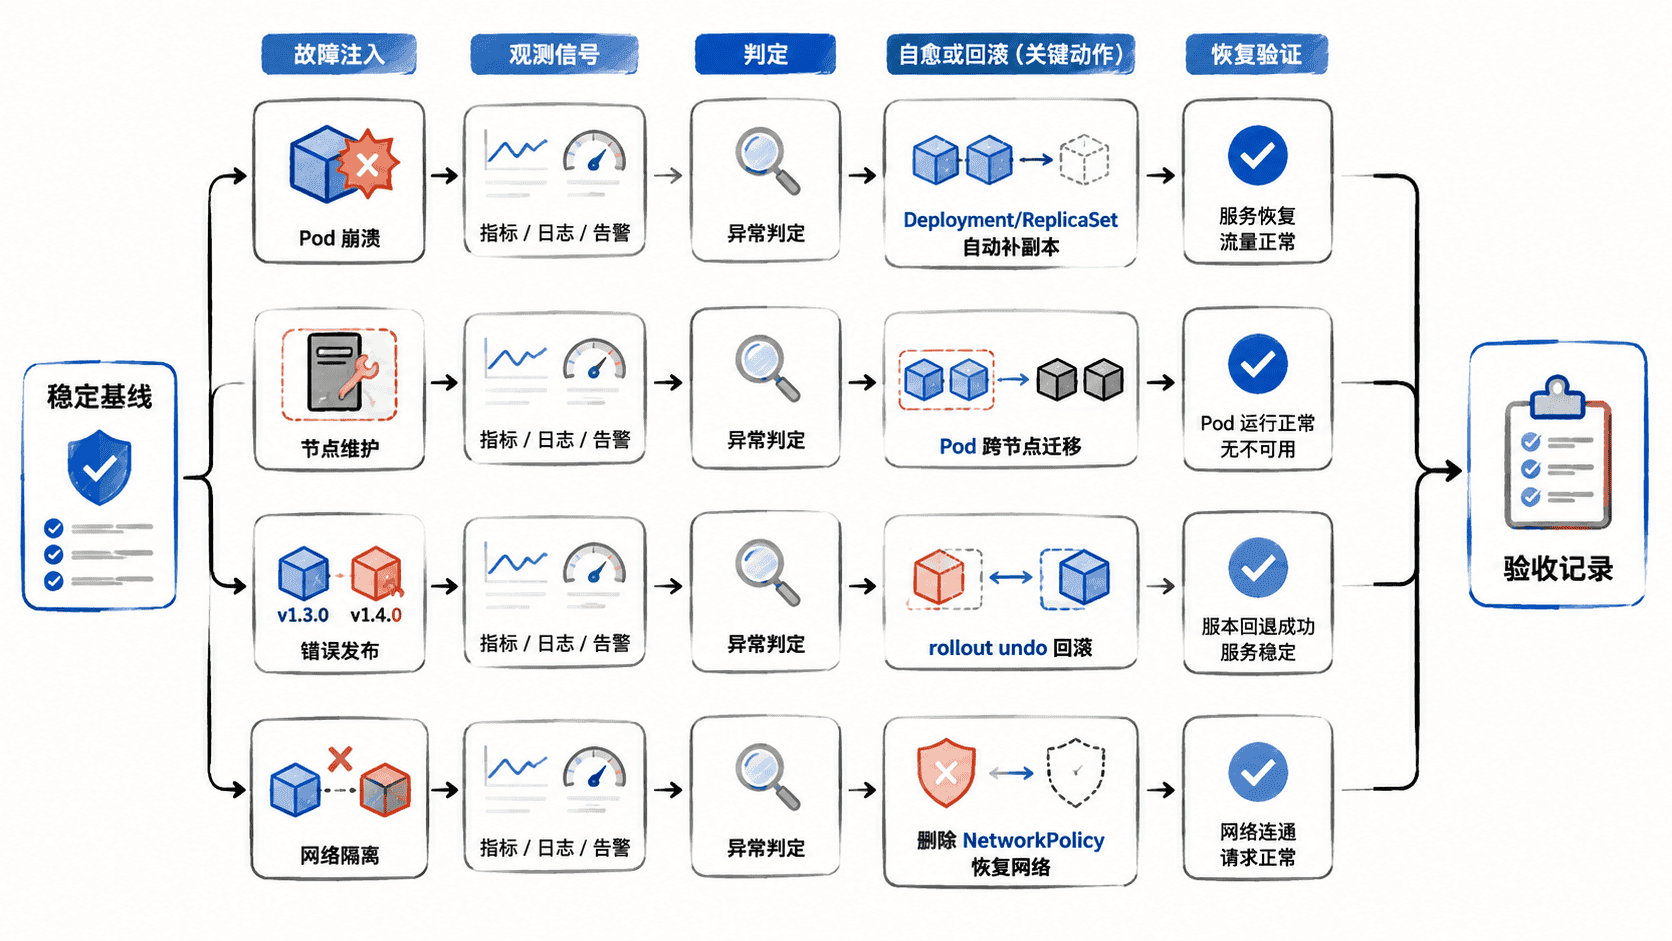
本节把上线验收从“服务能访问”提升为“故障发生后仍能被发现并恢复”。你将依次注入 Pod 崩溃、节点维护、错误发布和网络隔离,并用可重复的证据验收自愈、告警、回滚与恢复闭环。
学习目标
- 能在受控环境中注入四类常见 Kubernetes 故障,并限制故障影响范围。
- 能用 Deployment 状态、Pod 事件、服务连通性和告警记录判断自愈是否符合预期。
- 能完成错误发布回滚、网络恢复和节点恢复,并形成可审计的验收结果。
建立演练基线
故障演练应在预发布环境或明确维护窗口执行,先确认 Deployment 副本健康、历史版本可回滚,并记录当前时间。后续所有“恢复成功”都要与这份基线对比,而不是只看某个 Pod 是否重新变成 Running。
kubectl get deployment/<DEPLOYMENT> -n <NAMESPACE> -o jsonpath='{.status.readyReplicas}/{.spec.replicas}{"\n"}'
kubectl rollout history deployment/<DEPLOYMENT> -n <NAMESPACE>
预期输出
<DESIRED>/<DESIRED>

deployment.apps/<DEPLOYMENT>
REVISION  CHANGE-CAUSE
<ID>      <VALUE>
实际修订号、时间和 CHANGE-CAUSE 可能不同。若就绪副本少于期望副本,先解决现有故障,不要在不健康基线上继续注入新故障。
验证 Pod 崩溃后的自愈
用删除单个运行中 Pod 模拟 Pod 丢失或崩溃,重点验证 Deployment/ReplicaSet 是否自动补足副本。不要手工创建新 Pod,否则会绕过控制器自愈机制。
kubectl delete pod <POD> -n <NAMESPACE>
until [ "$(kubectl get deployment/<DEPLOYMENT> -n <NAMESPACE> -o jsonpath='{.status.readyReplicas}')" = "$(kubectl get deployment/<DEPLOYMENT> -n <NAMESPACE> -o jsonpath='{.spec.replicas}')" ]; do
  sleep 2
done
echo "replicas: recovered"
kubectl get pods -n <NAMESPACE> -l app=<APP> -o wide
预期输出
pod "<POD>" deleted
replicas: recovered
<NEW_POD>   1/1   Running   <VALUE>   <TIME>   <IP>   <NODE>
Pod 名称、IP、节点和耗时会变化。验收时确认期望副本数恢复、服务仍可访问,并检查监控平台是否按既定策略产生“副本不足”或“Pod 不可用”信号;如果告警规则故意忽略极短抖动,应以规则设计为准,而不是为了演练强行制造告警噪声。
验证节点维护时的迁移
节点维护演练关注的是调度与可用性,而不是强制杀死所有 Pod。先 cordon 阻止新 Pod 调度,再 drain 驱逐可迁移工作负载,观察业务 Pod 是否被调度到其他节点。生产环境执行前必须确认 PodDisruptionBudget、剩余节点容量和本地数据风险。
kubectl cordon <NODE>
kubectl drain <NODE> --ignore-daemonsets --grace-period=30
kubectl get pods -n <NAMESPACE> -o wide
kubectl uncordon <NODE>
预期输出
node/<NODE> cordoned
pod/<POD> evicted
node/<NODE> drained
<NEW_POD>   1/1   Running   <VALUE>   <TIME>   <IP>   <OTHER_NODE>
node/<NODE> uncordoned
若 drain 被 PodDisruptionBudget 阻止,这通常说明保护机制正在生效,不应直接视为失败。需要判断维护窗口是否满足最小可用副本要求;验收结束后必须确认节点已解除 cordon,避免节点长期处于不可调度状态。
验证错误发布的回滚
最容易验证的错误发布是把容器镜像临时改成不存在的标签。新的 ReplicaSet 会拉取失败,而滚动更新通常会保留旧副本继续服务,这正好可以验证发布告警和回滚链路。
kubectl set image deployment/<DEPLOYMENT> <CONTAINER>=<IMAGE>:not-found-drill -n <NAMESPACE>
kubectl get pods -n <NAMESPACE> -l app=<APP>
预期输出
deployment.apps/<DEPLOYMENT> image updated
<OLD_POD>   1/1   Running            <VALUE>   <TIME>
<NEW_POD>   0/1   ImagePullBackOff   <VALUE>   <TIME>
确认发布失败被监控或发布平台识别后立即回滚,不要等待错误状态长期存在。
kubectl rollout undo deployment/<DEPLOYMENT> -n <NAMESPACE>
kubectl rollout status deployment/<DEPLOYMENT> -n <NAMESPACE> --timeout=120s
预期输出
deployment.apps/<DEPLOYMENT> rolled back
deployment "<DEPLOYMENT>" successfully rolled out
验收重点不是看到 undo 命令成功,而是旧版本副本重新全部 Ready、错误 Pod 消失、服务恢复,并且相关告警从触发态回到恢复态。
验证网络中断与最终验收
网络故障可以用临时 NetworkPolicy 隔离目标 Pod 的入站流量。该方法只适用于已经支持并启用 NetworkPolicy 的 CNI;执行前还应准备一个带 curl 的诊断 Pod <CLIENT_POD>,并确认健康检查地址 <PATH> 在正常状态下可访问。
kubectl exec <CLIENT_POD> -n <NAMESPACE> -- curl -fsS --connect-timeout 3 http://<SERVICE>:<PORT>/<PATH> >/dev/null && echo "baseline: reachable"预期输出
baseline: reachable随后创建仅针对本应用的拒绝入站策略。
cat <<'YAML' | kubectl apply -f -
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: drill-deny-ingress
  namespace: <NAMESPACE>
spec:
  podSelector:
    matchLabels:
      app: <APP>
  policyTypes:
    - Ingress
  ingress: []
YAML

if kubectl exec <CLIENT_POD> -n <NAMESPACE> -- curl -fsS --connect-timeout 3 http://<SERVICE>:<PORT>/<PATH> >/dev/null 2>&1; then
  echo "unexpected: reachable"
else
  echo "expected: blocked"
fi
预期输出
networkpolicy.networking.k8s.io/drill-deny-ingress created
expected: blocked
确认网络异常被监控捕获后,删除策略并验证服务恢复。
kubectl delete networkpolicy drill-deny-ingress -n <NAMESPACE>
kubectl exec <CLIENT_POD> -n <NAMESPACE> -- curl -fsS --connect-timeout 3 http://<SERVICE>:<PORT>/<PATH> >/dev/null && echo "recovered: reachable"
预期输出
networkpolicy.networking.k8s.io "drill-deny-ingress" deleted
recovered: reachable
最终验收不要只记录“恢复了”。应为四个场景分别留下故障开始时间 <TIME>、首次检测时间 <TIME>、恢复时间 <TIME>、触发与恢复的告警、执行过的回滚或恢复动作,并与团队定义的检测时限和恢复目标比较。只有 Pod 能自动补副本、节点维护不破坏可用性、错误发布可快速回滚、网络隔离可解除且告警状态最终收敛,才算完成一次可重复的上线故障验收。