
容器与云原生 / 系统课时
集群容量规划
集群容量规划
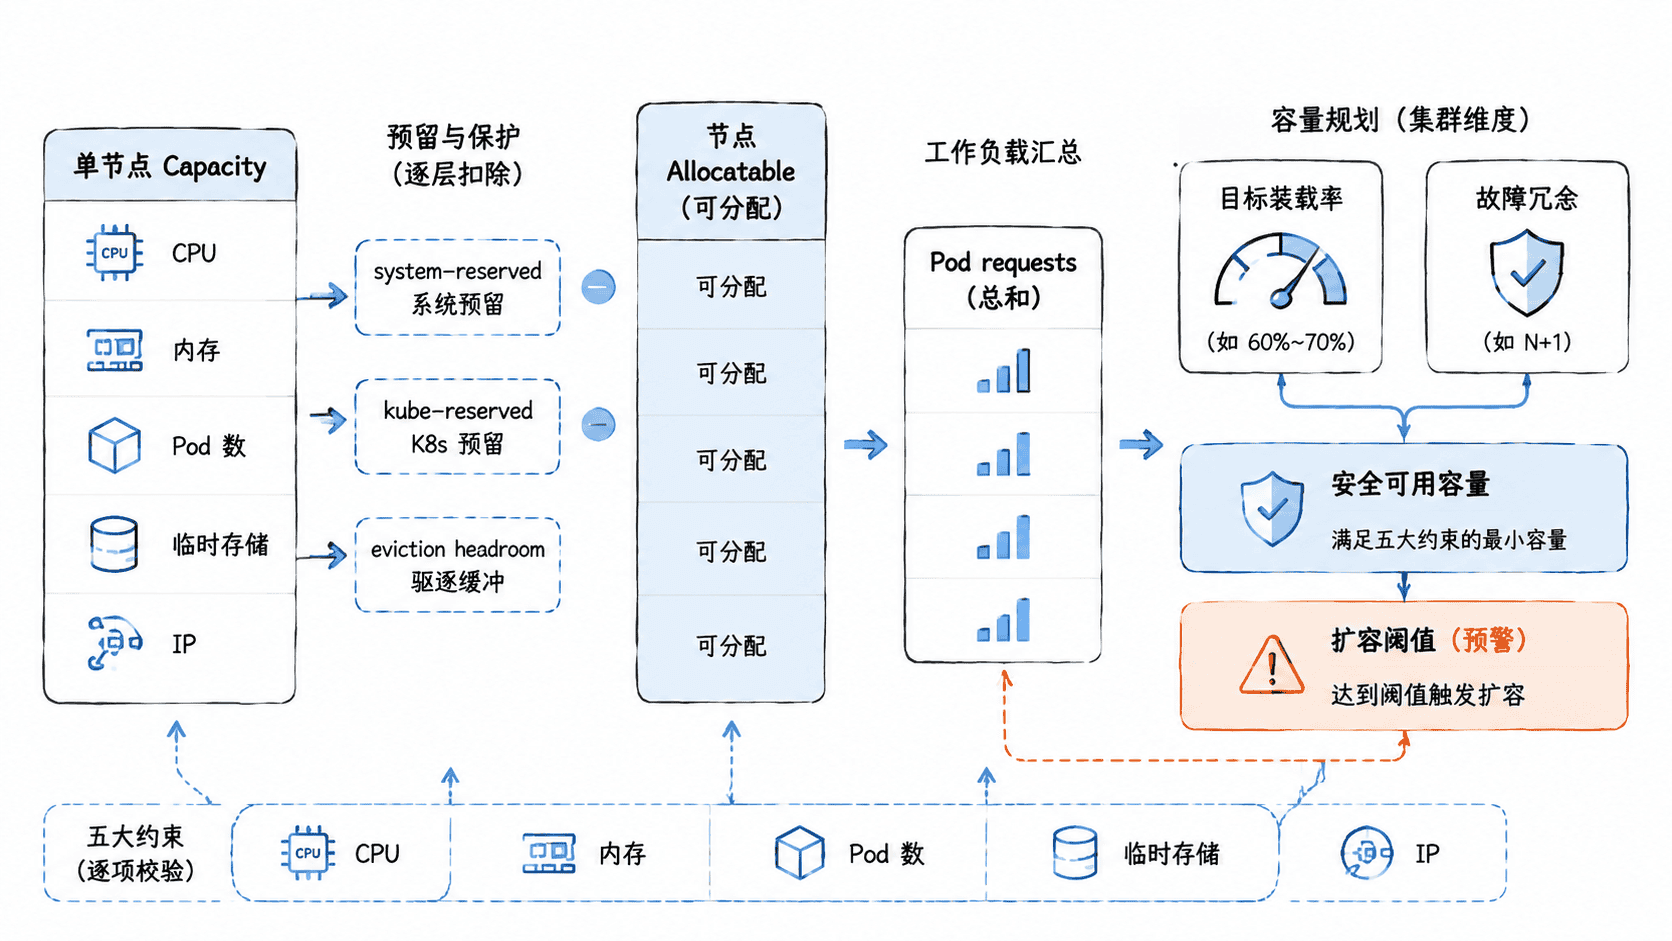
集群容量规划的目标不是把节点“用满”,而是用可量化的资源请求、可分配容量、系统预留和故障冗余,推导出当前安全容量与扩容触发点。完成本节后,你可以用一套固定口径判断节点是否够用,并避免只看瞬时 CPU 使用率做决策。
学习目标
- 区分节点 Capacity、Allocatable、Pod requests 与实际使用率的作用
- 根据资源请求、目标装载率和故障冗余估算节点数量
- 为节点扩容建立可持续观测的触发条件
先建立容量口径
Kubernetes 调度器主要依据 Pod 的 requests 判断节点是否能接纳工作负载,因此容量规划首先看“已承诺资源”,再看真实使用率是否存在偏差。节点的 status.capacity 是物理或虚拟机总资源,status.allocatable 则是扣除系统与 Kubernetes 预留后可供 Pod 使用的资源。
生产规划至少同时检查 CPU、内存、可调度 Pod 数、临时存储和网络地址。任何一个维度先达到上限,都可能成为扩容原因。CPU 可以短时超卖,但内存、Pod 数、IP 地址和磁盘空间通常更接近硬约束。
采集当前资源基线
先获取节点的 Capacity、Allocatable 和实时使用率。kubectl top nodes 依赖 Metrics Server;如果集群未安装 Metrics Server,这条命令会失败,但 kubectl get nodes 仍可用于读取节点容量。
kubectl get nodes -o custom-columns=NAME:.metadata.name,CPU:.status.capacity.cpu,CPU_ALLOC:.status.allocatable.cpu,MEM_ALLOC:.status.allocatable.memory,PODS_ALLOC:.status.allocatable.pods
kubectl top nodes
预期输出
NAME       CPU   CPU_ALLOC   MEM_ALLOC      PODS_ALLOC
<NAME>     <VALUE> <VALUE>   <VALUE>        <VALUE>
NAME       CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
<NAME>     <VALUE>      <VALUE>% <VALUE>        <VALUE>%
实际数值会随节点规格和负载变化。容量规划时不要把 kubectl top 的瞬时利用率直接当成可调度余量,因为调度器并不会用它替代 Pod requests。
还要抽查节点已经承诺的 requests。下面命令选择第一个节点,并显示 Allocated resources 区域:
NODE=$(kubectl get nodes -o jsonpath='{.items[0].metadata.name}')
kubectl describe node "$NODE"
预期输出
Allocated resources:
  Resource           Requests       Limits
  cpu                <VALUE>        <VALUE>
  memory             <VALUE>        <VALUE>
  ephemeral-storage  <VALUE>        <VALUE>
不同 Kubernetes 版本和节点状态下表格细节可能略有差异,但关键是比较 requests 与 Allocatable,而不是只看 limits。
计算目标节点数量
如果单节点有 8 vCPU、32 GiB 内存,扣除系统和 Kubernetes 预留后实际可供 Pod 使用 7 vCPU、28 GiB。为了给突发流量和调度碎片留空间,假设目标 requests 装载率为 70%,业务总 requests 为 28 vCPU、90 GiB,则分别计算 CPU 与内存需要的节点数:
基础节点数取两者较大值,即 6 台。若要求任意 1 台节点故障时仍能容纳工作负载,再增加 1 台冗余,目标规模就是 7 台。多可用区集群还应检查每个可用区独立失效后的剩余容量,不能只做全局总量计算。
定义扩容时机
扩容不应只依赖单一 CPU 百分比。更稳妥的做法是同时设置“资源承诺”和“真实压力”两类信号,并要求持续一段时间再触发,避免短暂抖动造成频繁扩缩。
建议把节点池 requests 装载率持续超过 65%~75% 作为提前量,把不可调度 Pod、内存压力、磁盘压力、Pod IP 接近耗尽作为更高优先级信号。若业务发布有明显日峰值,还要把新增节点启动时间计入提前量,使扩容动作早于预计峰值发生。
对于自动扩容集群,还要验证最大节点数是否足以覆盖“当前安全规模 + 计划增长 + 故障冗余”。自动扩容器只能在上限允许的范围内加节点,错误的上限本身就是容量风险。
用门槛而不是感觉做决策
一次完整的容量评审至少回答三个问题:当前 requests 在失去一个故障域或关键节点后能否重新调度;未来一个发布周期的增长是否仍在安全装载率内;出现不可调度 Pod 时,节点池是否能在业务容忍时间内完成扩容。
容量规划的最终产物不是一个静态“节点数”,而是一组可复算的假设、资源口径和扩容门槛。只要工作负载 requests、节点规格或故障冗余目标变化,就应重新计算,而不是沿用历史规模。