
容器与云原生 / 系统课时
安装 CNI 网络插件
安装 CNI 网络插件
kubeadm 只负责把控制面和节点引导起来,不会替你建立 Pod 网络。本课以 Flannel 为可运行示例,先核对集群 Pod CIDR,再安装 CNI,并用节点状态、CoreDNS 和跨节点 Pod 连通性确认网络真正可用。
学习目标
- 找出 kubeadm 集群实际使用的 Pod CIDR,并判断它是否与 CNI 配置匹配
- 安装 Flannel 并验证 CNI DaemonSet、节点与 CoreDNS 状态
- 在两个节点之间创建测试 Pod,验证跨节点 Pod IP 连通性
先确认 Pod 网段
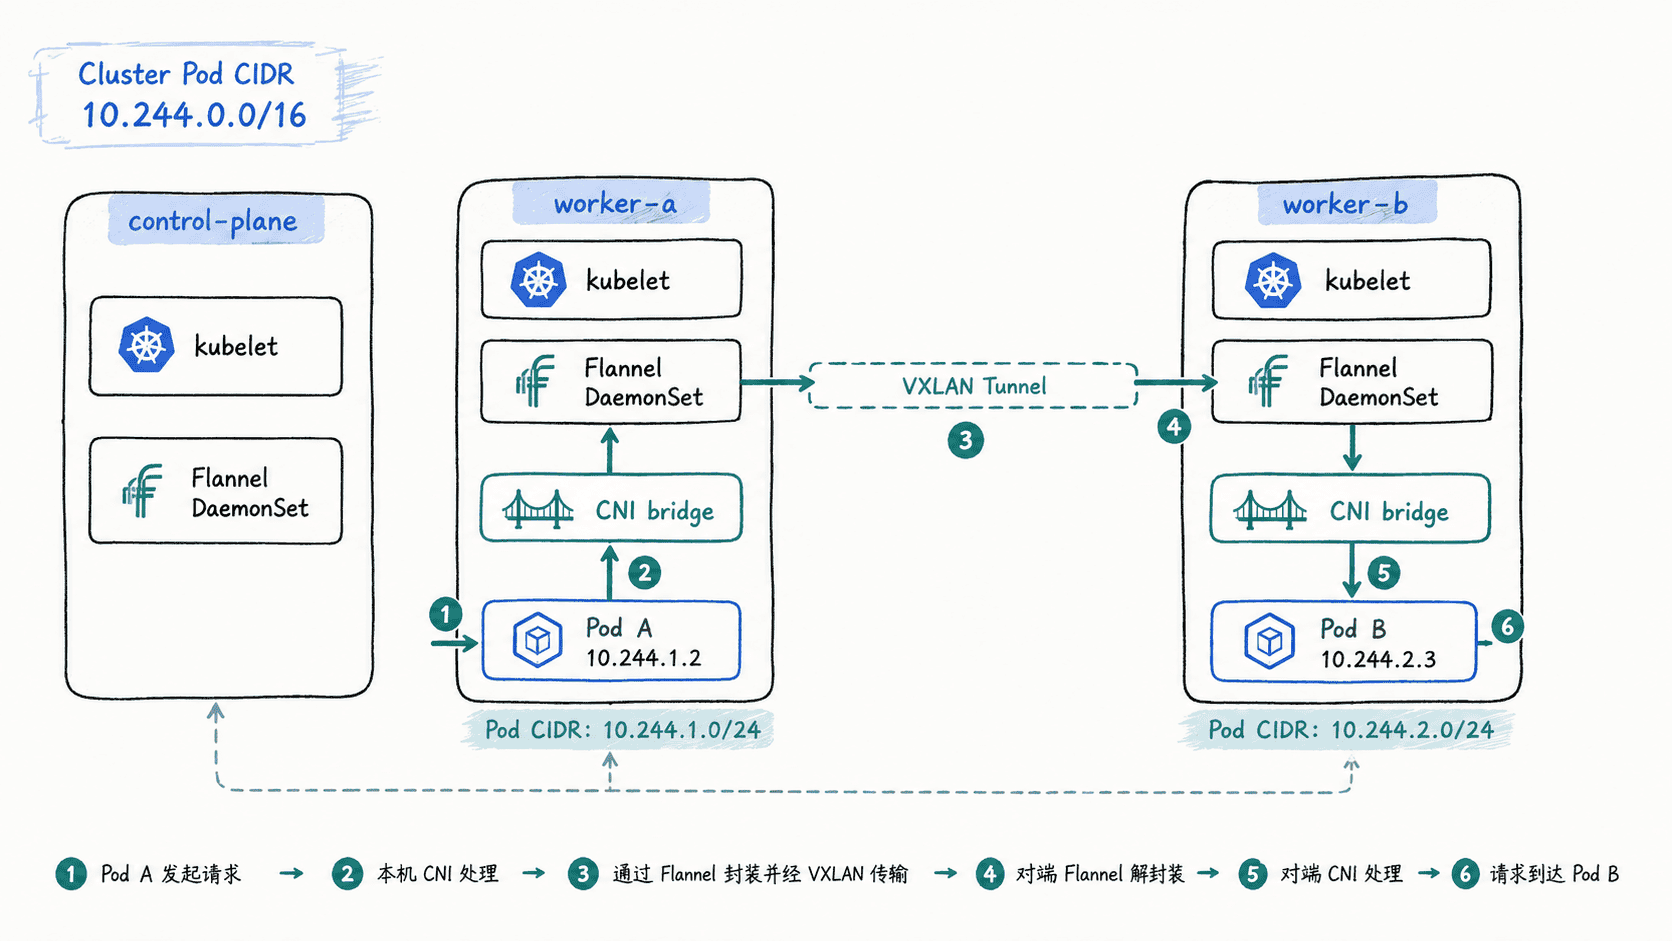
CNI 的首要约束不是“能安装”,而是它管理的 Pod 地址范围必须与集群规划一致,并且不能与宿主机、机房或云网络发生重叠。下面示例使用 Flannel 默认的 10.244.0.0/16;如果初始化集群时设置了其他 --pod-network-cidr,不要直接套用默认清单。
在控制平面节点读取 kubeadm 保存的集群配置:
# 从 kubeadm-config 中提取初始化时记录的 Pod 网段
POD_CIDR=$(kubectl -n kube-system get configmap kubeadm-config \
  -o jsonpath='{.data.ClusterConfiguration}' \
  | awk '/podSubnet:/{print $2}')

echo "Pod CIDR: ${POD_CIDR}"
预期输出
Pod CIDR: 10.244.0.0/16如果这里为空,说明初始化时没有形成可供该方案使用的 podSubnet 配置;如果值不是 10.244.0.0/16,应改用与实际网段匹配的 CNI 配置,而不是继续应用 Flannel 默认清单。
安装并等待 Flannel 就绪
确认 Pod CIDR 正确后,在有管理员 kubeconfig 的节点执行官方发布清单。Flannel 会以 DaemonSet 形式在节点上运行,并写入 kubelet 使用的 CNI 配置。
# 再次读取网段,避免依赖前一个终端会话中的变量
POD_CIDR=$(kubectl -n kube-system get configmap kubeadm-config \
  -o jsonpath='{.data.ClusterConfiguration}' \
  | awk '/podSubnet:/{print $2}')

test "${POD_CIDR}" = "10.244.0.0/16"
kubectl apply -f https://github.com/flannel-io/flannel/releases/latest/download/kube-flannel.yml

# 等待节点级网络组件完成滚动部署后再检查 DNS 与 Node
kubectl rollout status daemonset/kube-flannel-ds -n kube-flannel --timeout=180s
kubectl get nodes
kubectl get pods -n kube-system -l k8s-app=kube-dns
预期结果
daemon set "kube-flannel-ds" successfully rolled out

NAME              STATUS   ROLES           AGE    VERSION
<CONTROL_PLANE>   Ready    control-plane   <TIME> <VALUE>

NAME                       READY   STATUS    RESTARTS   AGE
coredns-<ID>               1/1     Running   0          <TIME>
coredns-<ID> 1/1 Running 0 <TIME>AGE、版本号和 Pod ID 会随环境不同而变化。关键门槛是 Flannel DaemonSet 完成 rollout、节点从 NotReady 变为 Ready,并且 CoreDNS Pod 进入 Running。
验证跨节点 Pod 网络
真正的 CNI 验收不是“网络插件 Pod 在运行”,而是两个不同节点上的 Pod 能使用 Pod IP 直接通信。此测试需要至少两个 Ready 节点;如果当前只有控制平面节点,应在工作节点加入后再执行。
先从 kubectl get nodes 取得两个节点名,替换 <NODE_A> 与 <NODE_B>:
NODE_A="<NODE_A>"
NODE_B="<NODE_B>"

# 把两个长生命周期测试 Pod 固定到不同节点
kubectl run net-a --image=busybox:1.36.1 --restart=Never \
  --overrides="{\"spec\":{\"nodeName\":\"${NODE_A}\"}}" \
  --command -- sleep 3600
kubectl run net-b --image=busybox:1.36.1 --restart=Never \
  --overrides="{\"spec\":{\"nodeName\":\"${NODE_B}\"}}" \
  --command -- sleep 3600

# 从 net-a 直接访问另一节点上的 Pod IP
kubectl wait --for=condition=Ready pod/net-a pod/net-b --timeout=120s
POD_B_IP=$(kubectl get pod net-b -o jsonpath='{.status.podIP}')
kubectl exec net-a -- ping -c 3 "${POD_B_IP}"
预期输出
pod/net-a created
pod/net-b created
pod/net-a condition met
pod/net-b condition met
3 packets transmitted, 3 packets received, 0% packet loss
若 Pod 一直停在 ContainerCreating,先查看对应节点上的 CNI Pod 日志和 /etc/cni/net.d/;若同节点能通而跨节点不通,则重点检查节点间路由、防火墙以及所选 CNI 后端需要的封装流量是否被拦截。验证通过后可执行 kubectl delete pod net-a net-b 清理测试 Pod。