
容器与云原生 / 系统课时
排查集群网络故障
排查集群网络故障
集群网络故障最容易被“连接超时”这一类表象误导。有效的排查方法不是反复重启 Pod,而是沿着 Pod 地址、节点路由、Service 端点、DNS 和 NetworkPolicy 逐层缩小范围,最终判断故障发生在应用、CNI、服务发现还是访问控制。
学习目标
- 按固定顺序验证 Pod 到 Pod、Pod 到 Service 的通信链路
- 能用 EndpointSlice、DNS 查询和 NetworkPolicy 证据定位故障层级
- 根据不同失败现象选择下一条最有价值的检查命令
先把故障拆成一条链路
一次典型的集群内访问可以抽象为:客户端 Pod 先得到目标名称对应的 Service 地址,Service 再把流量转发到后端 Pod。底层还依赖 Pod 地址可达、节点间路由或隧道正常,以及网络策略没有拒绝这次通信。
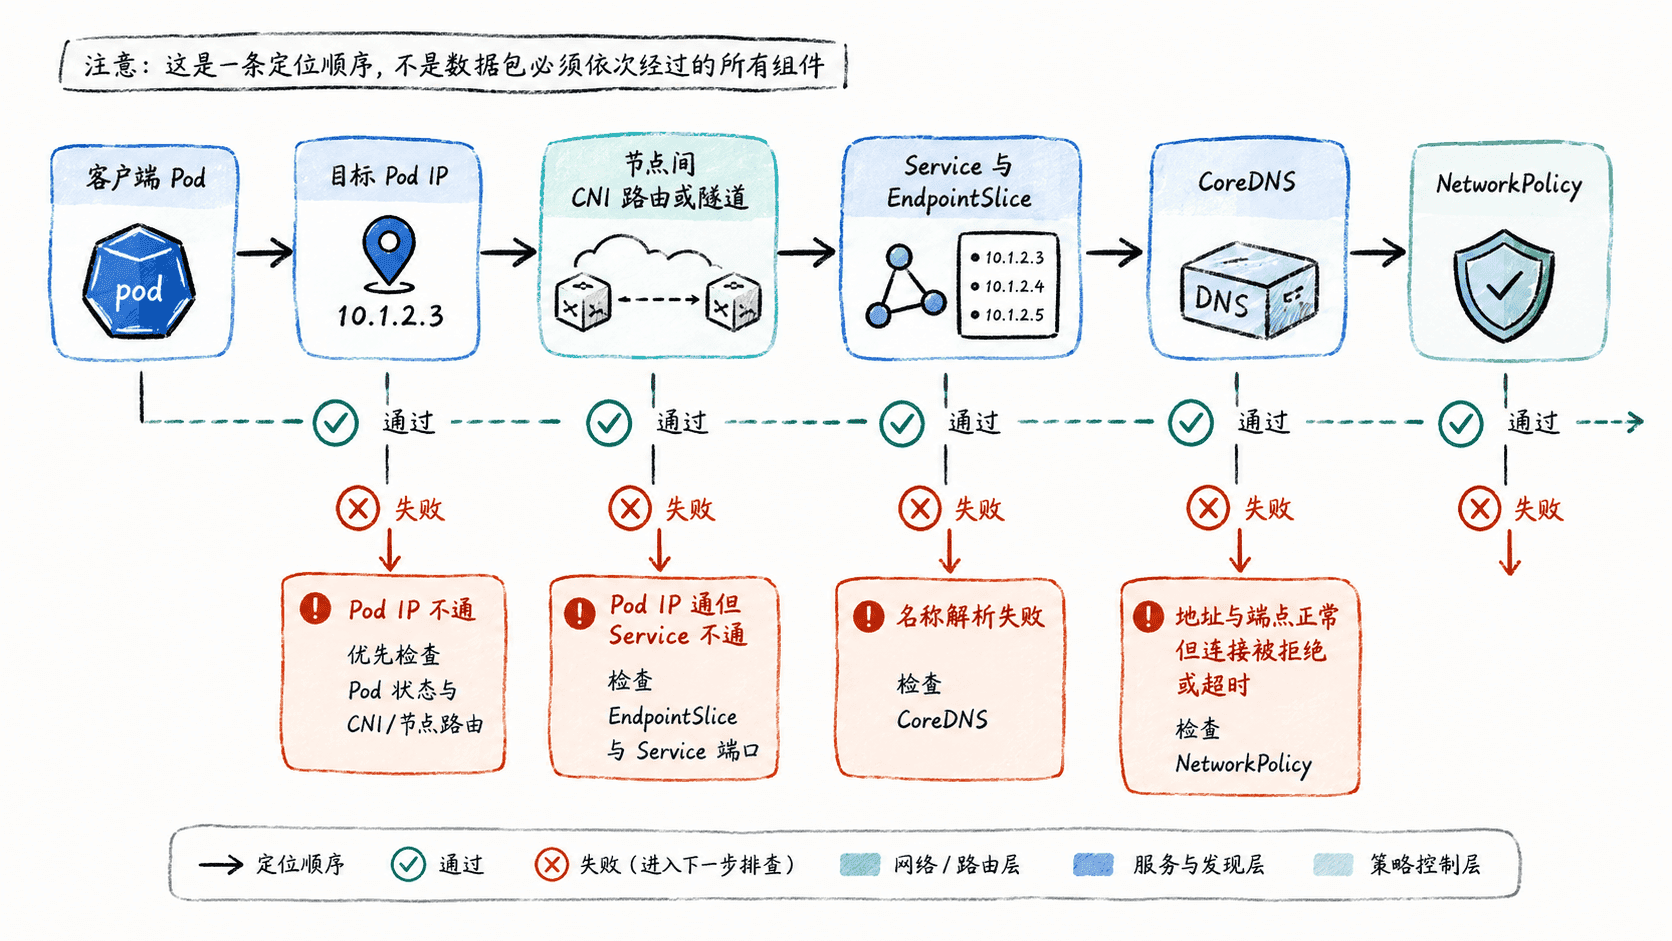
排查时先确认“目标到底是什么”。下面假设命名空间为 demo,客户端 Pod 为 client,目标 Service 为 api。如果你的对象名称不同,只替换对应标识符,不要改变检查顺序。
先验证 Pod 地址与直连能力
先看后端 Pod 是否 Ready、分配到了 Pod IP,以及它落在哪个节点。随后从客户端 Pod 直接访问后端 Pod IP。若连 Pod IP 都不通,继续检查 Service 或 DNS 没有意义。
kubectl get pod -n demo -o wide
kubectl exec -n demo client -- wget -qO- --timeout=3 http://<IP>:<PORT>/health
预期结果
NAME      READY   STATUS    IP            NODE
client    1/1     Running   <IP>          <NODE>
api-...   1/1     Running   <IP>          <NODE>

ok<IP>、<PORT> 和 <NODE> 的实际值会因集群而不同。若目标 Pod 不是 Running/Ready,先处理应用启动、探针或容器故障;若 Pod 正常但跨节点直连超时,则重点转向 CNI、节点路由、隧道封装、主机防火墙或云网络规则。
再检查 Service 与 EndpointSlice
Pod IP 可达而 Service 不通时,最重要的证据是 EndpointSlice。Service 的 selector 必须选中后端 Pod,且 EndpointSlice 中应出现正确的 Pod 地址和端口。
kubectl get svc api -n demo -o wide
kubectl get endpointslice -n demo -l kubernetes.io/service-name=api -o wide
预期结果
NAME   TYPE        CLUSTER-IP   PORT(S)
api    ClusterIP   <IP>         <PORT>/TCP

NAME        ADDRESSTYPE   PORTS     ENDPOINTS
api-...     IPv4          <PORT>    <IP>,<IP>
若 EndpointSlice 没有地址,优先比较 Service 的 spec.selector 与 Pod 标签;若地址存在但端口不对,检查 port、targetPort 以及容器实际监听端口。若端点正确、Pod IP 也能直连,但 ClusterIP 仍失败,再检查节点上的 Service 转发实现与数据面组件。
分开验证 DNS 和访问控制
名称访问失败时,不要直接把“DNS 不通”和“服务不通”混在一起。先查询完整服务域名,再用解析出的 ClusterIP 做一次直接访问;这样能判断故障是在解析阶段还是转发阶段。
kubectl exec -n demo client -- nslookup api.demo.svc.cluster.local
kubectl exec -n demo client -- wget -qO- --timeout=3 http://api.demo.svc.cluster.local:<PORT>/health
kubectl get networkpolicy -n demo
预期结果
Name:      api.demo.svc.cluster.local
Address:   <IP>

ok

NAME                 POD-SELECTOR   AGE
<NETWORK_POLICY>     <SELECTOR>     <TIME>
DNS 查询失败时,检查客户端 Pod 的 /etc/resolv.conf、CoreDNS Pod 状态与 Service;DNS 正常而 HTTP 超时,则继续看端点、路由和 NetworkPolicy。<NETWORK_POLICY>、<SELECTOR> 与 <TIME> 可能不存在或与示例不同;没有 NetworkPolicy 时,最后一条命令可能只显示表头。
用现象决定下一步
“connection refused”通常表示地址已经可达,但目标端口没有进程监听或端口映射错误;“timeout”更常见于路由丢包、策略拒绝、主机防火墙或数据面异常;“no such host”则优先落在 DNS。把错误类型与上面的链路证据结合,能避免无目的地查看所有组件。
真正高效的网络排障不是记住更多命令,而是每次只回答一个问题:目标 Pod 是否存在并可达、Service 是否有正确端点、名称是否能解析、策略是否允许通信。只要按这个顺序保留证据,大多数集群内通信故障都能快速定位到具体层级。