
容器与云原生 / 系统课时
配置弹性与可用性
配置弹性与可用性
本课把关键服务的自动伸缩、跨拓扑分布和中断预算组合起来,让副本既能随负载变化扩缩,也能避免集中到同一故障域,并在节点维护或驱逐时保住必要的可用容量。
学习目标
- 为现有 Deployment 配置基于 CPU 的 HPA,并设置合理的伸缩边界
- 使用拓扑分布约束降低单一可用区故障对服务的影响
- 用 PodDisruptionBudget 限制自愿中断时可同时损失的副本数
确认伸缩与分布前提
下面假设关键服务为 shop 命名空间中的 checkout Deployment,容器名也为 checkout。HPA 的 CPU 利用率基于 resources.requests.cpu 计算,因此必须存在 CPU request;拓扑分布还依赖节点具有 topology.kubernetes.io/zone 标签,并且集群中确实存在多个可调度故障域。
kubectl get deployment checkout -n shop
kubectl get nodes -L topology.kubernetes.io/zone
kubectl top pods -n shop -l app=checkout
预期结果
NAME       READY             UP-TO-DATE   AVAILABLE   AGE
checkout   <VALUE>/<VALUE>   <VALUE>      <VALUE>     <VALUE>

NAME     STATUS   ROLES    AGE       VERSION   ZONE
<NODE>   Ready    <ROLE>   <VALUE>   <VALUE>   <ZONE>

NAME    CPU(cores)   MEMORY(bytes)
<POD>   <VALUE>m     <VALUE>Mi
若 kubectl top 无法返回指标,应先修复 Metrics API;若节点没有 zone 标签,应先补齐反映真实基础设施的拓扑标签,而不是为了通过调度检查随意伪造故障域。
组合三道可用性防线
HPA 解决“需要多少副本”,拓扑分布约束解决“副本放在哪里”,PDB 解决“维护期间一次最多主动中断多少副本”。三者分别控制容量、故障域和中断节奏,缺少任一层都可能在高负载或节点维护时形成可用性缺口。
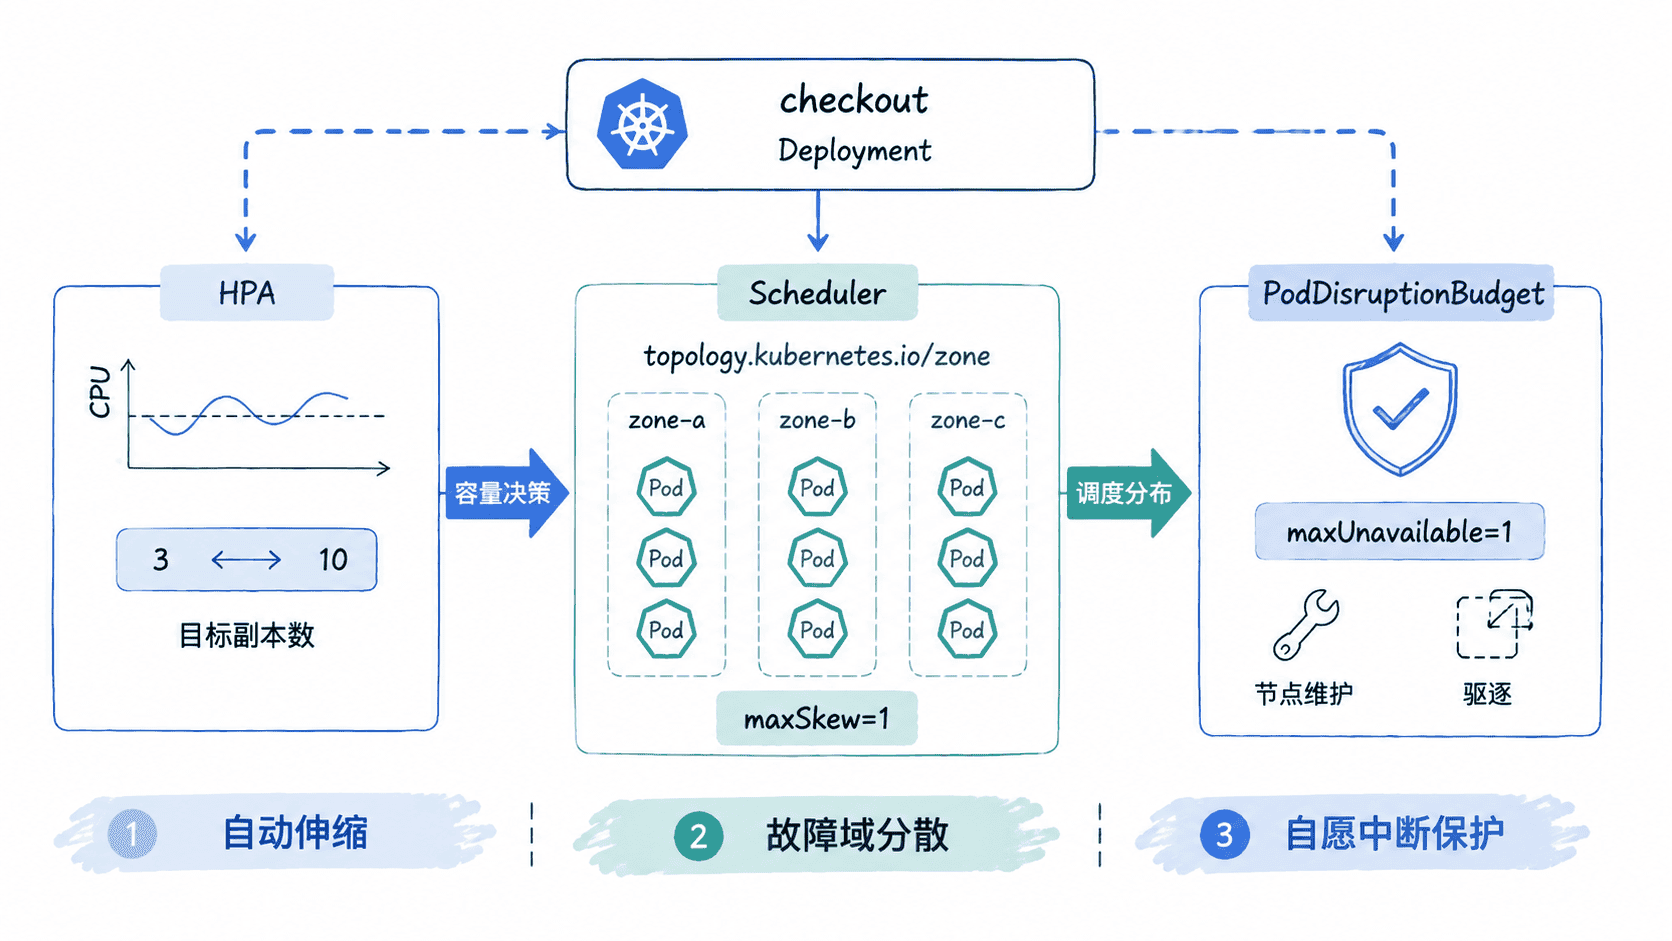
先用战略合并补丁为现有 Deployment 增加资源请求与拓扑分布。labelSelector 必须与 Pod 模板上的 app=checkout 标签一致,否则调度器不会把这些 Pod 计入同一分布组。
# availability-patch.yaml
spec:
  template:
    spec:
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: topology.kubernetes.io/zone
          whenUnsatisfiable: DoNotSchedule
          labelSelector:
            matchLabels:
              app: checkout
      containers:
        - name: checkout
          resources:
            requests:
              cpu: 200m
              memory: 256Mi
            limits:
              cpu: 1000m
              memory: 512Mi
再创建 HPA 与 PDB。这里把最小副本设为 3,为跨故障域分布保留基本容量;maxUnavailable: 1 表示通过 Eviction API 执行自愿中断时,同时最多允许少一个可用副本。
# availability-policy.yaml
apiVersion: v1
kind: List
items:
  - apiVersion: autoscaling/v2
    kind: HorizontalPodAutoscaler
    metadata:
      name: checkout
      namespace: shop
    spec:
      scaleTargetRef:
        apiVersion: apps/v1
        kind: Deployment
        name: checkout
      minReplicas: 3
      maxReplicas: 10
      behavior:
        scaleDown:
          stabilizationWindowSeconds: 300
      metrics:
        - type: Resource
          resource:
            name: cpu
            target:
              type: Utilization
              averageUtilization: 60
  - apiVersion: policy/v1
    kind: PodDisruptionBudget
    metadata:
      name: checkout
      namespace: shop
    spec:
      maxUnavailable: 1
      selector:
        matchLabels:
          app: checkout
该配置让调度器控制副本在可用区之间的偏斜,让 HPA 依据 CPU request 计算目标副本数,并让主动驱逐遵守中断预算。PDB 不会阻止节点宕机、进程崩溃等非自愿中断。
应用并验证
kubectl patch deployment checkout -n shop --type strategic --patch-file availability-patch.yaml
kubectl apply -f availability-policy.yaml
kubectl rollout status deployment/checkout -n shop
预期输出
deployment.apps/checkout patched
horizontalpodautoscaler.autoscaling/checkout created
poddisruptionbudget.policy/checkout created
deployment "checkout" successfully rolled out资源此前已经存在时,created 可能显示为 configured,属于正常结果。继续检查三个控制面的实际状态。
kubectl get hpa checkout -n shop
kubectl get pdb checkout -n shop
kubectl get pods -n shop -l app=checkout -o wide
预期结果
NAME       REFERENCE             TARGETS        MINPODS   MAXPODS   REPLICAS   AGE
checkout   Deployment/checkout   <VALUE>%/60%   3         10        <VALUE>    <VALUE>

NAME       MIN AVAILABLE   MAX UNAVAILABLE   ALLOWED DISRUPTIONS   AGE
checkout   N/A             1                 <VALUE>               <VALUE>

NAME    READY   STATUS    RESTARTS   AGE       IP     NODE
<POD>   1/1     Running   <VALUE>    <VALUE>   <IP>   <NODE>
HPA 需要经过指标采样后才会稳定,实际 TARGETS、REPLICAS 和 ALLOWED DISRUPTIONS 会随负载变化。Pod 是否真正跨 zone 分布,应结合每个 Pod 所在 NODE 与节点 zone 标签一起判断。
处理约束之间的冲突
当可调度故障域不足时,DoNotSchedule 可能让新 Pod 长时间处于 Pending;这不是 HPA 失效,而是调度器无法满足拓扑约束。生产环境应先补足对应故障域的容量,再评估是否需要改用 ScheduleAnyway,不要为了消除 Pending 直接删除分布保护。
PDB 也不是“副本永远不会减少”的保险。它主要约束使用 Eviction API 的自愿中断,Deployment 主动缩容仍会按新的目标副本数执行。因此 HPA 的 minReplicas、应用最低容量和 PDB 应围绕同一个可用性目标设计。