
容器与云原生 / 系统课时
发布演练与故障恢复
发布演练与故障恢复
本课把一次高风险上线拆成可重复、可观察、可回退的演练流程。你将依次验证滚动发布、扩缩容、节点维护、版本回退和故障自愈,并用统一的健康检查确认业务真正恢复,而不是只看到命令执行成功。
学习目标
- 为发布演练定义范围、基线、停止条件和回退点。
- 执行滚动发布、扩缩容、节点维护与版本回退。
- 用副本状态、服务端点和健康接口验证恢复结果。
先建立演练边界与验收基线
优先在预发布环境执行;必须在生产演练时,应提前冻结无关变更并确认维护窗口。演练对象至少包括一个 Deployment、对应 Service、健康检查接口和可用的旧镜像版本。任何阶段出现可用副本低于业务底线、错误率持续升高或回退命令失效,都应立即停止后续步骤。
| 阶段 | 主要动作 | 通过信号 | 失败时动作 |
|---|---|---|---|
| 发布 | 更新镜像并观察滚动过程 | 新版本副本全部 Available | 暂停或回退 |
| 扩缩容 | 调整副本数 | 目标副本全部 Ready | 恢复原副本数 |
| 节点维护 | cordon、drain、uncordon | 工作负载在其他节点重建 | 中止驱逐并恢复节点 |
| 故障恢复 | 删除单个 Pod 或回退版本 | Service 端点与健康接口恢复 | 查看事件、日志和探针 |
执行滚动发布与扩缩容
下面以命名空间 drill、Deployment shop-api 为例。执行前把镜像地址替换为已通过测试且可拉取的版本,并记录当前修订历史,确保后续可以准确回退。
set -euo pipefail

NAMESPACE="drill"
APP="shop-api"
NEW_IMAGE="registry.example.com/shop-api:v2"

# 先保存修订历史,再发布已通过测试的新镜像。
kubectl -n "$NAMESPACE" rollout history deployment/"$APP" \
  > "rollout-history-${APP}.txt"
kubectl -n "$NAMESPACE" set image deployment/"$APP" \
  "$APP"="$NEW_IMAGE"
kubectl -n "$NAMESPACE" rollout status deployment/"$APP" --timeout=180s

# 扩容后等待控制器完成收敛,避免把“已提交”误当成“已就绪”。
kubectl -n "$NAMESPACE" scale deployment/"$APP" --replicas=3
kubectl -n "$NAMESPACE" rollout status deployment/"$APP" --timeout=180s
kubectl -n "$NAMESPACE" get deployment "$APP" \
  -o jsonpath='{.status.availableReplicas}/{.spec.replicas}{"\n"}'
预期输出
deployment.apps/shop-api image updated
deployment "shop-api" successfully rolled out
deployment.apps/shop-api scaled
deployment "shop-api" successfully rolled out
3/3
实际副本数会随目标值变化。若 rollout status 超时,不要继续节点维护,应先用 kubectl describe pod 和 kubectl logs 检查镜像拉取、探针、资源不足或启动异常。
演练维护、回退与故障恢复
节点维护与版本回退
节点维护会同时触发调度、驱逐预算和控制器重建,适合用流程图理解各环节的依赖关系。生产环境执行 drain 前必须确认 PodDisruptionBudget、本地临时数据和不可驱逐工作负载;除非明确评估过风险,不要加入 --force。
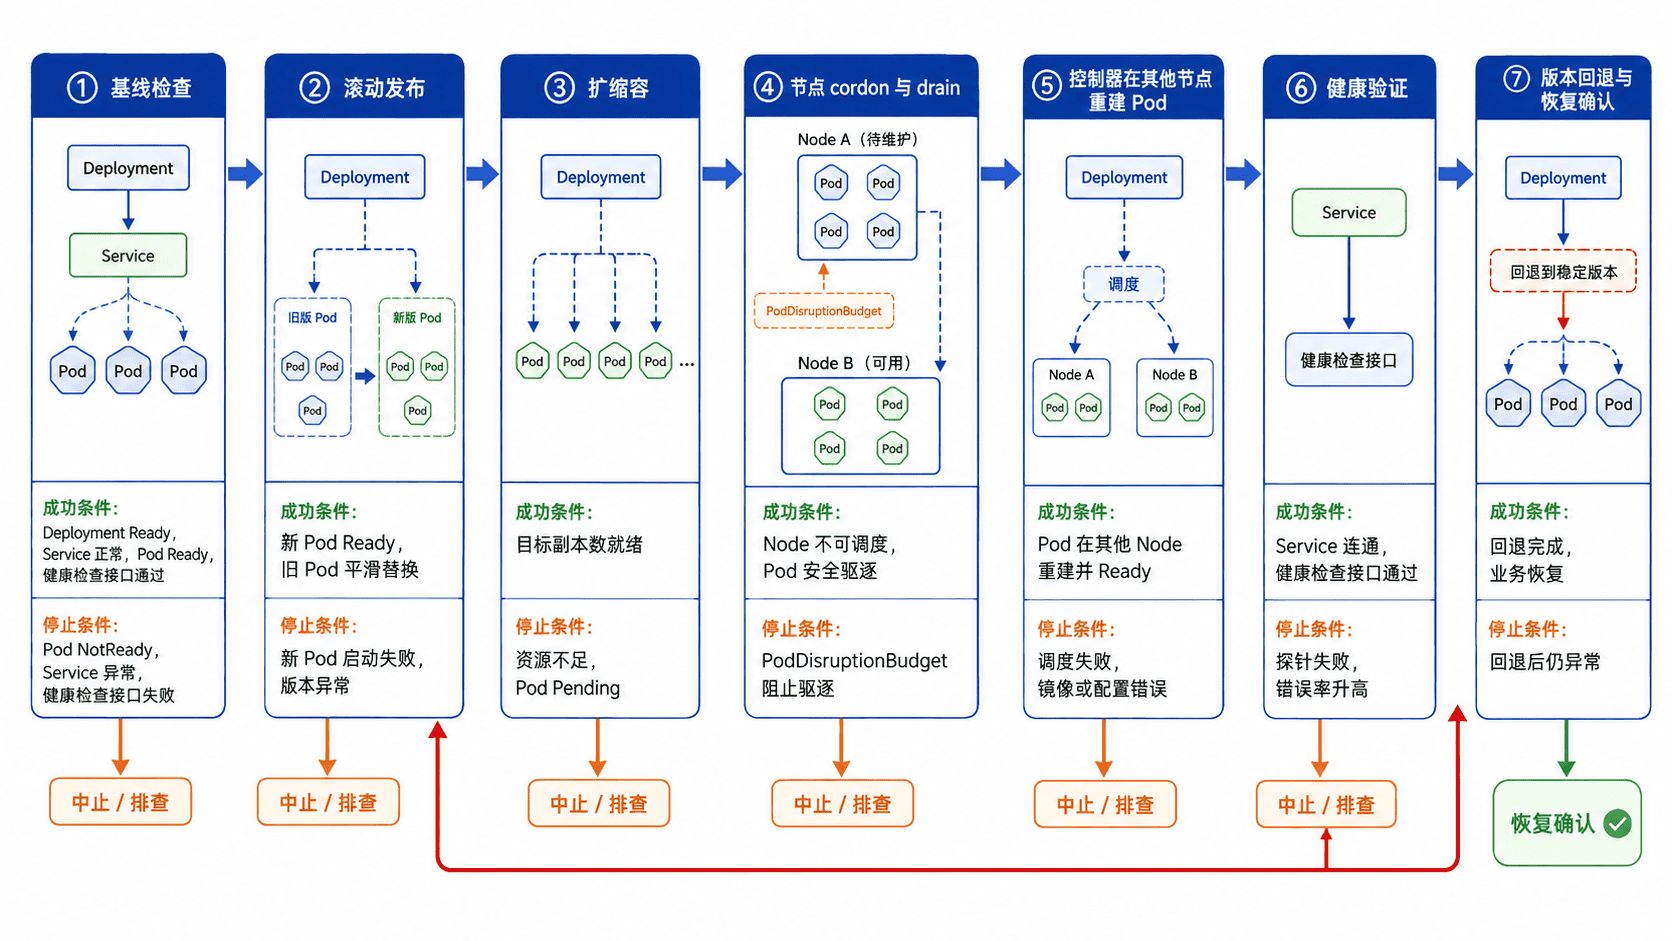
set -euo pipefail

NAMESPACE="drill"
APP="shop-api"
NODE="<NODE>"

# cordon 先阻止新 Pod 调度,drain 再通过驱逐迁移现有工作负载。
kubectl cordon "$NODE"
kubectl drain "$NODE" \
  --ignore-daemonsets \
  --delete-emptydir-data \
  --timeout=10m

kubectl -n "$NAMESPACE" rollout status deployment/"$APP" --timeout=180s
kubectl uncordon "$NODE"

# 回退会创建新的修订,而不是删除发布历史。
kubectl -n "$NAMESPACE" rollout undo deployment/"$APP"
kubectl -n "$NAMESPACE" rollout status deployment/"$APP" --timeout=180s
预期输出
node/<NODE> cordoned
<EVICTION_OUTPUT>
node/<NODE> drained
deployment "shop-api" successfully rolled out
node/<NODE> uncordoned
deployment.apps/shop-api rolled back
deployment "shop-api" successfully rolled out
<NODE> 替换为允许维护的真实节点名,<EVICTION_OUTPUT> 表示各 Pod 的驱逐记录。若 drain 被 PDB 阻止,这是保护机制生效,不应通过强制参数绕过;应先确认剩余副本是否满足可用性要求,再调整维护顺序或临时扩容。
验证故障恢复闭环
最后删除一个普通业务 Pod,观察控制器重建并验证 Service 仍有端点。该操作只适合无状态副本;数据库、消息队列等有状态组件应使用其专用故障演练方案。
set -euo pipefail

NAMESPACE="drill"
APP="shop-api"
SERVICE="shop-api"

# 只删除一个普通副本,避免把受控演练扩大成整体中断。
POD=$(kubectl -n "$NAMESPACE" get pod \
  -l "app=$APP" \
  --field-selector=status.phase=Running \
  -o jsonpath='{.items[0].metadata.name}')
kubectl -n "$NAMESPACE" delete pod "$POD" --wait=false

# 控制器补齐副本后,再从集群内验证 Service 与业务健康接口。
kubectl -n "$NAMESPACE" rollout status deployment/"$APP" --timeout=180s
ENDPOINTS=$(kubectl -n "$NAMESPACE" get endpointslice \
  -l "kubernetes.io/service-name=$SERVICE" \
  -o jsonpath='{range .items[*].endpoints[*]}{range .addresses[*]}{.}{"\n"}{end}{end}' | \
  sed '/^$/d' | wc -l | tr -d ' ')
if [[ "$ENDPOINTS" == "0" ]]; then
  echo "service endpoints: 0"
  exit 1
fi
echo "service endpoints: $ENDPOINTS"

kubectl -n "$NAMESPACE" run smoke-check \
  --image=curlimages/curl:8.10.1 \
  --restart=Never --rm -i --quiet \
  -- -fsS "http://$SERVICE/healthz"
预期输出
pod "<POD>" deleted
deployment "shop-api" successfully rolled out
service endpoints: <COUNT>
ok
Pod 名称和端点数量是动态值。若副本恢复但健康接口失败,应继续检查 Service 选择器、EndpointSlice、容器探针、依赖服务和应用日志,直到业务链路恢复后才算演练通过。