
容器与云原生 / 系统课时
节点与调度故障排查
节点与调度故障排查
本课从 Pending Pod 和 NotReady 节点出发,建立“事件定向、调度过滤、节点健康、kubelet 运行时、修复验证”的排查闭环,避免仅凭资源使用率或反复重启组件判断故障。
学习目标
- 从 Pod 事件中识别资源不足、污点、亲和性和拓扑约束问题。
- 区分 Scheduler 未能选中节点与 kubelet 未能启动容器。
- 使用节点状态、资源请求和系统日志验证修复结果。
从 Pending Pod 定位责任组件
Pod 处于 Pending 并不总是 Scheduler 故障。未设置 spec.nodeName 时,Scheduler 先过滤不满足资源、污点、亲和性、卷拓扑等条件的节点;选中节点后,kubelet 才负责拉取镜像、创建容器和挂载卷。责任边界应以 PodScheduled 条件和 Events 为准。
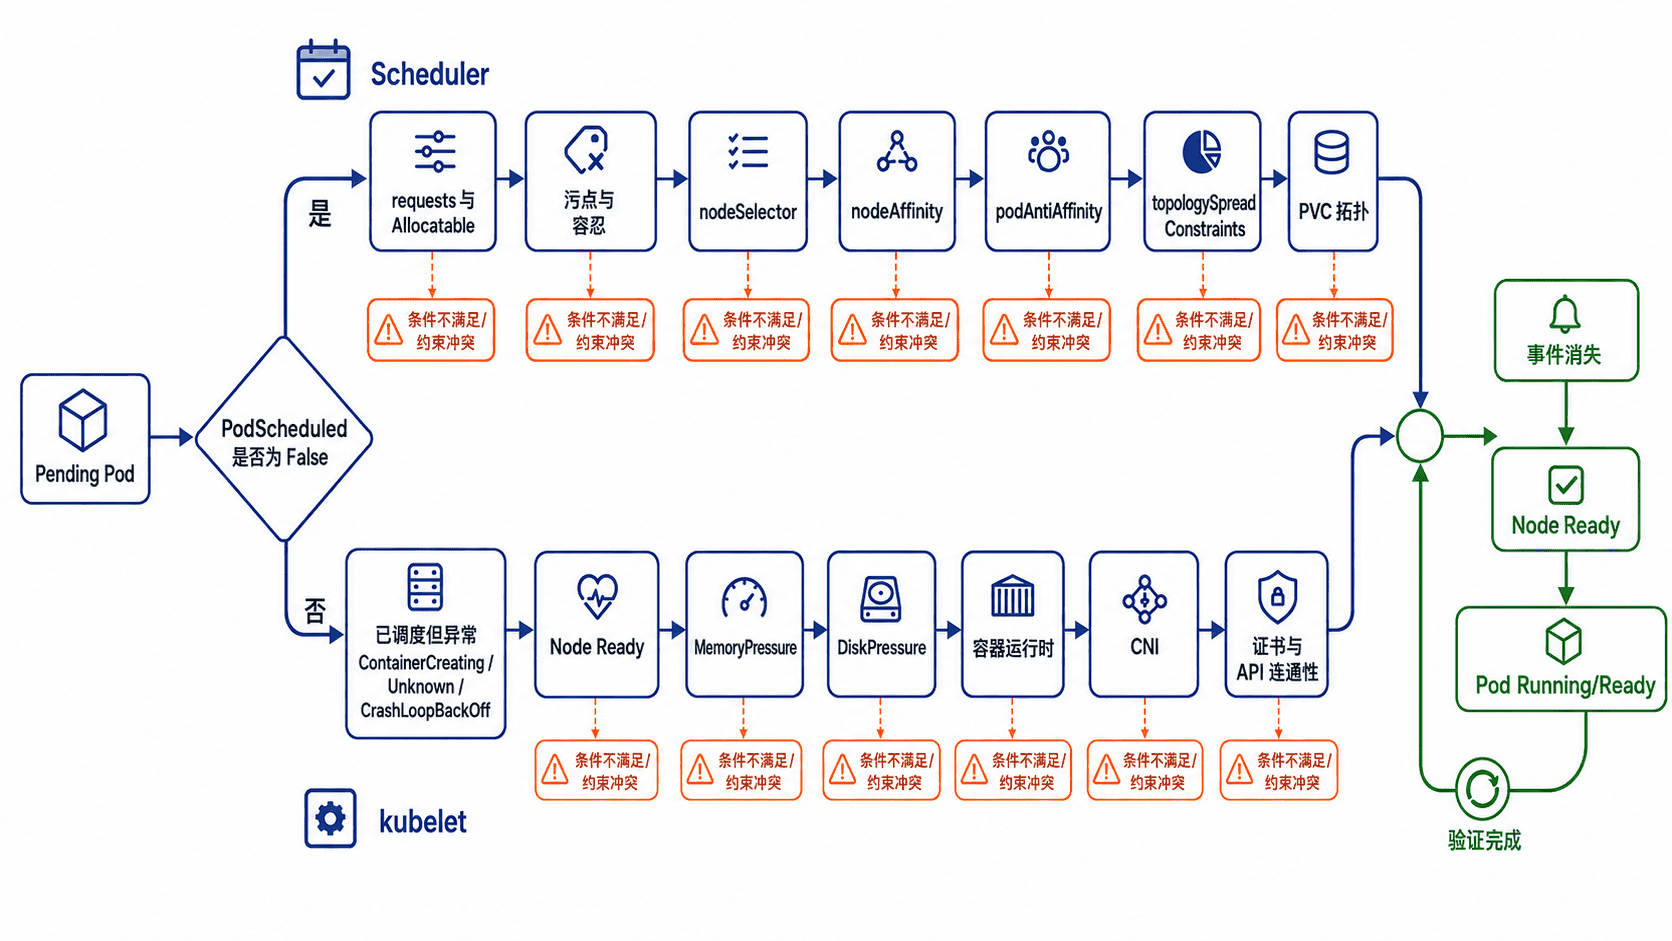
排查时先记录 Pod 名称、命名空间、目标节点和最近事件。事件中的原因字符串通常已经指出是哪一类过滤条件失败,比先查看所有组件日志更高效。
先读取 Pod 条件与事件
以下命令以 shop 命名空间中的待调度 Pod 为例。describe 末尾的 Events 是首要证据,PodScheduled=False 表示尚未完成调度;已有 Node 字段但容器未启动,则转向 kubelet、运行时、网络或存储。
POD_NAME=<POD_NAME>
kubectl -n shop get pod "$POD_NAME" -o wide
kubectl -n shop describe pod "$POD_NAME"
kubectl -n shop get pod "$POD_NAME"   -o jsonpath='{range .status.conditions[*]}{.type}={.status}{" reason="}{.reason}{"\n"}{end}'
预期输出
PodScheduled=False reason=Unschedulable
Events 中出现 FailedScheduling,并给出 0/<NODE_COUNT> nodes are available 及具体原因
实际节点数量和原因可能不同。常见信息包括 Insufficient cpu、Insufficient memory、未容忍污点、节点标签不匹配、Pod 反亲和性冲突,以及 PVC 节点亲和性冲突。不要把多条原因只处理其中一条,Scheduler 必须找到同时满足全部条件的节点。
检查 Node 状态与可调度资源
节点状态先看 Ready,再看 MemoryPressure、DiskPressure、PIDPressure 和 NetworkUnavailable。资源调度依据是 Pod 的 requests 与节点 Allocatable,而不是监控中瞬时 CPU、内存使用率;因此节点看起来很空,也可能因已承诺的 requests 无法再接收 Pod。
kubectl get nodes -o wide
kubectl describe node <NODE_NAME>
kubectl top node
kubectl top pod -A --sort-by=cpu
预期结果
目标节点 Ready=True,且没有持续的 MemoryPressure、DiskPressure 或 PIDPressure
Allocated resources 中的 requests 未超过节点 Allocatable
kubectl top 能返回节点与 Pod 的当前使用量
kubectl top 依赖 Metrics Server,无法返回指标时不能据此判定节点资源异常。应在 kubectl describe node 的 Capacity、Allocatable 和 Allocated resources 区域核对 requests,并检查系统保留资源、临时存储和最大 Pod 数限制。
节点被 cordon 后会显示 SchedulingDisabled,新 Pod 不会调度到该节点;已有 Pod 通常继续运行。若节点本应接收工作负载,确认维护结束后再执行 kubectl uncordon <NODE_NAME>,不要在节点仍不健康时强行恢复调度。
检查污点、标签与亲和性
污点通过 NoSchedule、PreferNoSchedule 或 NoExecute 影响放置与驱逐,Pod 必须有匹配的 toleration 才能通过强制污点。nodeSelector 和 required node affinity 要求节点标签精确匹配;required pod anti-affinity 与严格拓扑分布还可能在节点数量不足时造成无解。
kubectl get node <NODE_NAME> --show-labels
kubectl describe node <NODE_NAME> | sed -n '/Taints:/,/Unschedulable:/p'
kubectl -n shop get pod <POD_NAME> -o yaml
预期结果
节点标签包含工作负载要求的键和值
Taints 与 Pod tolerations 能够匹配
Pod 的 nodeSelector、affinity 和 topologySpreadConstraints 至少存在一个可满足的节点组合
修复时优先调整错误标签、过严约束或容量规划,不要给业务 Pod 添加过宽的 operator: Exists 容忍来绕过所有污点。对于控制面、GPU、隔离租户等专用节点,污点通常是安全边界,不应为解决一次调度失败而永久移除。
检查 kubelet 与容器运行时
若 Pod 已有目标节点,但状态停在 ContainerCreating、Unknown,或节点为 NotReady,应登录该节点检查 kubelet、容器运行时、CNI 和磁盘。先收集日志再重启服务,否则关键错误可能被新的启动日志覆盖。
sudo systemctl status kubelet --no-pager
sudo journalctl -u kubelet --since "15 minutes ago" --no-pager
sudo crictl info
sudo crictl ps -a
预期结果
kubelet 状态为 active (running)
日志中没有持续的证书、cgroup、磁盘、CNI 或 API Server 连接错误
crictl 能连接容器运行时并列出容器
常见根因包括容器运行时未启动、磁盘或 inode 耗尽、节点证书过期、时间偏差、CNI 配置丢失、到 API Server 的网络中断,以及 kubelet 参数与 cgroup 驱动不一致。应针对日志中的第一条稳定错误修复依赖,而不是循环重启 kubelet。
修复并验证调度闭环
故障节点影响业务时,可先 cordon 阻止新 Pod 进入,再根据 PodDisruptionBudget 和工作负载类型决定是否安全驱逐。根因修复后,验证节点 Ready、污点和调度开关符合预期,再观察新的 Pod 是否获得节点并进入 Ready。
kubectl uncordon <NODE_NAME>
kubectl wait --for=condition=Ready node/<NODE_NAME> --timeout=180s
kubectl -n shop get pod <POD_NAME> -w
预期输出
node/<NODE_NAME> uncordoned
node/<NODE_NAME> condition met
<POD_NAME>  1/1  Running  0  <AGE>
实际 Ready 时间、重启次数和 Age 会不同。验证时还应重新查看 Pod Events,确认 FailedScheduling 不再增加,并检查应用探针和服务端点,而不是只看到 Pod 被分配到节点就结束排查。