
容器与云原生 / 系统课时
节点维护与驱逐
节点维护与驱逐
节点维护的目标不是简单关机,而是先阻止新 Pod 调度,再按可用性约束迁移现有工作负载,完成升级或检修后恢复调度。本课给出一套可验证、可回退的标准操作链路。
学习目标
- 区分
cordon、drain与uncordon的职责。 - 按安全顺序暂停调度、驱逐 Pod、执行维护并恢复节点。
- 识别 PDB、本地数据和单副本工作负载导致的驱逐风险。
维护前检查
先确认集群还有其他可调度节点,并且剩余资源足以承载迁移后的 Pod。检查目标节点上的工作负载、PodDisruptionBudget、持久卷和 emptyDir 使用情况;单副本应用应先扩容,否则驱逐可能直接造成服务中断。
cordon 只把节点标记为不可调度,不会移动已经运行的 Pod。drain 会先执行这一标记,再通过 Eviction API 请求驱逐普通 Pod;DaemonSet Pod 通常保留,静态 Pod 或镜像 Pod 也不能按普通工作负载迁移。
标准维护流程
维护链路应按“检查、封锁、驱逐、维护、验收、恢复”顺序执行。驱逐期间,控制器会在其他合适节点重建 Pod;若 PDB 不允许当前中断数量,驱逐会等待或失败,而不是绕过可用性预算。
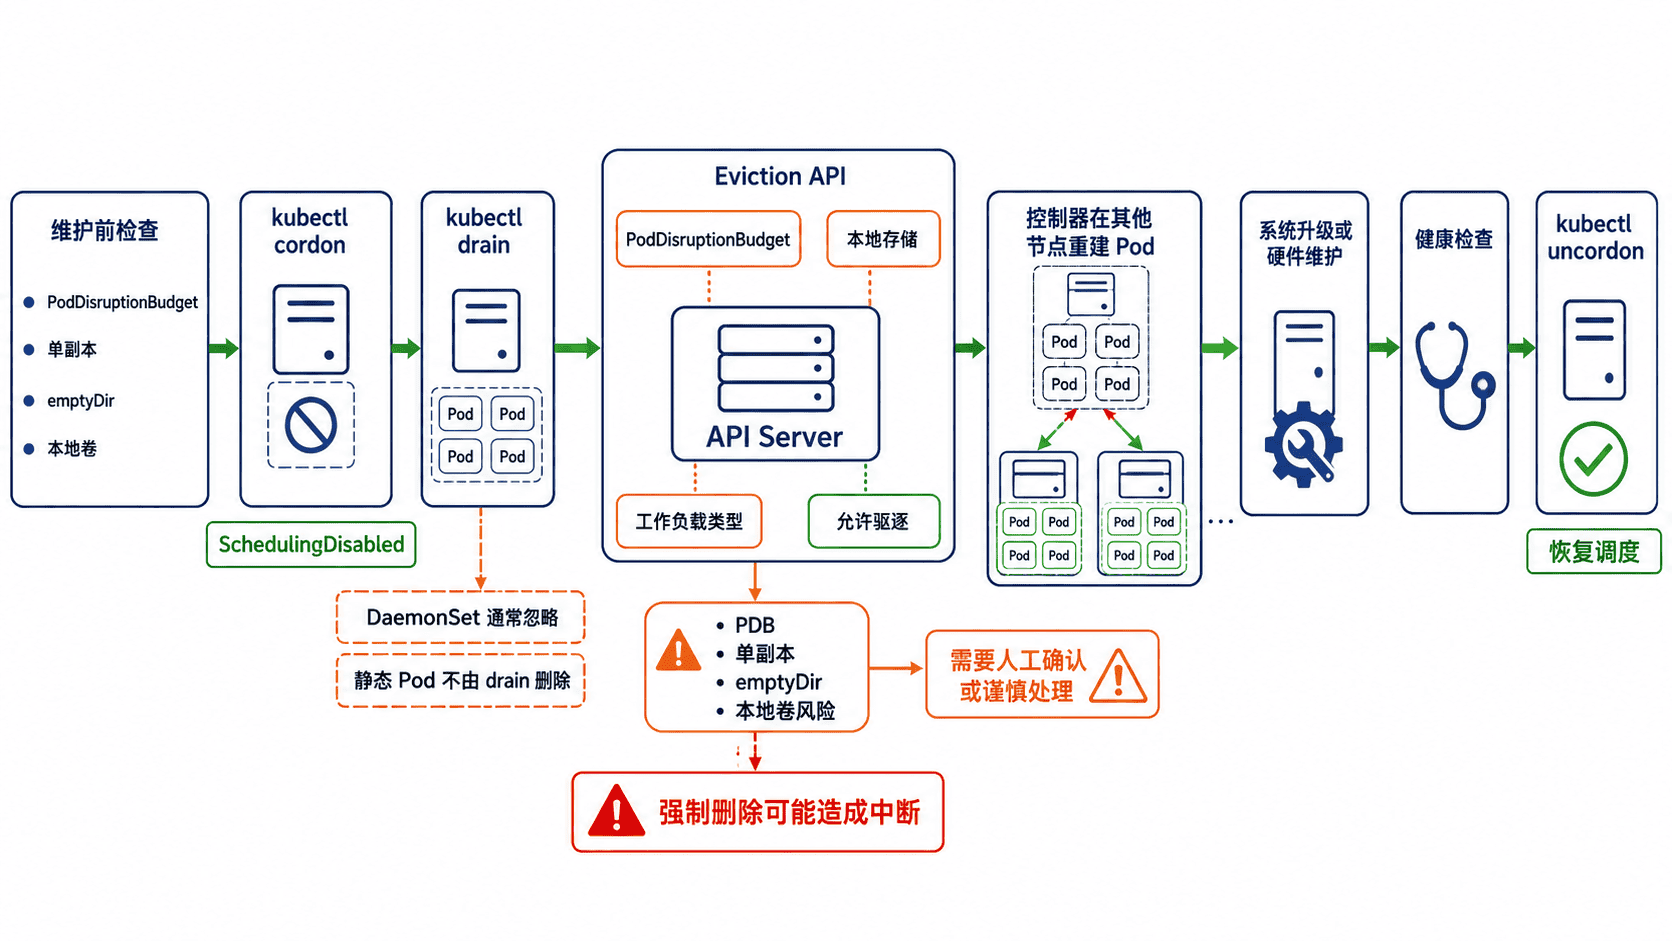
下面示例假设维护工作节点 worker-1。执行前应确认当前 kubectl 上下文,避免操作错误集群。
set -euo pipefail

NODE="worker-1"

kubectl config current-context
kubectl get node "$NODE" -o wide
kubectl get pods -A -o wide --field-selector "spec.nodeName=$NODE"
kubectl get pdb -A

kubectl cordon "$NODE"
kubectl drain "$NODE" --ignore-daemonsets --delete-emptydir-data --grace-period=60 --timeout=10m

# 在此窗口内执行系统补丁、内核升级或硬件维护
kubectl get node "$NODE"
kubectl get pods -A -o wide --field-selector "spec.nodeName=$NODE"

# 仅在节点与关键组件恢复健康后解除调度封锁
kubectl uncordon "$NODE"
kubectl get node "$NODE"
预期输出
<CLUSTER_CONTEXT>
node/worker-1 cordoned
node/worker-1 drained
NAME       STATUS                     ROLES    AGE   VERSION
worker-1   Ready,SchedulingDisabled   <ROLE>   <AGE> <VERSION>
node/worker-1 uncordoned
NAME       STATUS   ROLES    AGE   VERSION
worker-1   Ready    <ROLE>   <AGE> <VERSION>
实际 Pod 名称、版本和时间会不同。--delete-emptydir-data 表示接受被驱逐 Pod 的 emptyDir 数据丢失;如果这些数据不能重建,就不能直接使用该参数。维护窗口内还应观察替代 Pod 是否进入 Ready,而不只看 drain 命令是否结束。
驱逐失败与风险边界
出现 Cannot evict pod as it would violate the pod's disruption budget 时,应先检查 PDB 的 disruptionsAllowed、副本数和未就绪 Pod。通常应修复副本健康或临时扩容,而不是立即添加 --disable-eviction,因为后者会绕过 PDB 并改用删除行为。
出现未受控制器管理的 Pod 时,先确认它是否可以重建,再决定是否使用 --force。控制平面节点、使用本地持久卷的数据库、依赖节点身份的有状态服务,需要单独的维护方案;不要把工作节点命令无差别复制到所有节点。
维护完成后的验收
恢复调度前,确认节点处于 Ready,kubelet、容器运行时和网络插件正常,节点污点、标签与可分配资源没有意外变化。执行 uncordon 后,再创建或等待一个普通工作负载调度到该节点,验证镜像拉取、网络和存储挂载链路。
维护记录至少应包含目标节点、开始与结束时间、驱逐异常、执行变更、验证结果和回退动作。这样下一次维护可以复用经过验证的步骤,而不是依赖临时命令。