
容器与云原生 / 系统课时
Kubernetes 网络模型
Kubernetes 网络模型
本课回答一个核心问题:Pod 为什么能跨节点直接通信,以及谁负责为这种通信准备网卡、地址和路由。学完后,你能读懂集群中的 Pod IP、节点网络与 CNI 之间的分工,并完成一次基本连通性验证。
学习目标
- 说明 Pod、节点与 Service 三类地址各自解决的问题
- 理解 kubelet、容器运行时与 CNI 插件的协作过程
- 使用命令验证 Pod IP 和 Pod 间直接通信
网络模型的四条基本原则
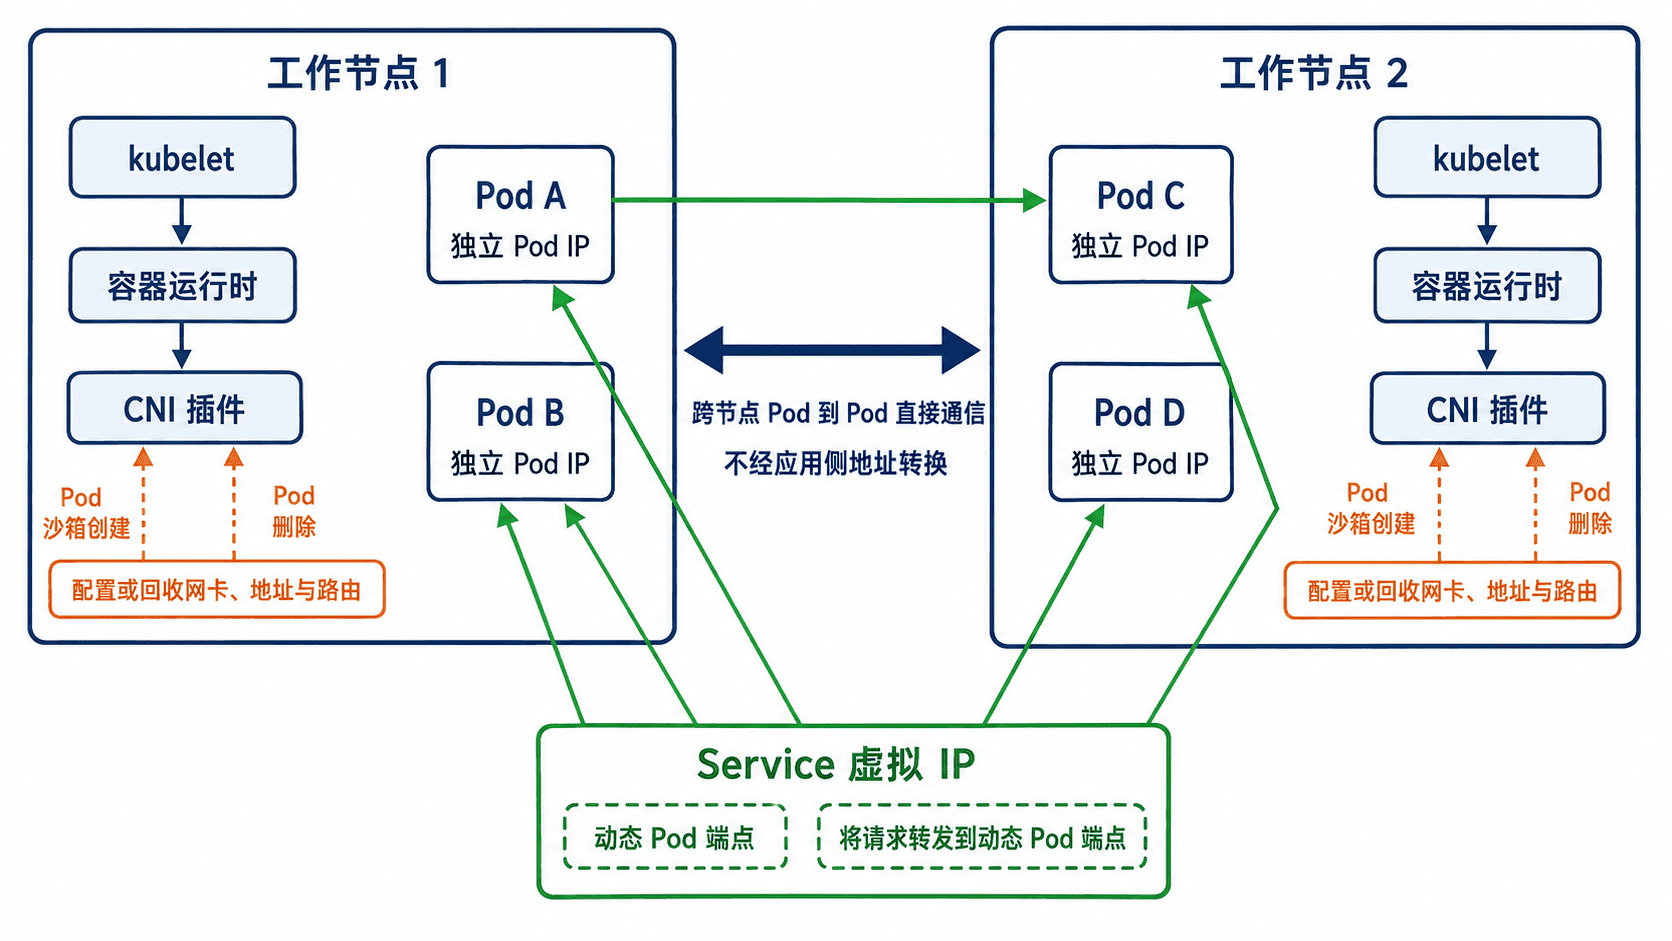
Kubernetes 把 Pod 视为网络中的基本通信单元。每个 Pod 获得一个集群内唯一的 Pod IP,同一 Pod 内的容器共享该网络命名空间,因此它们可以通过 localhost 通信,也必须避免监听同一个端口。
在标准网络模型下,Pod 应能使用对方的 Pod IP 跨节点通信,通信过程不要求应用自行做地址转换;节点上的系统组件也应能访问本节点上的 Pod。至于具体使用路由、隧道、网桥还是 eBPF 数据平面,由网络实现决定。
Service IP 与 Pod IP 的职责不同。Pod IP 标识当前实例,可能随重建而变化;Service 提供稳定的虚拟 IP 和 DNS 名称,再把流量分配给一组健康 Pod。
CNI 如何把原则变成可通信网络
调度器只决定 Pod 运行在哪个节点,不负责配置网络。节点上的 kubelet 创建 Pod 沙箱时,经容器运行时调用 CNI 插件。插件通常完成三件事:为 Pod 创建并接入网络接口、分配 IP 地址、写入必要的路由或数据平面规则。
Pod 删除时,CNI 还要释放地址并清理接口。不同插件的实现差异很大,但对 Kubernetes 暴露的结果一致:Pod 获得可用网络,跨节点路径能够转发数据包。CNI 本身不等于 Service,也不自动代表已启用网络隔离。
动手验证 Pod 间通信
以下命令创建一个 Nginx Pod 和一个带 curl 的客户端 Pod,然后直接访问 Nginx 的 Pod IP。执行前应已有可用集群和默认命名空间权限。
kubectl run net-a --image=nginx:1.27-alpine --restart=Never
kubectl run net-b --image=curlimages/curl:8.10.1 --restart=Never --command -- sleep 3600
kubectl wait --for=condition=Ready pod/net-a pod/net-b --timeout=120s
kubectl get pod net-a net-b -o wide
POD_IP=$(kubectl get pod net-a -o jsonpath='{.status.podIP}')
kubectl exec net-b -- curl -s "http://${POD_IP}" | head -n 1
预期输出
pod/net-a created
pod/net-b created
pod/net-a condition met
pod/net-b condition met
NAME    READY   STATUS    IP           NODE
net-a   1/1     Running   <POD_IP_A>   <NODE_A>
net-b   1/1     Running   <POD_IP_B>   <NODE_B>
<!DOCTYPE html><POD_IP_A>、<POD_IP_B> 和节点名会因环境不同而变化。如果两个 Pod 被调度到不同节点且访问成功,就同时验证了跨节点 Pod 通信;若落在同一节点,也至少验证了 Pod IP 直连路径。
常见误解与边界
Pod IP 通常只在集群网络内有效,不能把它当作稳定的外部访问地址。应用发现后端时应优先使用 Service DNS,而不是缓存 Pod IP。
Kubernetes 网络模型定义连通目标,却不规定唯一实现。看到 cni0、VXLAN、BGP 或 eBPF 等术语时,应把它们理解为不同数据平面方案。默认连通也不等于默认安全隔离;要限制流量,需要使用 NetworkPolicy,并确认所选网络插件支持相应规则。